Tiny LLM
إعادة بناء GPT-2 من الصفر
نموذج لغوي على نمط GPT-2 أعدت بناءه سطرًا بسطر لفهم كيفية عمله
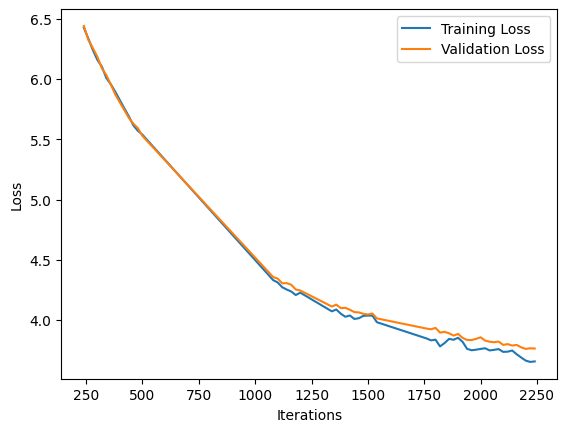
- الخسارة من 6.4 إلى أقل من 4
- Flash Attention + LoRA
التقنيات PyTorchLoRAOpenWebTexttiktoken
 Hugging Face Transformers
 NumPy
 Kaggle
نظرة عامة
النماذج اللغوية الكبيرة (Large Language Models) سهلة الاستدعاء وصعبة الفهم. خلال تدريبي في 3D Smart Factory أردت أن أعرف بالضبط ما يجري داخل GPT-2، فأعدت بناء نموذج على نمط GPT-2 من الصفر في PyTorch مع فريق صغير من زملائي المتدربين.
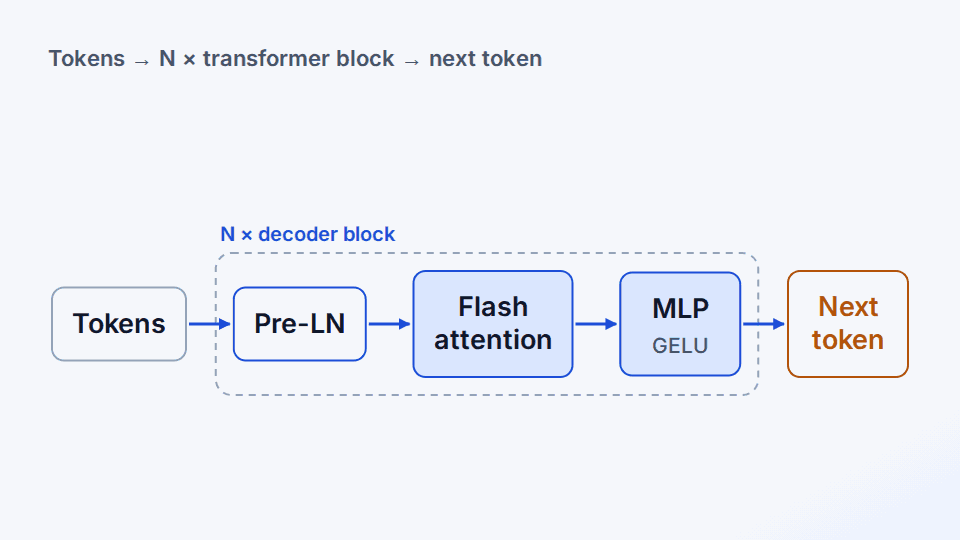
نفّذت الانتباه الذاتي السببي (causal self-attention) يدويًا مع مسار سريع عبر نواة Flash Attention في PyTorch، وكتل مُفكِّك pre-LayerNorm، وتضمينات دخل وخرج مربوطة الأوزان، وطبقات LoRA خاصة بي للضبط الدقيق الموفّر للمعاملات. يستطيع النموذج أيضًا تحميل أوزان GPT-2 الرسمية في البنية نفسها.
قطّعت نحو 5 ملايين ملف من OpenWebText، أي قرابة ربع المدوّنة، بمُقطِّع GPT-2 r50k، ونشرت مجموعة البيانات هذه على Kaggle، ودرّبت النموذج على وحدات GPU في Kaggle. انخفضت خسارتا التدريب والتحقق معًا من نحو 6.4 إلى ما دون 4. إنه مستودعي الأكثر حصولًا على النجوم، وقد بُني للفهم لا لبلوغ حيرة (perplexity) بمستوى أحدث النتائج.
السؤال
هل أستطيع إعادة تنفيذ بنية GPT-2 الداخلية من الصفر مع تحسينات حديثة (Flash Attention وpre-LN) وتدريب نموذج متماسك فعلًا؟
أهم الميزات
- يحسب الانتباه الذاتي السببي عبر scaled_dot_product_attention في PyTorch (أي Flash Attention) ويعود إلى تنفيذ يدوي مقنّع على إصدارات PyTorch الأقدم.
- يستخدم كتل مُفكِّك pre-LayerNorm مع LayerNorm انحيازه اختياري.
- يضيف محوّلات LoRA إلى الطبقات الخطية وطبقات التضمين، مع تجميد الأوزان الأساسية ودمج التحديث منخفض الرتبة بعد التدريب.
- يحمّل أوزان GPT-2 المدرَّبة مسبقًا من Hugging Face، مع توسيع المفردات للرموز الخاصة الجديدة وتهيئة تضميناتها من التوزيع القائم.
- يتدرّب بـ AdamW (دون تناقص الأوزان على الانحيازات وطبقات التطبيع)، مع إحماء خطي ثم تناقص جيب التمام لمعدل التعلم، وتراكم التدرّج، والدقة المختلطة، وقصّ التدرّج.
- يولّد النص بالمعاينة مع درجة الحرارة وtop-k.
كيف يعمل
تحضير البيانات
يُقطَّع نحو ربع OpenWebText بمُقطِّع GPT-2 r50k ويُخزَّن كتدفقات رموز ثنائية ممهّدة في الذاكرة (memory-mapped) للتدريب والتحقق.
تضمين الرموز
تُجمع تضمينات الرموز والمواضع؛ ويتشارك تضمين الرموز أوزانه مع طبقة الخرج.
تكديس كتل المُفكِّك
تطبّق كل كتلة pre-LayerNorm انتباهًا ذاتيًا سببيًا ثم MLP، ولكل منهما وصلة متبقية.
التدريب
إنتروبيا متقاطعة للتنبؤ بالرمز التالي مع AdamW، وإحماء وتناقص لمعدل التعلم، وتراكم التدرّج، ودقة مختلطة على وحدات GPU في Kaggle.
الضبط الدقيق بـ LoRA
تُجمَّد الأوزان الأساسية وتُدرَّب فقط مصفوفات صغيرة منخفضة الرتبة، ثم تُدمج مجددًا في الأوزان.
أمثلة
التقنيات المستخدمة
النموذج ونوى الانتباه وحلقة التدريب
LoRA
محوّلات منخفضة الرتبة مكتوبة يدويًا للضبط الدقيق
OpenWebText
مدوّنة التدريب المسبق، استُخدم نحو ربعها
تقطيع المدوّنة بمُقطِّع GPT-2 r50k
تحميل أوزان GPT-2 الرسمية المدرَّبة مسبقًا
تخزين ثنائي للرموز ممهّد في الذاكرة
التدريب على GPU واستضافة مجموعة البيانات
ما تعلمته
- Flash Attention مكسب فوري على PyTorch ≥ 2.0
- كتابة الانتباه يدويًا أولًا تجعل النواة السريعة أداة لا صندوقًا أسود
الحدود
- تدريب على نطاق صغير؛ الهدف هو الفهم لا بلوغ حيرة (perplexity) بمستوى أحدث النتائج