Tiny LLM
GPT-2 réimplémenté de zéro
Un modèle de langage de type GPT-2 reconstruit ligne par ligne pour comprendre son fonctionnement
- Perte de 6,4 à moins de 4
- Flash Attention + LoRA
Construit avec PyTorchLoRAOpenWebTexttiktoken
 Hugging Face Transformers
 NumPy
 Kaggle
Présentation
Les grands modèles de langage sont faciles à appeler et difficiles à comprendre. Pendant mon stage chez 3D Smart Factory, je voulais savoir exactement ce qui se passe à l'intérieur de GPT-2, alors j'ai reconstruit un modèle de type GPT-2 de zéro en PyTorch avec une petite équipe de stagiaires.
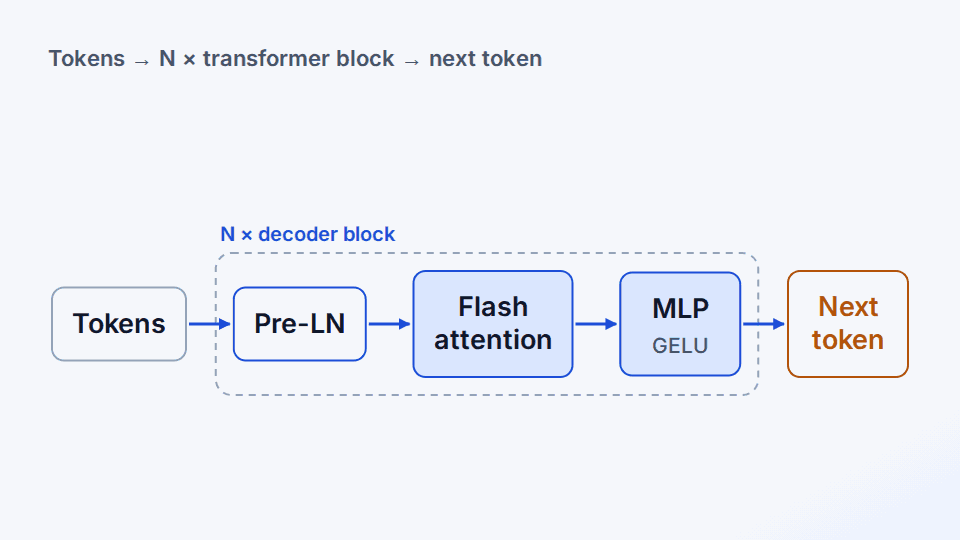
J'ai implémenté l'auto-attention causale à la main avec un chemin rapide via le noyau Flash Attention de PyTorch, des blocs décodeurs pré-LayerNorm, des embeddings d'entrée et de sortie liés, et mes propres couches LoRA pour un fine-tuning économe en paramètres. Le modèle peut aussi charger les poids officiels de GPT-2 dans la même architecture.
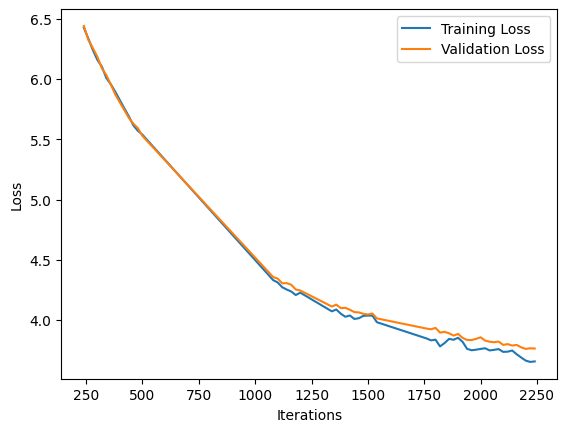
J'ai tokenisé environ 5 millions de fichiers d'OpenWebText, soit à peu près un quart du corpus, avec le tokenizer GPT-2 r50k, publié ce jeu de données sur Kaggle et entraîné le modèle sur les GPU de Kaggle. Les pertes d'entraînement et de validation ont baissé ensemble, d'environ 6.4 à moins de 4. C'est mon dépôt le plus étoilé, et il a été construit pour comprendre, pas pour atteindre une perplexité de l'état de l'art.
La question
Puis-je réimplémenter de zéro les rouages de GPT-2 avec des améliorations modernes (Flash Attention, pré-LN) et entraîner réellement un modèle cohérent ?
Fonctionnalités clés
- Calcule l'auto-attention causale avec scaled_dot_product_attention de PyTorch (Flash Attention) et se replie sur une implémentation masquée manuelle sur les versions plus anciennes de PyTorch.
- Utilise des blocs décodeurs pré-LayerNorm avec un LayerNorm dont le biais est optionnel.
- Ajoute des adaptateurs LoRA aux couches linéaires et d'embedding, en gelant les poids de base et en fusionnant la mise à jour de rang faible après l'entraînement.
- Charge les poids préentraînés de GPT-2 depuis Hugging Face, en redimensionnant le vocabulaire pour les nouveaux tokens spéciaux et en initialisant leurs embeddings à partir de la distribution existante.
- S'entraîne avec AdamW (sans décroissance de poids sur les biais et les normalisations), warmup linéaire puis décroissance cosinus du taux d'apprentissage, accumulation de gradient, précision mixte et écrêtage de gradient.
- Génère du texte par échantillonnage avec température et top-k.
Comment ça marche
Préparer les données
Environ un quart d'OpenWebText est tokenisé avec le tokenizer GPT-2 r50k et stocké sous forme de flux binaires de tokens mappés en mémoire pour l'entraînement et la validation.
Embedder les tokens
Les embeddings de tokens et de positions sont additionnés ; l'embedding de tokens partage ses poids avec la couche de sortie.
Empiler les blocs décodeurs
Chaque bloc pré-LayerNorm applique une auto-attention causale puis un MLP, chacun avec une connexion résiduelle.
Entraîner
Entropie croisée sur le token suivant avec AdamW, warmup et décroissance du taux d'apprentissage, accumulation de gradient et précision mixte sur les GPU de Kaggle.
Affiner avec LoRA
Les poids de base sont gelés et seules de petites matrices de rang faible sont entraînées, puis refusionnées dans les poids.
Exemples
Stack technique
Modèle, noyaux d'attention et boucle d'entraînement
LoRA
Adaptateurs de rang faible écrits à la main pour le fine-tuning
OpenWebText
Corpus de préentraînement, environ un quart utilisé
Tokenisation GPT-2 r50k du corpus
Chargement des poids officiels préentraînés de GPT-2
Stockage binaire des tokens mappé en mémoire
Entraînement sur GPU et hébergement du jeu de données
Ce que j’ai appris
- Flash Attention est un gain immédiat sur PyTorch ≥ 2.0
- Écrire d'abord l'attention à la main fait du noyau rapide un outil, pas une boîte noire
Limites
- Entraînement à petite échelle ; conçu pour comprendre, pas pour atteindre une perplexité de l'état de l'art