Juridia
RAG juridique multilingue
Questions-réponses et recherche rapides sur plus de 100 000 documents juridiques en arabe et en français.
- Latence moyenne < 350 ms
- +18–22 % de précision de recherche
- Plus de 100k documents juridiques
Construit avec FastAPI
 PostgreSQLQdrantLlamaIndex
 ReactBM25 + cross-encoder
Code privé (travail en entreprise / pour un client)
Présentation
Les documents juridiques rédigés à la fois en arabe et en français sont difficiles à bien rechercher : la recherche par mots-clés seule passe à côté de textes pertinents, et les embeddings seuls ne sont pas assez précis pour des questions juridiques.
Chez Juridia, j’ai conçu et déployé un système de génération augmentée par récupération (RAG) en production sur plus de 100 000 documents juridiques, construit avec FastAPI, LlamaIndex, PostgreSQL et Qdrant, avec une interface de recherche proposant la recherche par mots-clés, sémantique et par métadonnées.
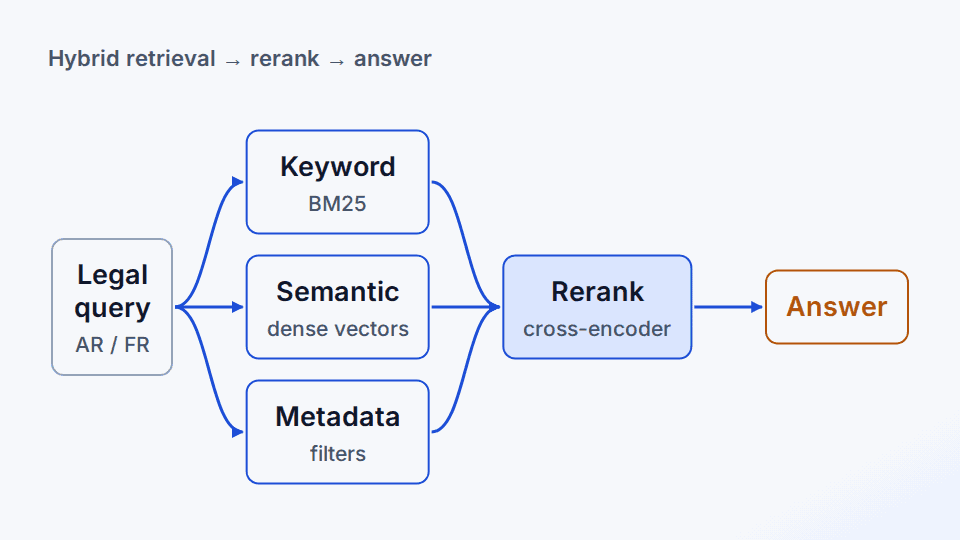
Combiner BM25 avec une recherche dense et des embeddings multilingues, puis reclasser avec un cross-encoder, a amélioré la précision de la recherche de 18 à 22 % tout en maintenant la latence moyenne des requêtes sous les 350 ms. La leçon principale : la qualité de la recherche dépend de l’ensemble du pipeline de classement, pas seulement des embeddings. L’implémentation client est privée ; seul ce résumé technique est donc partagé.
La question
Comment une recherche multilingue peut-elle rester rapide et précise sur un vaste corpus juridique spécialisé ?
Fonctionnalités clés
- Questions-réponses sur plus de 100 000 documents juridiques en arabe et en français.
- Recherche hybride combinant la recherche par mots-clés BM25 et des embeddings denses multilingues.
- Reclassement par cross-encoder, qui a amélioré la précision de la recherche de 18 à 22 %.
- Une interface de recherche avec recherche par mots-clés, sémantique et par métadonnées.
- Latence moyenne des requêtes inférieure à 350 ms en production.
Comment ça marche
Indexer
Les documents sont indexés à la fois pour la recherche par mots-clés et pour la recherche sémantique multilingue, avec PostgreSQL et la base de données vectorielle Qdrant.
Recherche hybride
Une requête est appariée à la fois par recherche BM25 par mots-clés et par recherche sémantique dense, avec des filtres de métadonnées disponibles.
Reclasser
Un cross-encoder réordonne les candidats afin que les passages les plus pertinents arrivent en premier.
Répondre et servir
Les réponses augmentées par récupération sont servies par un service FastAPI construit avec LlamaIndex, derrière l’interface de recherche React.
Stack technique
API de RAG et de recherche en production
Base de données
Base de données vectorielle pour les embeddings multilingues
Framework RAG
Interface de recherche
BM25 + cross-encoder
Recherche hybride par mots-clés et reclassement
Ce que j’ai appris
- La qualité de la recherche dépend de l’ensemble du pipeline de classement, pas seulement des embeddings
Limites
- L’implémentation client est privée ; seul un résumé technique au niveau du portfolio est partagé