Bilingual Net
Traduction anglais ↔ darija
Un traducteur neuronal écrit de zéro entre l'anglais et la darija marocaine.
- 5 stratégies de décodage
Construit avec PyTorch
 Hugging Face Transformers
 Streamlit
 Poetry
Présentation
La darija marocaine est parlée par des millions de personnes mais dispose de très peu de textes parallèles, si bien que la plupart des outils de traduction la gèrent mal. Je voulais savoir si un Transformer que j'aurais écrit moi-même, de bout en bout, pouvait apprendre des traductions exploitables à partir d'un petit corpus anglais–darija.
J'ai construit BIALinguaNet en PyTorch : un Transformer encodeur–décodeur complet avec des blocs d'attention résiduels pré-LayerNorm, une perte à lissage d'étiquettes et un décodeur qui prend en charge la température, le top-k, le top-p, la recherche en faisceau et la normalisation par la longueur. J'ai entraîné un checkpoint par direction (darija vers anglais et anglais vers darija) et intégré les deux dans une application Streamlit qui affiche des hypothèses de traduction classées.
Écrire chaque pièce moi-même — masquage, batching, décodage — m'a montré à quel point la qualité finale de la sortie dépend des choix de décodage plutôt que du réseau seul, surtout sur une langue à faibles ressources.
La question
Un Transformer seq2seq écrit de zéro peut-il traduire entre l'anglais et la darija marocaine, un dialecte à faibles ressources, avec une qualité exploitable ?
Fonctionnalités clés
- Traduit dans les deux sens, avec un checkpoint entraîné séparément pour darija vers anglais et anglais vers darija.
- Transformer encodeur–décodeur écrit de zéro, avec une attention multi-têtes résiduelle qui sert à la fois d'auto-attention et d'attention croisée.
- Décodage réglable à l'inférence : température, top-k, top-p, taille du faisceau et coefficient de normalisation par la longueur.
- Renvoie plusieurs hypothèses alternatives avec leurs scores au lieu d'une seule réponse.
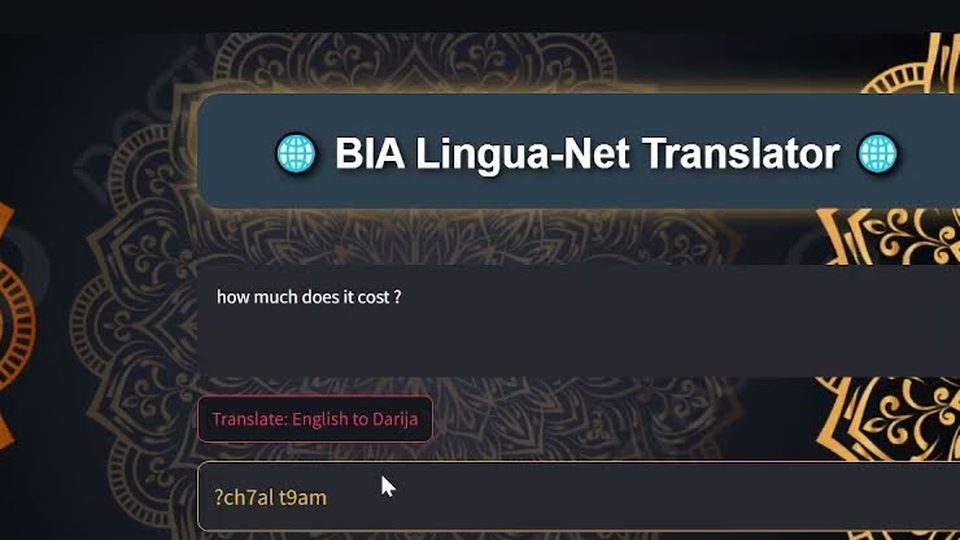
- Interface Streamlit de traduction en temps réel qui affiche l'entrée à côté de la sortie.
- Scripts d'entraînement et de fine-tuning séparés, avec des dépendances gérées par Poetry.
Comment ça marche
Tokeniser et regrouper en lots
Les paires de phrases sont tokenisées avec un tokenizer GPT-2 étendu avec des tokens de padding, de début et de fin. Les lots sont regroupés par longueur de séquence sous un budget de tokens fixe, afin de gaspiller peu de calcul en padding.
Encoder la source
L'encodeur applique des blocs résiduels pré-LayerNorm d'auto-attention et de feed-forward sur la phrase source, en masquant les positions de padding.
Décoder avec attention croisée
Le décodeur applique une auto-attention masquée causalement, puis une attention croisée sur la sortie de l'encodeur. Ses embeddings de tokens et sa projection de sortie partagent leurs poids avec l'embedding de l'encodeur.
Entraîner avec lissage d'étiquettes
L'entraînement utilise une entropie croisée à lissage d'étiquettes, Adam avec une planification du taux d'apprentissage à warmup, et l'écrêtage de gradient.
Chercher la meilleure traduction
À l'inférence, la recherche en faisceau combinée à l'échantillonnage top-k/top-p et à la normalisation par la longueur produit des hypothèses classées, et la meilleure est affichée en premier.
Exemples

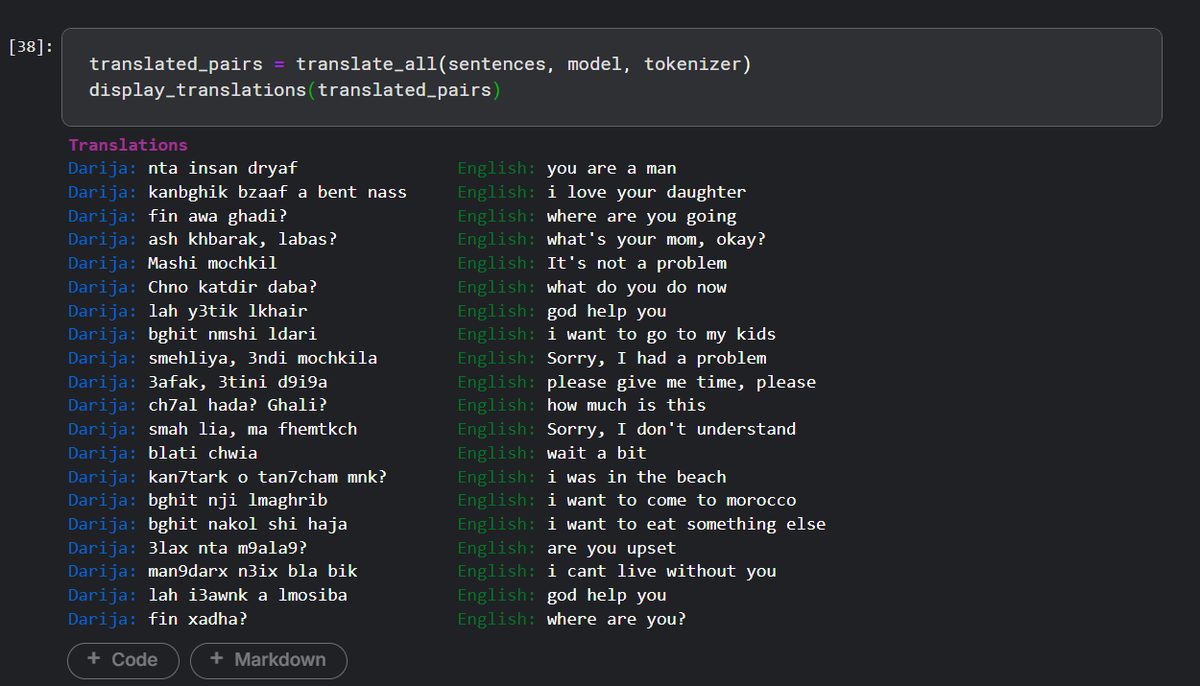
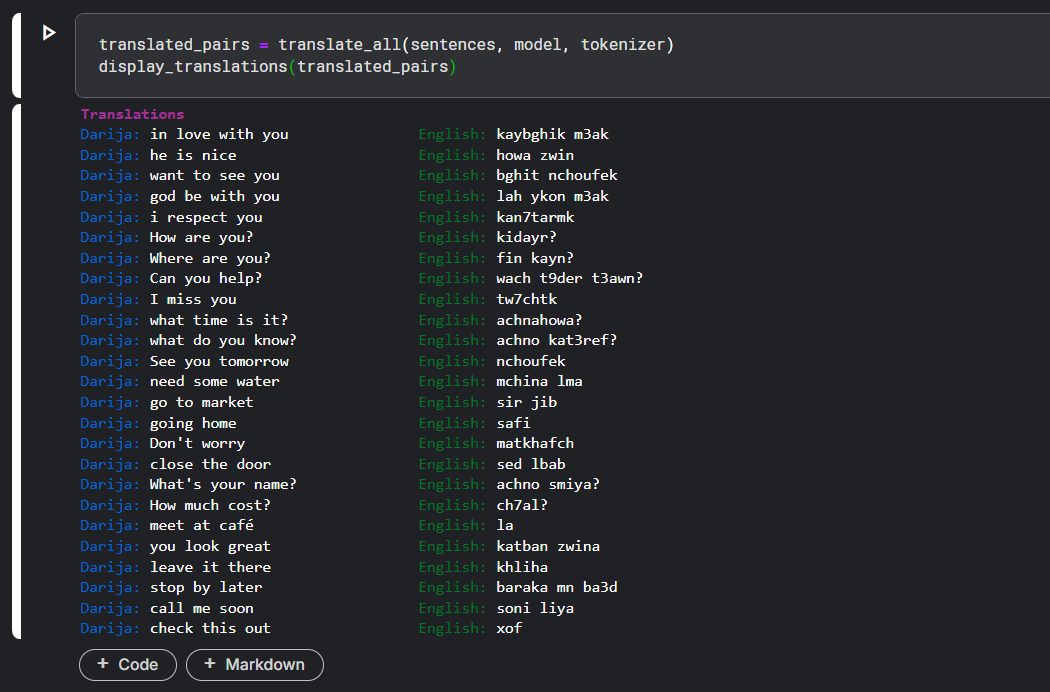
Entrée
bghit nji lmaghrib
Sortie
i want to come to morocco
Stack technique
Transformer encodeur–décodeur, entraînement et recherche en faisceau
Tokenizer GPT-2 avec tokens spéciaux ajoutés
Application de traduction interactive avec hypothèses classées
Gestion des dépendances et de l'environnement
Ce que j’ai appris
- La stratégie de décodage compte autant que le modèle pour la qualité finale de la sortie
- Le lissage d'étiquettes freine l'excès de confiance — surtout sur une langue à faibles ressources
Limites
- Données parallèles limitées pour la darija ; la qualité est bornée par le corpus