Text Classification
كشف المشاعر بشبكات RNN وLSTM وGRU
اثنا عشر نموذجاً تكرارياً يقرأ الجملة ويسمّي مشاعرها، أُعيد بناؤها من دفترين معطوبين في حزمة واحدة مختبَرة.
- دقة 92.3%
- مقارنة 12 نموذجًا
- إصلاح 13 خطأ
التقنيات PyTorchGloVeNLTK
 PandasMatplotlib
 pytest
نظرة عامة
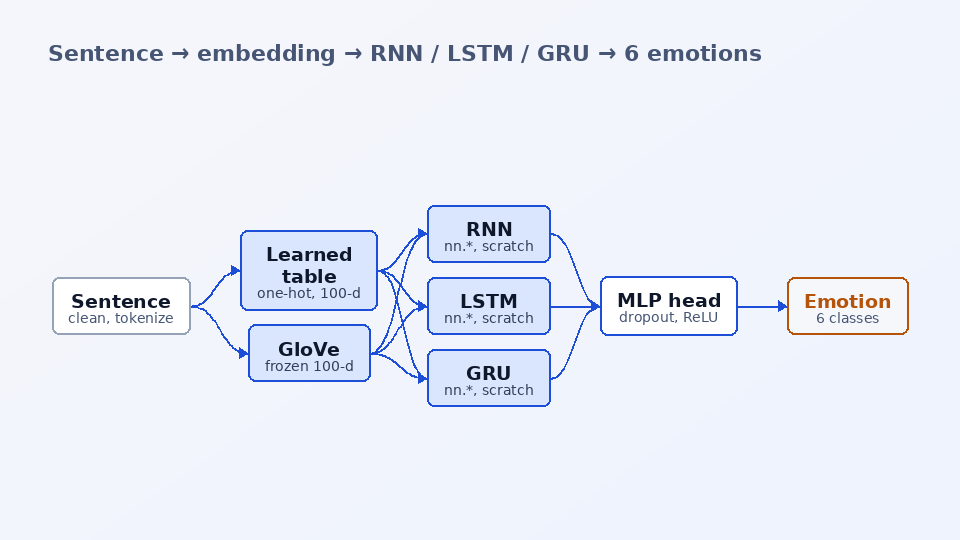
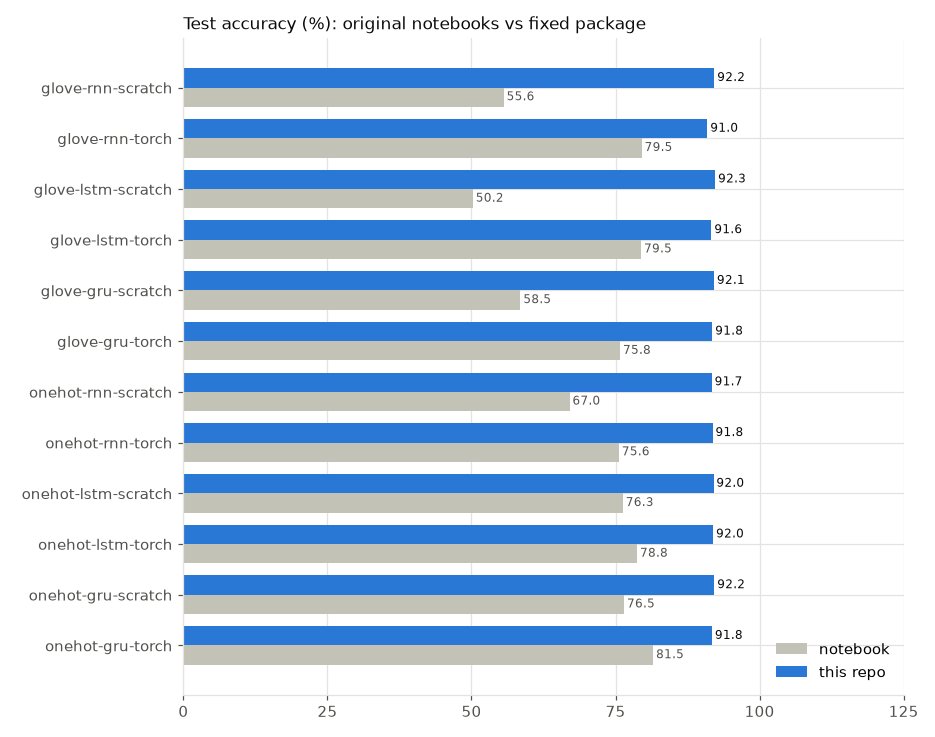
بدأ هذا المشروع كدفتري Colab يصنّفان جملاً إنجليزية إلى ست مشاعر بنماذج RNN وLSTM وGRU. بلغت الدفاتر دقة اختبار بين 50 و81.5% ولم أثق بالأرقام. أعدت بناءها كحزمة Python بوصفة تدريب واحدة مشتركة واكتشفت السبب: الخلايا المبنية من الصفر لم تكن تكرارية، والحشو (padding) كان يتسرب إلى التنبؤ، ومعادلة GRU كانت خاطئة، والتقييم كان متفائلاً.
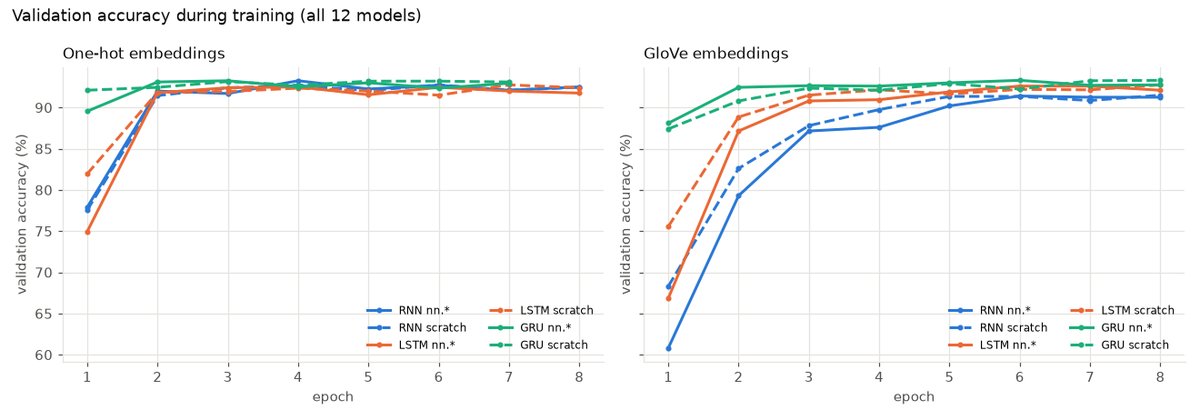
تحتفظ الحزمة بأفكار الدفاتر: ثلاثة أنواع من الخلايا، كل منها مبني مرتين (بوحدات nn.RNN / nn.LSTM / nn.GRU ومن الصفر)، تُغذّى إما بجدول تضمين (embedding) متعلَّم على نص مردود إلى جذوره (lemmatised) أو بمتجهات GloVe مجمَّدة ببُعد 100 على النص الخام. ينتج عن ذلك 12 نموذجاً، كلها بطبقتين وثنائية الاتجاه برأس MLP نفسه، مدرَّبة حتى 8 حقب على CPU مع إيقاف مبكر على دقة التحقق، على مجموعة بيانات dair-ai/emotion (16,000 تدريب / 2,000 تحقق / 2,000 اختبار).
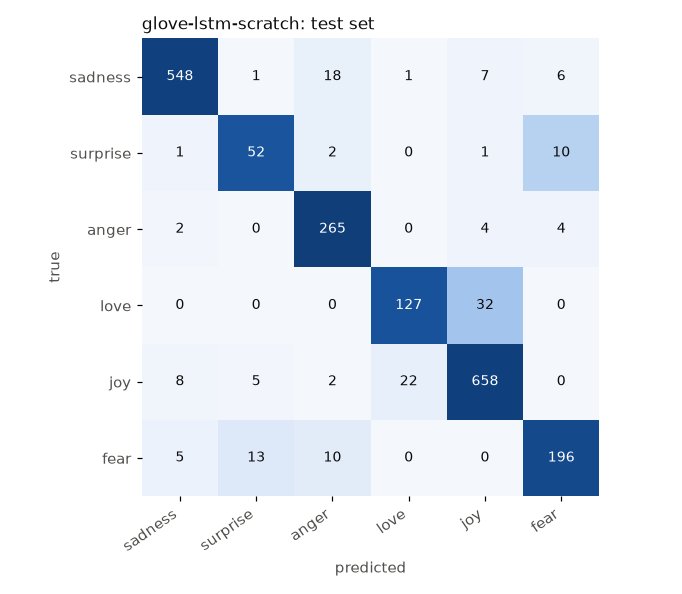
كل نموذج يستقر الآن عند دقة اختبار بين 91 و92% مع F1 كلي (macro F1) بين 0.87 و0.88؛ وأفضلها glove-lstm-scratch عند 92.3%. الخلايا المبنية من الصفر تطابق خلايا PyTorch عددياً، وهو ما تثبته الاختبارات بنسخ أوزان PyTorch إليها. الأخطاء المتبقية في الفئات المتقاربة: love تُحسب joy، وsurprise تُحسب fear.
السؤال
لماذا تراوحت دقة دفاتري الأصلية بين 50% و81.5% على المهمة نفسها، وهل يبقى لنوع الخلية والتضمين أثر بعد تصحيح خط المعالجة (pipeline)؟
أهم الميزات
- خلايا RNN وLSTM وGRU مكتوبة من الصفر وفق معادلات PyTorch، مع اختبارات تُظهر أنها تعطي الأرقام نفسها تماماً كما تعطيها nn.RNN / nn.LSTM / nn.GRU.
- تضمينان: جدول متعلَّم (طبقة Linear أحادية الترميز من الدفاتر، منفذة بالفهرسة) ومتجهات GloVe مجمَّدة ببُعد 100 مقصورة على الكلمات الموجودة في المدونة.
- حشو صحيح: متتاليات مرزومة (packed) لخلايا torch، وقناع طول لخلايا الصفر، واختبار يتحقق من أن الحشو الإضافي لا يغير شيئاً في النماذج الـ12 كلها.
- وصفة واحدة لكل نموذج: AdamW، وتنعيم التسميات (label smoothing)، وقصّ التدرج، ومعدل تعلم متناقص، وإيقاف مبكر، وتقييم أفضل نقطة حفظ على مجموعة الاختبار الكاملة بالدقة وF1 الكلي.
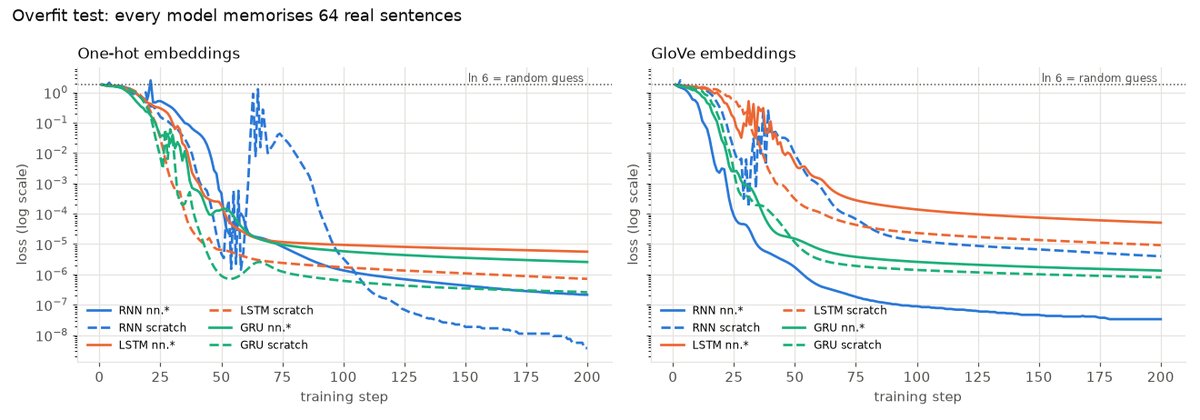
- فحوص سلامة على البيانات الحقيقية: الخسارة عند التهيئة تساوي ln 6، ودفعة واحدة من 64 جملة تُحفظ، والنموذج يتفوق بوضوح على نسخة معمّاة بمدخل ممحو.
- واجهتا سطر أوامر، textcls-train وtextcls-predict، إضافة إلى سكربتات تدرّب النماذج الـ12 كلها وتعيد توليد صفحة النتائج بالمنحنيات ومصفوفات الالتباس.
كيف يعمل
تنظيف النص
تحويل إلى أحرف صغيرة والاحتفاظ بالحروف والأرقام وعلامات الترقيم الأساسية؛ تحذف تشغيلات one-hot أيضاً الكلمات النادرة وكلمات التوقف (مع الاحتفاظ بأدوات النفي) وتردّ الكلمات إلى جذورها بـ NLTK، بينما تستخدم تشغيلات GloVe الكلمات الخام.
التضمين
معرّفات الرموز تفهرس جدولاً متعلَّماً بحجم 3,100 x 100، أو متجهات GloVe مجمَّدة بصف صفري للحشو والمتجه المتوسط للكلمات المجهولة.
قراءة الجملة
شبكة RNN أو LSTM أو GRU ثنائية الاتجاه بطبقتين تمر على الرموز؛ والحالة عند آخر رمز حقيقي في كل اتجاه هي ملخص الجملة.
التصنيف
Dropout، ورأس Linear-ReLU-Linear، وsoftmax بست مخرجات، مدرَّبة بإنتروبيا متقاطعة بتنعيم التسميات.
التحقق قبل الثقة
فرط تخصيص دفعة حقيقية واحدة، ومقارنة مع نموذج معمّى، والتأكد من وصول التدرجات إلى كل موتّر (tensor)، ثم التدريب حتى 8 حقب والاحتفاظ بأفضل حقبة تحقق.
أمثلة
المدخل
textcls-predict --checkpoint checkpoints/glove-lstm-scratch/best.pt "i didnt feel humiliated" "i feel amazing today, everything went right"
المخرج
sadness 0.98 (anger 0.01, fear 0.00) <- i didnt feel humiliated surprise 0.88 (joy 0.10, fear 0.01) <- i feel amazing today, everything went right
التقنيات المستخدمة
النماذج والخلايا المبنية من الصفر وحلقة التدريب
متجهات كلمات مجمَّدة ببُعد 100 مدرَّبة على 6B رمز
كلمات التوقف والردّ إلى الجذور لتشغيلات one-hot
قراءة أقسام مجموعة البيانات بصيغة parquet
منحنيات التدريب ومصفوفات الالتباس ومخطط المقارنة
اختبارات وحدات: تطابق الخلايا مع PyTorch، وثبات الحشو، والمقاييس
ما تعلمته
- في الجمل القصيرة الغنية بالكلمات المفتاحية، يهم ضبط التكرار والحشو والتقييم أكثر بكثير من اختيار الخلية أو التضمين
- خسارة تبدأ عند ln(classes)، واختبار فرط تخصيص (overfit) على دفعة واحدة، وخط أساس بمدخل معمّى: ثلاثة أمور تكشف معظم أخطاء خط المعالجة قبل أي تدريب طويل
الحدود
- الفئات النادرة (surprise بنسبة 3.6%، وlove) لها أدنى F1؛ وترجيح الفئات، والتجميع بالانتباه (attention pooling)، وخط أساس Transformer ما زالت على خارطة الطريق
- أرقام الدفاتر ليست خط أساس قابلاً للمقارنة المباشرة: فقد استخدمت مجموعة اختبار مرشَّحة وتوقفت عند هدف اختير يدوياً
الكلمات المفتاحية
تصنيف النصوص · كشف المشاعر · تحليل المشاعر · RNN · LSTM · GRU · الشبكات العصبية التكرارية · من الصفر · RNN ثنائي الاتجاه · GloVe · تضمينات الكلمات · تضمين one-hot · NLP · dair-ai/emotion · macro F1 · مصفوفة الالتباس · PyTorch · NLTK · اختبار فرط التخصيص · فحوص السلامة