Text Classification
Détection d’émotions avec des RNN, LSTM et GRU
Douze modèles récurrents qui lisent une phrase et nomment son émotion, reconstruits à partir de deux notebooks cassés en un seul package testé.
- 92,3 % de précision
- 12 modèles comparés
- 13 bugs corrigés
Construit avec PyTorchGloVeNLTK
 PandasMatplotlib
 pytest
Présentation
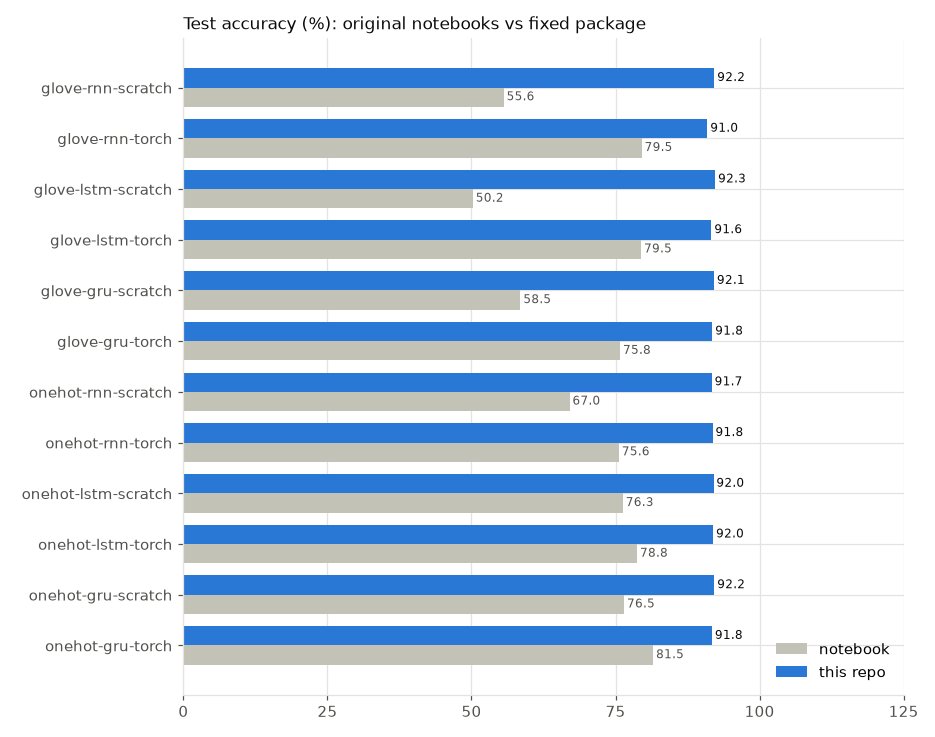
Ce projet a commencé comme deux notebooks Colab qui classaient des phrases anglaises en six émotions avec des modèles RNN, LSTM et GRU. Les notebooks atteignaient 50 à 81,5 % de précision en test et je ne faisais pas confiance à ces chiffres. Je les ai reconstruits sous forme de package Python avec une seule recette d’entraînement partagée et j’ai compris pourquoi : les cellules from scratch n’étaient pas récurrentes, le padding fuyait dans la prédiction, l’équation du GRU était fausse et l’évaluation était optimiste.
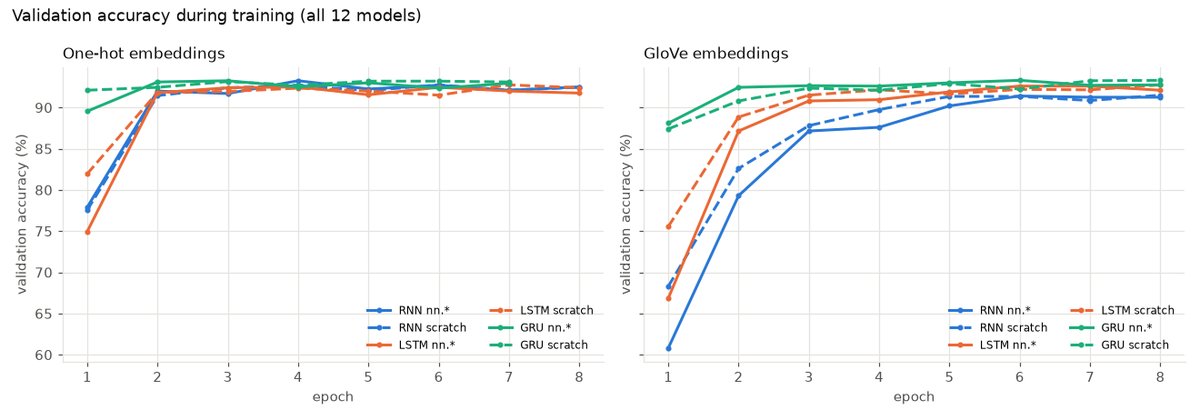
Le package conserve les idées des notebooks : trois types de cellules, chacune construite deux fois (avec nn.RNN / nn.LSTM / nn.GRU et from scratch), alimentées soit par une table d’embedding apprise sur du texte lemmatisé, soit par des vecteurs GloVe 100-d gelés sur du texte brut. Cela fait 12 modèles, tous à deux couches et bidirectionnels avec la même tête MLP, entraînés jusqu’à 8 époques sur CPU avec arrêt précoce sur la précision de validation, sur le jeu de données dair-ai/emotion (16 000 entraînement / 2 000 validation / 2 000 test).
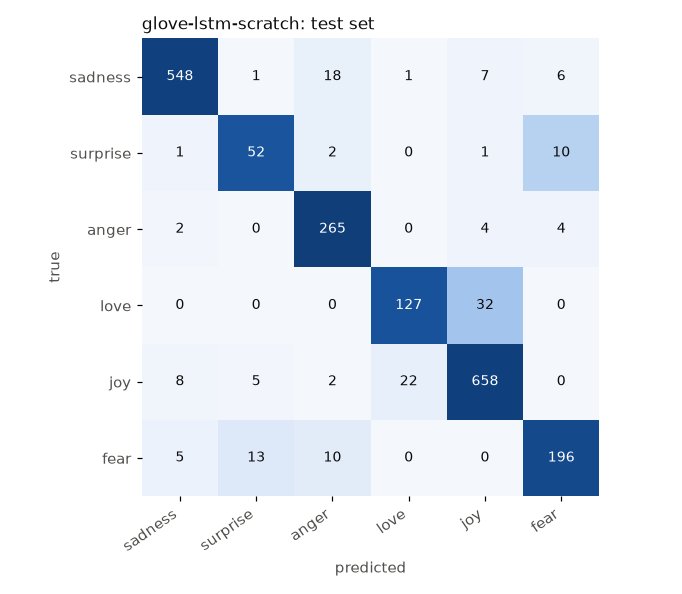
Chaque modèle atteint désormais 91 à 92 % de précision en test avec un F1 macro de 0,87 à 0,88 ; le meilleur est glove-lstm-scratch à 92,3 %. Les cellules from scratch coïncident numériquement avec celles de PyTorch, ce que les tests prouvent en y copiant les poids de PyTorch. Les erreurs restantes concernent les classes proches : love pris pour joy, surprise pris pour fear.
La question
Pourquoi mes notebooks d’origine allaient-ils de 50 % à 81,5 % de précision sur la même tâche, et le type de cellule et l’embedding comptent-ils encore une fois le pipeline corrigé ?
Fonctionnalités clés
- Cellules RNN, LSTM et GRU écrites from scratch selon les équations de PyTorch, avec des tests qui montrent qu’elles donnent exactement les mêmes nombres que nn.RNN / nn.LSTM / nn.GRU.
- Deux embeddings : une table apprise (le Linear one-hot des notebooks, réalisé par indexation) et des vecteurs GloVe 100-d gelés restreints aux mots présents dans le corpus.
- Un padding correct : séquences packées pour les cellules torch, masque de longueur pour les cellules scratch, et un test vérifiant qu’un padding supplémentaire ne change rien pour les 12 modèles.
- Une seule recette pour tous les modèles : AdamW, label smoothing, écrêtage du gradient, taux d’apprentissage décroissant, arrêt précoce, et le meilleur checkpoint noté sur le jeu de test complet avec la précision et le F1 macro.
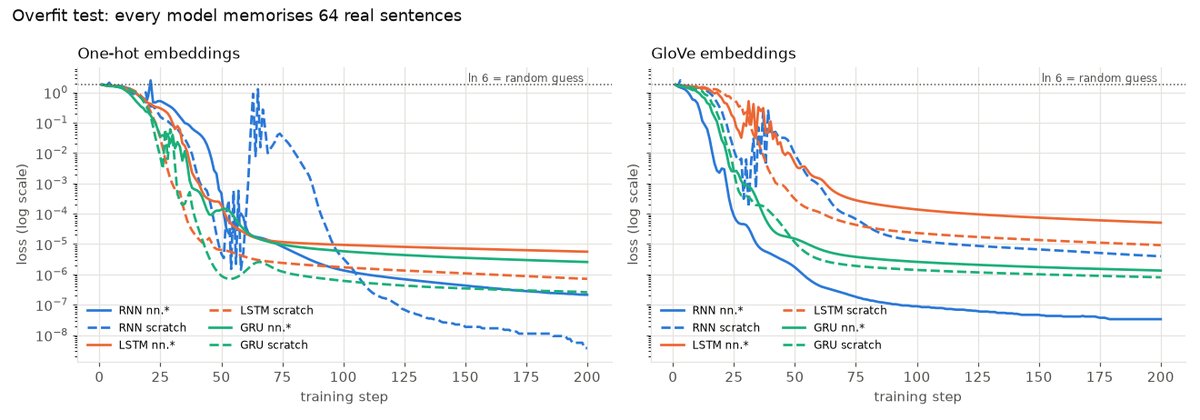
- Vérifications de cohérence sur les données réelles : la perte à l’initialisation vaut ln 6, un batch de 64 phrases est mémorisé, et le modèle bat nettement une copie aveugle à entrée effacée.
- Deux CLI, textcls-train et textcls-predict, plus des scripts qui entraînent les 12 modèles et régénèrent la page de résultats avec courbes et matrices de confusion.
Comment ça marche
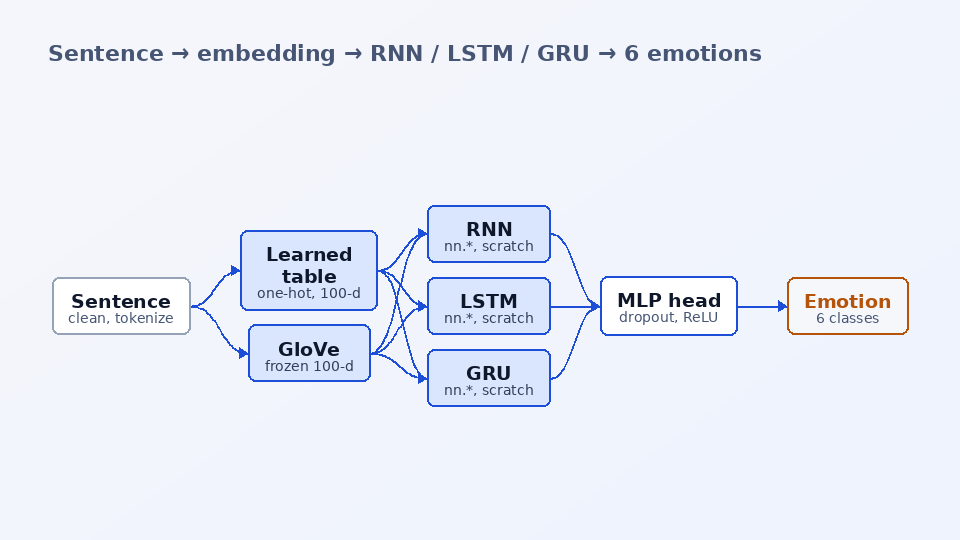
Nettoyer le texte
Passage en minuscules et conservation des lettres, chiffres et ponctuation de base ; les runs one-hot retirent aussi les mots rares et les stop words (en gardant les négations) et lemmatisent avec NLTK, tandis que les runs GloVe utilisent les mots bruts.
Plonger
Les identifiants de tokens indexent une table apprise de 3 100 x 100, ou des vecteurs GloVe gelés avec une ligne nulle pour le padding et le vecteur moyen pour les mots inconnus.
Lire la phrase
Un RNN, LSTM ou GRU bidirectionnel à deux couches parcourt les tokens ; l’état au dernier token réel de chaque direction est le résumé de la phrase.
Classer
Dropout, une tête Linear-ReLU-Linear et un softmax à six sorties, entraînés avec une entropie croisée à label smoothing.
Vérifier avant de croire
Surapprendre un batch réel, comparer avec un modèle aveugle, vérifier que les gradients atteignent chaque tenseur, puis entraîner jusqu’à 8 époques et garder la meilleure époque de validation.
Exemples
Entrée
textcls-predict --checkpoint checkpoints/glove-lstm-scratch/best.pt "i didnt feel humiliated" "i feel amazing today, everything went right"
Sortie
sadness 0.98 (anger 0.01, fear 0.00) <- i didnt feel humiliated surprise 0.88 (joy 0.10, fear 0.01) <- i feel amazing today, everything went right
Stack technique
Les modèles, les cellules from scratch et la boucle d’entraînement
Vecteurs de mots 100-d gelés, entraînés sur 6B de tokens
Stop words et lemmatisation pour les runs one-hot
Lecture des partitions parquet du jeu de données
Courbes d’entraînement, matrices de confusion et graphique comparatif
Tests unitaires : parité des cellules avec PyTorch, invariance au padding, métriques
Ce que j’ai appris
- Sur des phrases courtes et riches en mots-clés, soigner la récurrence, le padding et l’évaluation compte bien plus que le choix de la cellule ou de l’embedding
- Une perte qui démarre à ln(classes), un test de surapprentissage sur un batch et une baseline à entrée masquée attrapent la plupart des bugs du pipeline avant un long entraînement
Limites
- Les classes rares (surprise à 3,6 %, love) ont le F1 le plus bas ; la pondération des classes, le pooling par attention et une baseline Transformer restent sur la feuille de route
- Les chiffres des notebooks ne sont pas une baseline comparable : ils utilisaient un jeu de test filtré et s’arrêtaient à une cible choisie à la main
Mots-clés
classification de texte · détection d’émotions · analyse de sentiments · RNN · LSTM · GRU · réseaux de neurones récurrents · from scratch · RNN bidirectionnel · GloVe · embeddings de mots · embedding one-hot · NLP · dair-ai/emotion · F1 macro · matrice de confusion · PyTorch · NLTK · test de surapprentissage · vérifications de cohérence