HR-Jev
GPT-2 pour la prédiction d'indicateurs RH
Un modèle GPT-2 qui lit des profils d'employés et prédit quatre indicateurs RH.
- 4 têtes de tâche sur GPT-2
Construit avec PyTorch
 Hugging Face Transformers
 pandas
 TensorBoard
 Gradio
 pytest
Présentation
Les données RH vivent généralement dans des tables, et les tables sont généralement traitées par des modèles tabulaires classiques. Je voulais tester une autre voie : transformer chaque dossier d'employé en une phrase en anglais courant et laisser un Transformer GPT-2 apprendre à partir de là.
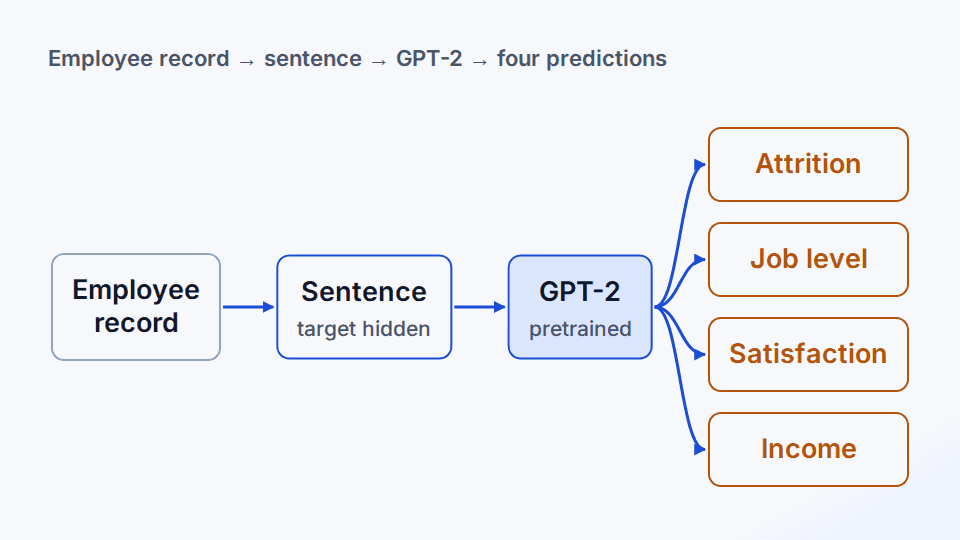
J'ai écrit moi-même l'architecture GPT-2 en PyTorch, j'y ai chargé les poids GPT-2 pré-entraînés et j'ai ajouté quatre têtes de tâche par-dessus : attrition (binaire), niveau de poste (5 classes), satisfaction au travail (4 classes) et revenu mensuel (régression). Pour chaque tâche, l'attribut cible est retiré de la phrase et le modèle le prédit à partir de l'état caché du dernier token.
Le projet couvre tout le workflow : nettoyage et découpage des données, batching par tranches de longueur, journalisation TensorBoard, suite pytest, rapports de métriques de test sauvegardés et une application Gradio interactive pour essayer des profils individuels.
La question
Un Transformer GPT-2 peut-il apprendre des données RH tabulaires si chaque dossier d'employé est réécrit sous la forme d'une phrase en anglais courant ?
Fonctionnalités clés
- Sérialise chaque dossier d'employé en une phrase anglaise à ordre fixe, du type "The employee is 30 years old, ..., travels rarely for work, ...".
- Backbone GPT-2 écrit de zéro (auto-attention causale, feed-forward GELU, LayerNorm) initialisé à partir des poids GPT-2 pré-entraînés.
- Quatre têtes spécifiques aux tâches, trois de classification et une de régression, toutes entraînées conjointement sur un seul backbone partagé.
- Pipeline de données qui nettoie les données, encode les cibles et sauvegarde des splits 80/10/10 reproductibles avec des statistiques par split.
- Entraînement avec AdamW, clipping des gradients et lissage des labels, journalisé dans TensorBoard avec des checkpoints périodiques.
- Application Gradio qui charge un échantillon de test ou accepte des champs modifiés et prédit les quatre indicateurs.
Comment ça marche
Nettoyer et découper
La table RH brute est normalisée, les colonnes constantes supprimées, les cibles encodées, et les lignes découpées en 80/10/10 avec une graine fixe.
Des dossiers aux phrases
Chaque dossier devient un échantillon d'entraînement par tâche : l'attribut cible est retiré, et les attributs restants sont rédigés en une phrase anglaise puis tokenisés avec le tokenizer GPT-2.
Backbone Transformer partagé
Un décodeur de type GPT-2, chargé avec les poids GPT-2 pré-entraînés, encode la phrase. L'attention étant causale, l'état caché du dernier token résume l'ensemble du profil.
Têtes de tâche
Le vecteur du dernier token est envoyé à la tête correspondant à la tâche de l'échantillon, classifieur ou régresseur. La classification utilise une entropie croisée avec lissage des labels et la régression une perte smooth-L1 mise à l'échelle.
Évaluer et servir
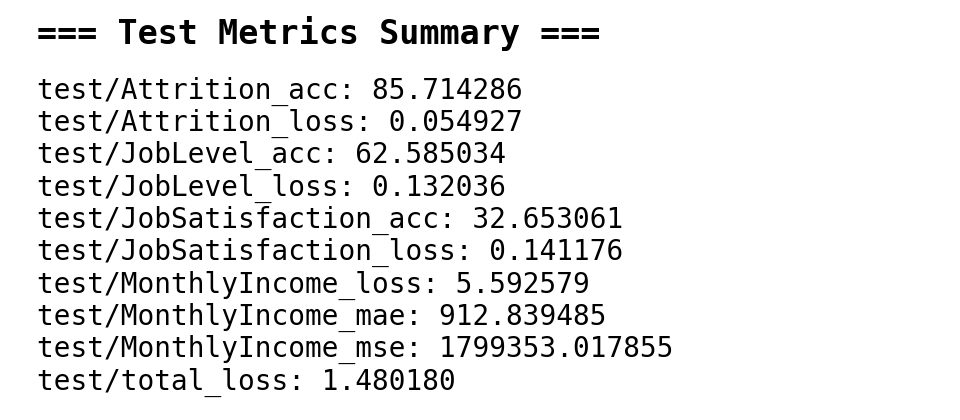
Un script de test rapporte la précision, la MAE et la MSE par tâche sur le split mis de côté, et l'application Gradio sert le meilleur checkpoint.
Exemples
Entrée
Age 30, business travel: rarely, department: research & development, overtime: no (other attributes omitted)
Sortie
The employee is 30 years old, ..., travels rarely for work, ..., works in the research & development department, ..., does not work overtime, ...
Stack technique
Backbone GPT-2, têtes de tâche et boucle d'entraînement
Tokenizer GPT-2 et poids pré-entraînés
Nettoyage, encodage et découpage des données RH
Suivi des pertes d'entraînement et des statistiques de gradients
Application de prédiction interactive
Tests du tokenizer, du chargeur de batchs et du modèle
Ce que j’ai appris
- Réécrire des tables sous forme de texte permet à un seul backbone de modèle de langage de servir plusieurs tâches de prédiction
Limites
- Jeu de données RH restreint ; certaines tâches (p. ex. la satisfaction au travail) restent difficiles à prédire