Image-to-CadQuery
Modèle vision-vers-code sur mesure
Un réseau de neurones qui transforme l’image d’une pièce 3D en code
Construit avec PyTorchResNet18Transformer
 Hugging Face Datasets
 pytesttorchvisionHugging Face Transformerstorchrun
 Ruff
Code privé (travail en entreprise / pour un client)
Présentation
CadQuery est une bibliothèque Python qui décrit des pièces 3D sous forme de code. Je voulais savoir si un modèle entraîné uniquement à partir de données pouvait regarder le rendu d’une pièce de CAO et écrire le script CadQuery qui la reconstruit, sans API de LLM ni ingénierie de prompt.
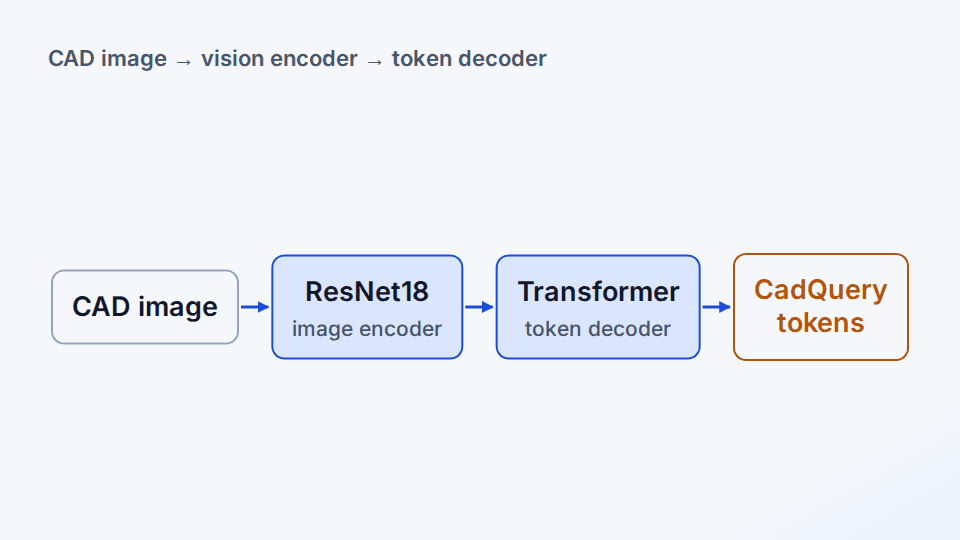
J’ai construit un modèle encodeur-décodeur en PyTorch pur : un ResNet18 transforme l’image en une grille 7x7 de tokens visuels, et un décodeur Transformer à 6 couches écrit le script token par token en portant son attention sur ces tokens d’image. Autour, j’ai écrit une configuration typée, un pipeline de données pour le jeu de données GenCAD-Code (147k paires image/script d’entraînement), une boucle d’entraînement qui passe d’un CPU de portable à plusieurs GPU et plusieurs machines, une CLI d’inférence et une suite de tests pytest exécutable sur CPU uniquement.
Le pipeline est vérifié de bout en bout : lors d’un test de sur-apprentissage sur des données réelles, le modèle a mémorisé 8 échantillons et régénéré leurs scripts presque à l’identique. Un entraînement complet sur GPU et l’évaluation du code généré (taux de syntaxe valide et IoU par rapport au solide de référence) constituent la prochaine étape.
La question
Un encodeur ResNet conçu sur mesure et un décodeur Transformer autorégressif peuvent-ils apprendre à traduire directement des images de CAO en programmes CadQuery éditables ?
Fonctionnalités clés
- Traduit un rendu 224x224 d’une pièce de CAO en script Python CadQuery exécutable.
- Conserve 49 tokens d’image spatiaux afin que le décodeur puisse regarder différentes zones de l’image pour différentes lignes de code.
- S’entraîne sur CPU, sur un GPU, sur plusieurs GPU ou sur plusieurs machines avec DDP, avec précision mixte, accumulation de gradient et checkpoints reprenables.
- Génère du code depuis la ligne de commande ou depuis Python, par décodage glouton ou par échantillonnage avec température et top-k.
- Fournit une suite de tests hors ligne, CPU uniquement, qui vérifie la causalité, le padding, le masquage de la fonction de perte, le rechargement des checkpoints et le fait que deux processus DDP terminent avec des poids identiques.
Comment ça marche
Préparer les données
Chaque rendu GenCAD-Code est redimensionné en 224x224 et normalisé ; chaque script est tokenisé avec le BPE de GPT-2 et encadré par BOS, code, EOS, avec un token de padding dédié pour que le modèle apprenne quand même à s’arrêter.
Encoder l’image
Un ResNet18 sans pooling produit une grille de caractéristiques 7x7, aplatie en 49 tokens d’image dotés de positions 2D apprises.
Décoder le code
Un décodeur Transformer pre-norm à 6 couches applique une auto-attention masquée sur le code déjà écrit et une attention croisée sur les tokens d’image, avec une couche de sortie liée à l’embedding des tokens.
Entraîner
Entropie croisée sur le token suivant avec teacher forcing, AdamW avec des taux d’apprentissage distincts pour l’encodeur et le décodeur, montée linéaire puis décroissance cosinus, et écrêtage du gradient.
Générer
L’image est encodée une seule fois, puis le décodeur ajoute un token à la fois jusqu’à ce que chaque séquence émette EOS ou atteigne la limite de tokens.
Exemples
Entrée
Overfit sanity check: 8 real GenCAD-Code samples, 26.4M-parameter model, 150 steps on a laptop CPU (about 15 minutes)
Sortie
Validation loss fell from 10.64 to 0.06; reloading the checkpoint and generating from the 8 training images reproduced the scripts at 98-100% token accuracy (4 of 8 exactly).
Stack technique
Modèle, boucle d’entraînement, DDP et précision mixte
ResNet18
Encodeur d’image produisant une grille de caractéristiques 7x7
Transformer
Décodeur autorégressif avec attention croisée sur l’image
Chargement des paires image/script GenCAD-Code
Tests hors ligne sur CPU pour les données, le modèle et l’entraînement
Backbone ResNet18 et transformations d’image
Tokenizer BPE de GPT-2 pour le code CadQuery
Lancement de l’entraînement multi-GPU et multi-nœuds
Vérifications de linting et de formatage
Ce que j’ai appris
- La traduction vision-vers-code exige que les caractéristiques spatiales restent accessibles à chaque étape du décodage
- Une base de référence en sur-apprentissage sur un échantillon minuscule est le bon garde-fou avant un entraînement coûteux sur le jeu de données complet
Limites
- L’entraînement, la génération des checkpoints et l’évaluation VSR/IoU constituent la prochaine étape
- Le dépôt est actuellement privé