CartPole RL
Douze méthodes de RL sur un même benchmark
Toutes les méthodes classiques d'apprentissage par renforcement, d'une table Q à PPO et aux CNN sur pixels, équilibrant le même pendule sous la même évaluation.
- 12 méthodes résolvent CartPole
- PPO résolu en 15k pas
- Table Q : résolu en 4 s
Construit avec PyTorchGymnasium
 NumPyMatplotlib
 pytest
Présentation
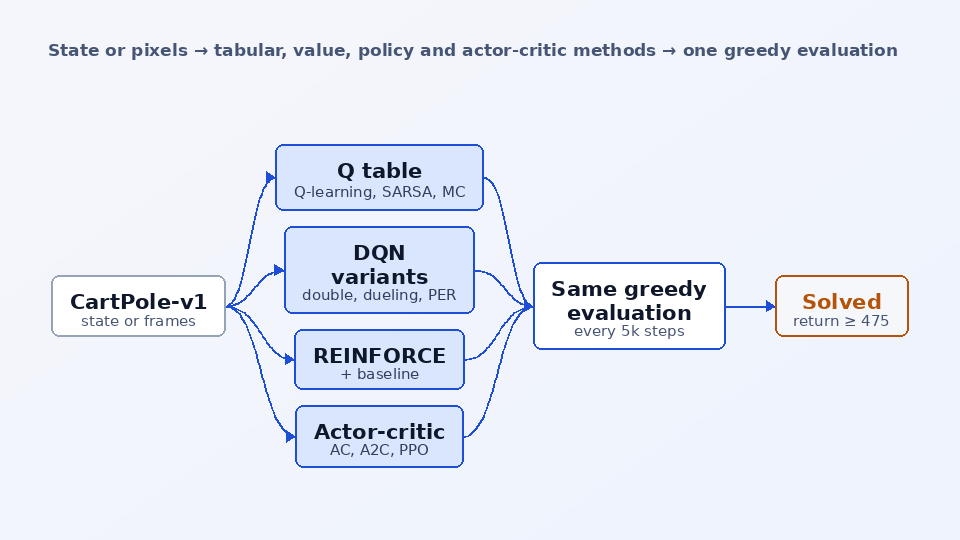
CartPole est la tâche de contrôle la plus simple de Gymnasium : pousser un chariot à gauche ou à droite pour que le pendule reste debout, un point par pas, 500 pas au maximum. Je m'en suis servi comme banc d'essai pour implémenter moi-même toutes les méthodes classiques d'apprentissage par renforcement et voir comment chacune y parvient réellement : Q-learning tabulaire, SARSA et contrôle Monte Carlo sur un état discrétisé, DQN avec ses variantes double, dueling, à replay priorisé et n-step, REINFORCE avec et sans baseline, acteur-critique à un pas, A2C et PPO, et enfin des politiques CNN qui ne voient que des images rendues.
Tout partage un même environnement, un même Recorder qui compte les pas et lance une évaluation gloutonne tous les 5 000 pas, une même définition de « résolu » (un candidat à >= 475 sur 10 épisodes, confirmé sur 100 épisodes supplémentaires) et les mêmes graphiques. Chaque règle de mise à jour tient en quelques lignes à côté d'un commentaire qui explique pourquoi elle est là, et 53 tests vérifient les briques (reward-to-go, GAE à lambda 0 et 1, la cible du double DQN, la tête dueling, le clip de PPO) contre des valeurs calculées à la main.
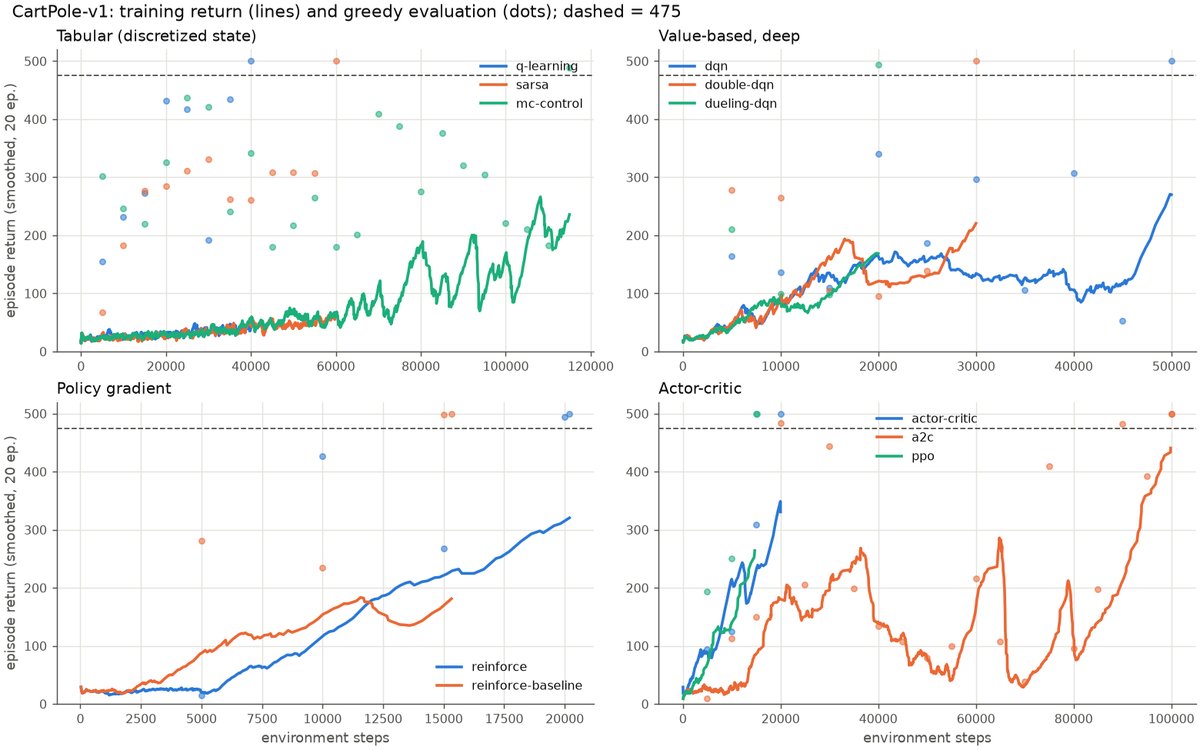
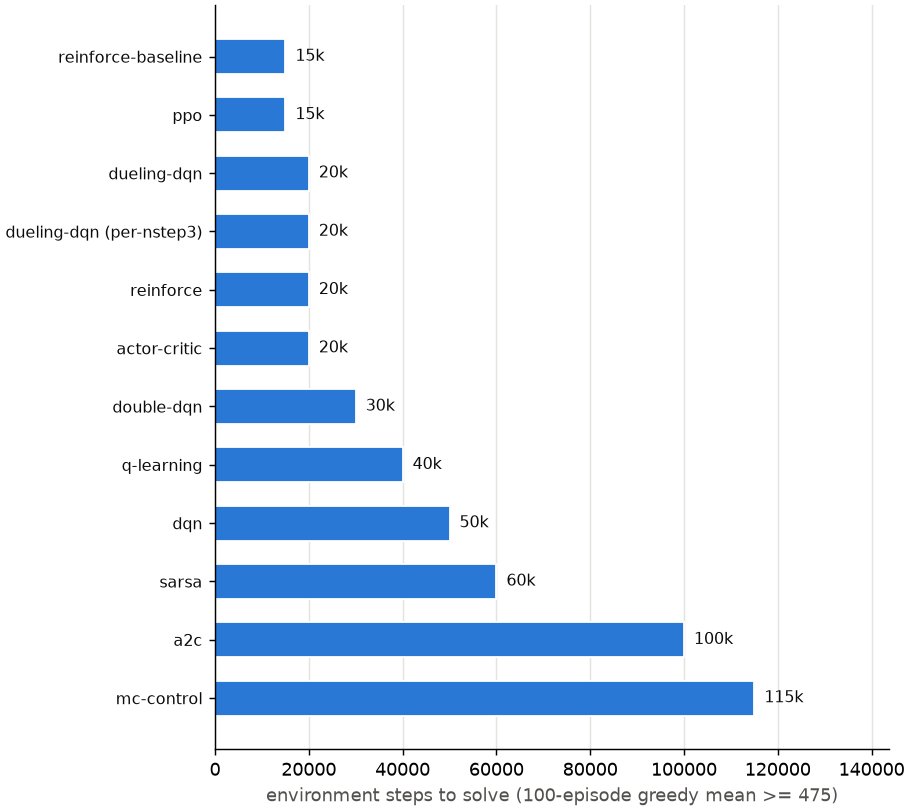
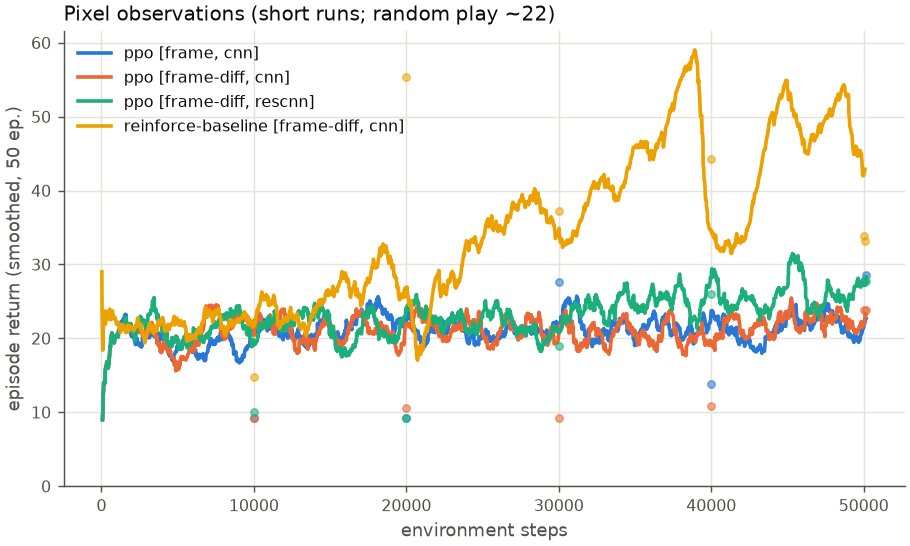
Sur les observations d'état, les douze méthodes résolvent la tâche. PPO et REINFORCE + baseline y parviennent après 15 000 pas, le Q-learning tabulaire après 40 000 pas mais seulement 4 secondes de CPU, et le DQN simple après 50 000 pas avec un long plateau que les variantes double et dueling ne montrent pas. Les runs sur pixels sont la partie honnête : 50 000 pas CPU sont loin d'être suffisants, et seuls les agents sur différences d'images dépassent tant soit peu le jeu aléatoire.
La question
Si chaque méthode classique de RL tourne sur le même environnement avec la même évaluation gloutonne, que révèle chaque courbe d'apprentissage sur la raison d'être de ses ingrédients (replay, réseaux cibles, baselines, clipping) ?
Fonctionnalités clés
- Douze méthodes derrière un seul flag
--method: q-learning, sarsa, mc-control, dqn, double-dqn, dueling-dqn (plus--prioritizedet--n-step), reinforce, reinforce-baseline, actor-critic, a2c et ppo. - Trois modes d'observation : l'état à 4 nombres, une image rendue en gris de 40x80, ou l'image plus sa différence avec la précédente, avec des corps MLP, CNN et CNN résiduel.
- Un seul Recorder pour toutes les méthodes : comptage des pas, évaluation gloutonne périodique sur des états de départ fixes, résolution confirmée, et restauration des meilleurs poids évalués à la fin.
- Troncature gérée correctement partout : la limite de temps de 500 pas bootstrappe depuis V(s') tandis qu'un pendule tombé utilise 0.
cartpole-compareentraîne n'importe quel ensemble de méthodes et produit le tableau des résultats, les courbes de retour et le graphique des pas jusqu'à résolution ;cartpole-playenregistre des GIF avant/après sur le même état de départ.- 53 tests pytest (environ 40 s sur un thread CPU) couvrant les règles de mise à jour, les wrappers d'environnement, les réseaux, les allers-retours de checkpoints et les CLI.
- Un notebook Kaggle/Colab qui explique chaque famille avant de l'entraîner et répète la comparaison sur trois graines, plus les notebooks de cours d'origine avec un tableau des 15 bugs qui y ont été trouvés.
Comment ça marche
Un MDP, trois façons de le voir
CartPole-v1 donne +1 par pas jusqu'à ce que le pendule penche de plus de 12 degrés, que le chariot sorte de la piste ou que 500 pas s'écoulent. Les agents voient l'état brut, une image rendue recadrée, ou l'image avec son image de différence ; les méthodes tabulaires discrétisent l'état en 1 x 6 x 12 x 12 = 864 cellules.
TD tabulaire et Monte Carlo
Une table 864 x 2 est mise à jour avec la cible Q-learning r + gamma max Q(s', .), la cible SARSA qui utilise l'action réellement prise ensuite, ou le vrai retour de l'épisode pour le contrôle Monte Carlo, avec epsilon décroissant de 1.0 à 0.02.
Méthodes de valeur profondes
Un réseau Q 4-128-128-2 s'entraîne sur un buffer de replay avec un réseau cible moyenné par Polyak et une perte de Huber. Des flags activent la cible double (le réseau en ligne choisit a', le réseau cible l'évalue), la tête dueling Q = V + A - mean A, le replay priorisé avec poids d'importance, et les retours n-step.
Gradient de politique et acteur-critique
REINFORCE pousse log pi(a|s) vers le haut, pondéré par le reward-to-go normalisé, éventuellement moins une baseline apprise V(s). L'acteur-critique à un pas utilise l'erreur TD comme avantage après chaque pas ; A2C fait avancer 8 environnements de 8 pas et effectue un seul pas combiné acteur, critique et entropie.
PPO
8 environnements x 32 pas par rollout, avantages GAE (gamma 0.98, lambda 0.8), puis 20 époques sur le batch avec le ratio de probabilités clippé dans [0.8, 1.2] pour que des mises à jour répétées ne puissent pas éloigner la politique de celle qui a collecté les données.
La même évaluation pour tous
Tous les 5 000 pas, la politique gloutonne joue 10 états de départ fixes ; une moyenne >= 475 est confirmée sur 100 épisodes supplémentaires, et le premier point confirmé donne les pas, les épisodes et les secondes jusqu'à résolution. Une évaluation finale sur 100 épisodes avec des états de départ jamais vus remplit le tableau.
Exemples
Entrée
cartpole-train --method ppo --record ppo.gif
Sortie
[ppo/state] step 15000 ep 183 train(last20) 264.0 eval 500.0 +- 0.0 22.0s confirm(100) 498.1
Stack technique
Réseaux Q, politiques, corps CNN et chaque règle de mise à jour
CartPole-v1 avec rendu pygame pour les modes pixels
Tables Q, buffers de replay et discrétiseur d'état
Courbes de retour et graphiques des pas jusqu'à résolution
53 tests des règles de mise à jour, de l'environnement, des réseaux et des CLI
Ce que j’ai appris
- Une seule image rendue ne porte aucune information de vitesse, donc un agent sur pixels à une seule image reste au niveau du hasard ; ajouter la différence d'images comme second canal est ce qui lui permet enfin de progresser
- Le retour d'entraînement d'A2C s'est effondré trois fois avant de se stabiliser, exactement l'échec que le ratio clippé de PPO a été conçu pour éviter : PPO résout en 15 000 pas avec le même réseau
Limites
- Une seule graine par méthode et des runs courts : des méthodes qui résolvent à un ou deux intervalles d'évaluation de 5 000 pas l'une de l'autre peuvent échanger leur ordre avec une autre graine
- Les runs sur pixels font 50 000 pas sur un CPU et aucun n'approche de la résolution ; le notebook les prolonge à 200 000 pas
Mots-clés
apprentissage par renforcement · CartPole · Gymnasium · Q-learning · SARSA · contrôle Monte Carlo · DQN · double DQN · dueling DQN · replay d'expérience priorisé · REINFORCE · acteur-critique · A2C · PPO · PyTorch