CartPole RL
اثنتا عشرة طريقة للتعلم المعزز على معيار واحد
كل طرق التعلم المعزز الكلاسيكية، من جدول Q إلى PPO وشبكات CNN على البكسلات، توازن العمود نفسه تحت التقييم نفسه.
- 12 طريقة تحل CartPole
- PPO يحلها في 15k خطوة
- جدول Q يحلها في 4 ثوانٍ
التقنيات PyTorchGymnasium
 NumPyMatplotlib
 pytest
نظرة عامة
CartPole هي أبسط مهمة تحكم في Gymnasium: ادفع عربة يمينًا أو يسارًا ليبقى العمود قائمًا، نقطة واحدة لكل خطوة، و500 خطوة كحد أقصى. استخدمتها منصة اختبار لأنفّذ بنفسي كل طرق التعلم المعزز (Reinforcement Learning) الكلاسيكية وأرى كيف تصل كل منها فعليًا إلى الحل: Q-learning الجدولي وSARSA وتحكم Monte Carlo على حالة مقسَّمة إلى خانات، وDQN بمتغيراته المزدوج (double) والمبارز (dueling) وإعادة التشغيل ذات الأولوية وn-step، وREINFORCE مع خط أساس (baseline) ومن دونه، والممثل-الناقد (actor-critic) بخطوة واحدة، وA2C وPPO، وأخيرًا سياسات CNN لا ترى سوى الإطارات المرسومة.
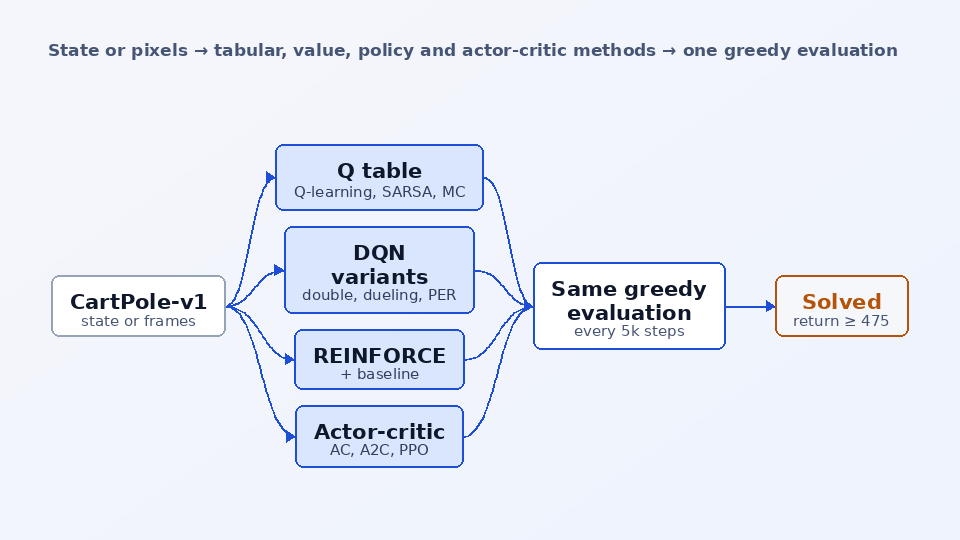
كل شيء يتشارك بيئة واحدة، وأداة Recorder واحدة تعدّ الخطوات وتجري تقييمًا جشعًا كل 5,000 خطوة، وتعريفًا واحدًا للحل (مرشَّح على 10 حلقات بمتوسط >= 475 يُؤكَّد على 100 حلقة إضافية)، والرسوم البيانية نفسها. كل قاعدة تحديث بضعة أسطر بجانب تعليق يشرح سبب وجودها، و53 اختبارًا تتحقق من القطع (reward-to-go، وGAE عند lambda 0 و1، وهدف double DQN، ورأس dueling، وقصّ PPO) مقابل أرقام محسوبة يدويًا.
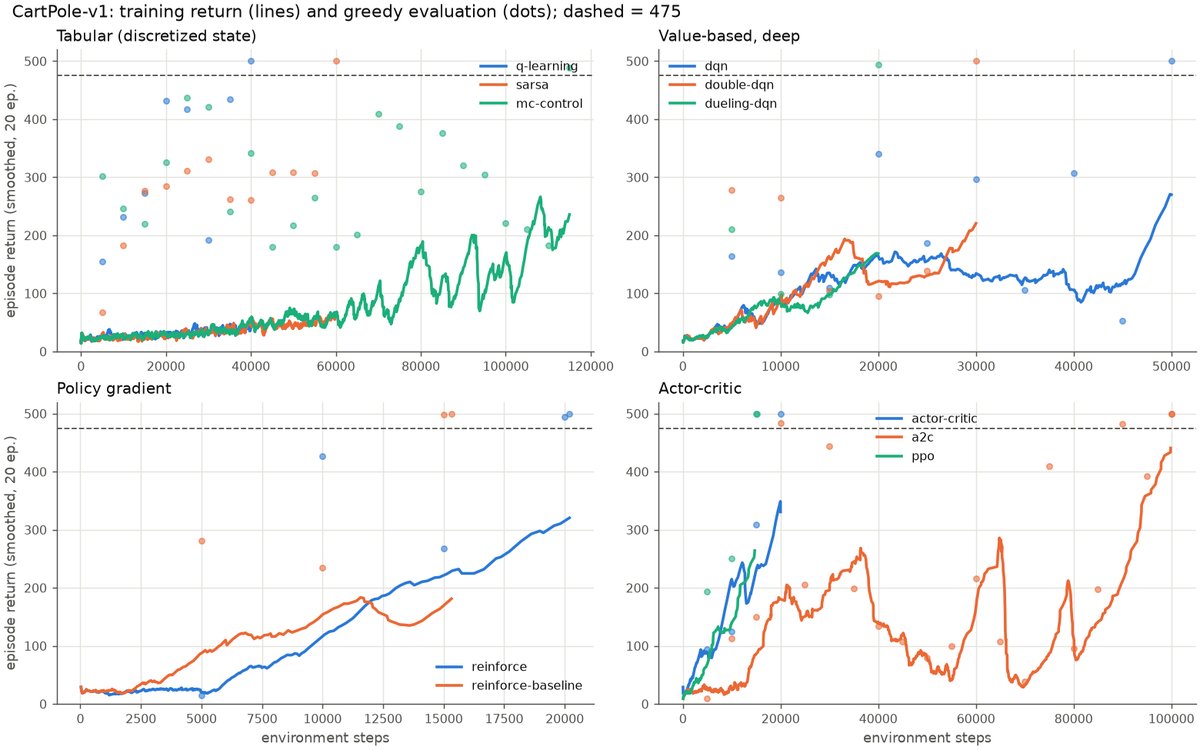
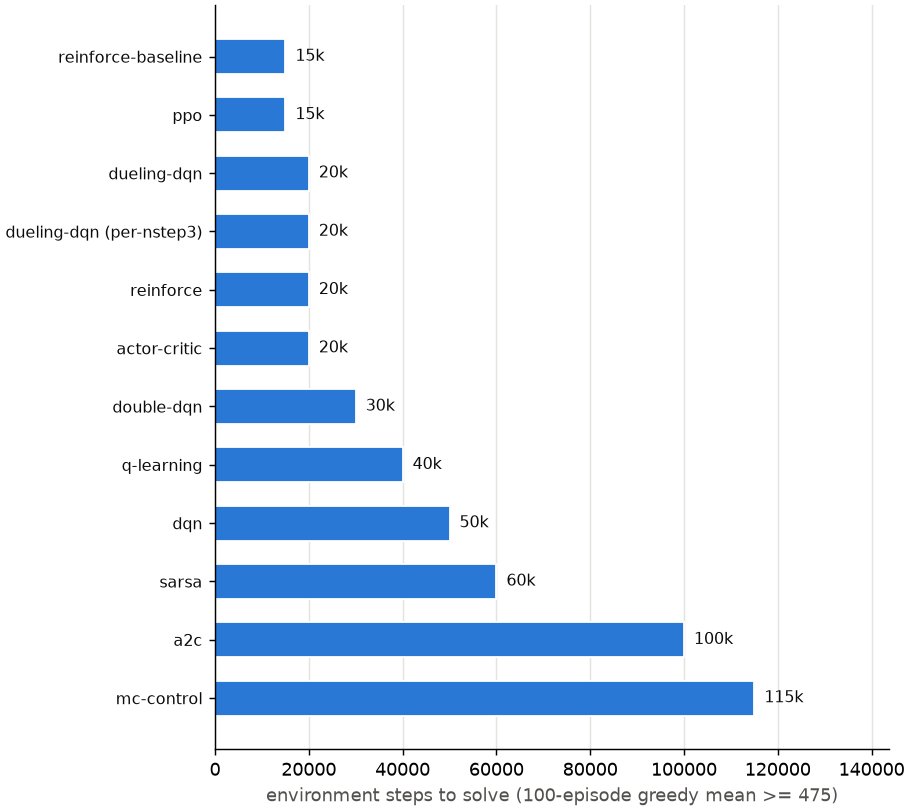
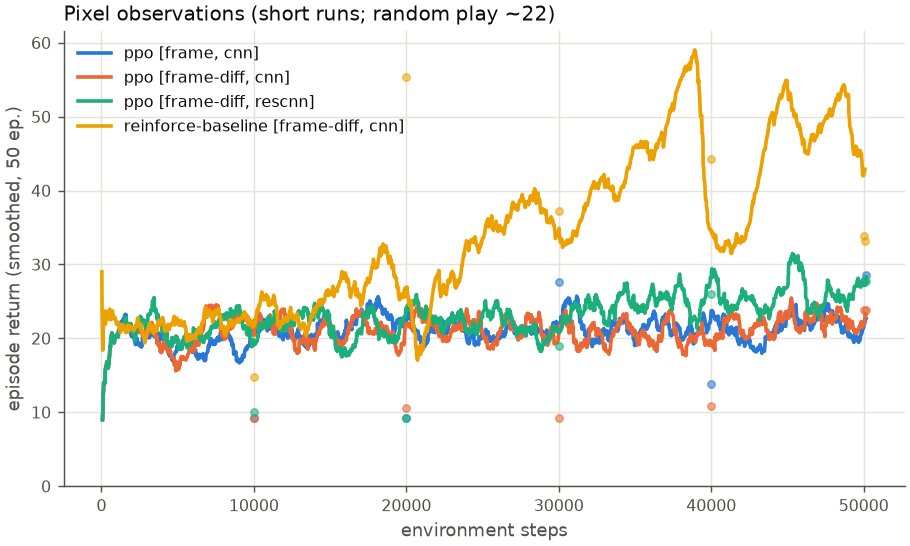
على ملاحظات الحالة، تحل الطرق الاثنتا عشرة المهمة كلها. PPO وREINFORCE + خط أساس يحلّانها بعد 15,000 خطوة، وQ-learning الجدولي بعد 40,000 خطوة لكن في 4 ثوانٍ فقط من وقت المعالج، وDQN العادي بعد 50,000 خطوة مع هضبة طويلة لا تظهر في متغيري double وdueling. تشغيلات البكسلات هي الجزء الصريح: 50,000 خطوة على المعالج المركزي بعيدة جدًا عن الكفاية، ولا ترتفع فوق اللعب العشوائي أصلًا سوى الوكلاء القائمين على فروق الإطارات.
السؤال
إذا شُغِّلت كل طرق التعلم المعزز (Reinforcement Learning) الكلاسيكية على البيئة نفسها وبالتقييم الجشع نفسه، فماذا يكشف منحنى تعلّم كل طريقة عن سبب وجود مكوّناتها (إعادة التشغيل، والشبكات الهدف، وخطوط الأساس، والقصّ)؟
أهم الميزات
- اثنتا عشرة طريقة خلف خيار واحد
--method: q-learning وsarsa وmc-control وdqn وdouble-dqn وdueling-dqn (مع--prioritizedو--n-step) وreinforce وreinforce-baseline وactor-critic وa2c وppo. - ثلاثة أنماط للملاحظة: الحالة ذات الأرقام الأربعة، أو إطار رمادي مرسوم بحجم 40x80، أو الإطار مع فرقه عن الإطار السابق، مع أجسام MLP وCNN وCNN متبقية (residual).
- أداة Recorder واحدة لكل الطرق: عدّ الخطوات، وتقييم جشع دوري على حالات بداية ثابتة، وتأكيد الحل، واستعادة أفضل الأوزان المقيَّمة في النهاية.
- معالجة صحيحة للاقتطاع في كل مكان: حد الوقت البالغ 500 خطوة يستند (bootstrap) إلى V(s') بينما يستخدم العمود الساقط القيمة 0.
cartpole-compareيدرّب أي مجموعة من الطرق وينتج جدول النتائج ومنحنيات العائد ومخطط الخطوات حتى الحل؛ وcartpole-playيسجّل صور GIF قبل التدريب وبعده على حالة البداية نفسها.- 53 اختبار pytest (نحو 40 ثانية على خيط معالج واحد) تغطي قواعد التحديث وأغلفة البيئة والشبكات وحفظ نقاط الحفظ واستعادتها وواجهات سطر الأوامر.
- دفتر Kaggle/Colab يشرح كل عائلة قبل تدريبها ويكرر المقارنة على ثلاث بذور عشوائية، إضافة إلى دفاتر المقرر الأصلية مع جدول بالأخطاء الخمسة عشر التي وُجدت فيها.
كيف يعمل
عملية قرار ماركوفية واحدة وثلاث رؤى لها
تعطي CartPole-v1 مكافأة +1 لكل خطوة إلى أن يميل العمود أكثر من 12 درجة، أو تغادر العربة المسار، أو تمر 500 خطوة. يرى الوكلاء الحالة الخام، أو إطارًا مرسومًا مقصوصًا، أو الإطار مع صورة الفرق؛ وتقسّم الطرق الجدولية الحالة إلى 1 x 6 x 12 x 12 = 864 خانة.
TD الجدولي وMonte Carlo
يُحدَّث جدول 864 x 2 بهدف Q-learning وهو r + gamma max Q(s', .)، أو بهدف SARSA الذي يستخدم الفعل المتخذ فعلًا بعد ذلك، أو بالعائد الحقيقي للحلقة في تحكم Monte Carlo، مع تناقص epsilon من 1.0 إلى 0.02.
طرق القيمة العميقة
تتدرب شبكة Q بحجم 4-128-128-2 على مخزن إعادة تشغيل مع شبكة هدف بمتوسط Polyak وخسارة Huber. وتفعّل الخيارات الهدف المزدوج (تختار الشبكة المتصلة a' وتقيّمه الشبكة الهدف)، ورأس dueling بصيغة Q = V + A - mean A، وإعادة التشغيل ذات الأولوية مع أوزان الأهمية، وعوائد n-step.
تدرّج السياسة والممثل-الناقد
يرفع REINFORCE قيمة log pi(a|s) مرجَّحة بـ reward-to-go المطبَّع، مطروحًا منه اختياريًا خط أساس متعلَّم V(s). يستخدم الممثل-الناقد بخطوة واحدة خطأ TD كميزة (advantage) بعد كل خطوة؛ ويشغّل A2C ثماني بيئات لثماني خطوات ثم يجري خطوة واحدة مجمّعة للممثل والناقد والإنتروبيا.
PPO
8 بيئات x 32 خطوة لكل جولة جمع (rollout)، ومزايا GAE (gamma 0.98، lambda 0.8)، ثم 20 حقبة على الدفعة مع قصّ نسبة الاحتمال إلى [0.8, 1.2] حتى لا تبعد التحديثات المتكررة السياسة كثيرًا عن تلك التي جمعت البيانات.
التقييم نفسه للجميع
كل 5,000 خطوة تلعب السياسة الجشعة 10 حالات بداية ثابتة؛ ويُؤكَّد المتوسط >= 475 على 100 حلقة إضافية، وتعطي أول نقطة مؤكَّدة عدد الخطوات والحلقات والثواني حتى الحل. ويملأ تقييم نهائي على 100 حلقة بحالات بداية غير مرئية الجدول.
أمثلة
المدخل
cartpole-train --method ppo --record ppo.gif
المخرج
[ppo/state] step 15000 ep 183 train(last20) 264.0 eval 500.0 +- 0.0 22.0s confirm(100) 498.1
التقنيات المستخدمة
شبكات Q والسياسات وأجسام CNN وكل قواعد التحديث
CartPole-v1 مع الرسم عبر pygame لأنماط البكسلات
جداول Q ومخازن إعادة التشغيل ومقسِّم الحالة إلى خانات
منحنيات العائد ومخططات الخطوات حتى الحل
53 اختبارًا لقواعد التحديث والبيئة والشبكات وواجهات سطر الأوامر
ما تعلمته
- الإطار المرسوم الواحد لا يحمل أي معلومة عن السرعة، لذلك يبقى وكيل البكسلات على إطار واحد عند المستوى العشوائي؛ وإضافة فرق الإطارات كقناة ثانية هي ما يتيح له التحسن أصلًا
- انهار عائد التدريب في A2C ثلاث مرات قبل أن يستقر، وهذا بالضبط الفشل الذي صُمِّمت نسبة PPO المقصوصة لمنعه: PPO يحل المهمة في 15,000 خطوة بالشبكة نفسها
الحدود
- بذرة عشوائية واحدة لكل طريقة وتشغيلات قصيرة: الطرق التي تحل المهمة ضمن فاصل أو فاصلي تقييم من 5,000 خطوة من بعضها قد تتبادل الترتيب مع بذرة أخرى
- تشغيلات البكسلات 50,000 خطوة على المعالج المركزي ولا يقترب أي منها من الحل؛ ويمدّها الدفتر إلى 200,000 خطوة
الكلمات المفتاحية
التعلم المعزز · CartPole · Gymnasium · Q-learning · SARSA · تحكم Monte Carlo · DQN · double DQN · dueling DQN · إعادة تشغيل الخبرة ذات الأولوية · REINFORCE · الممثل-الناقد · A2C · PPO · PyTorch