Diffusion Workbench
نماذج الانتشار والتدفق على حلقة واحدة
DDPM والمعادلات التفاضلية العشوائية للدرجة ومطابقة التدفق وEDM بشبكة واحدة وحلقة واحدة، بحيث لا يتغير سوى الصياغة.
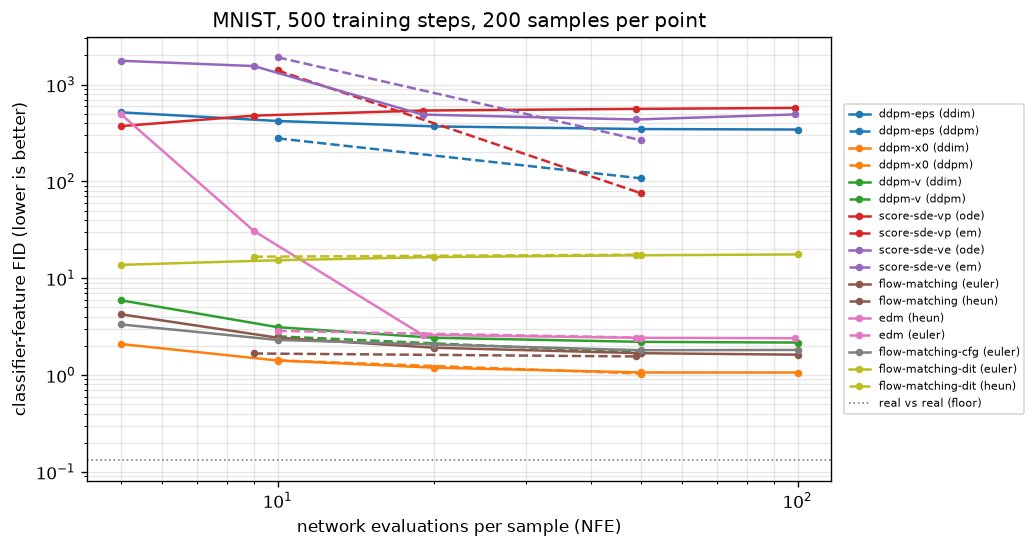
- FID 1.06 عند 50 NFE
- CFG: دقة التصنيف من 58.5% إلى 96.0%
- 45 اختبارًا
التقنيات PyTorchtorchvisionMatplotlib
 pytest
 Kaggle
نظرة عامة
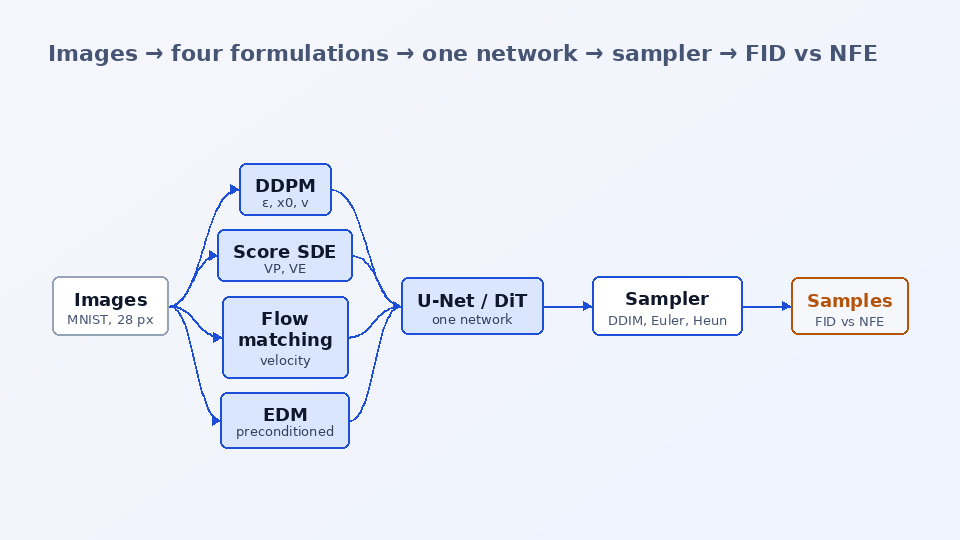
تُقدَّم DDPM والمعادلات التفاضلية العشوائية القائمة على الدرجة (score SDE) ومطابقة التدفق (flow matching) وEDM عادةً كنماذج مختلفة، لكنها فكرة واحدة: إفساد البيانات بضوضاء غاوسية على مستويات كثيرة، وتدريب شبكة على إزالة قليل منها، ثم البدء من ضوضاء خالصة وإزالتها خطوة بخطوة. وهي تختلف في ثلاثة خيارات: كيف تُضاف الضوضاء، وما الذي تتنبأ به الشبكة، وكيف يُكامَل المسار العكسي. أردت أن أرى هذه الخيارات الثلاثة ولا شيء غيرها، فكتبت كل صياغة كصنف بدالتين، loss() وsample()، بلغة PyTorch خالصة.
تتشارك كلها شبكة U-Net صغيرة واحدة (أو DiT)، وحلقة تدريب واحدة بـ AdamW وأوزان EMA، وواجهة معاينة واحدة (DDPM السلفي، وDDIM، وEuler-Maruyama، ومعادلة تدفق الاحتمال التفاضلية، وEuler وHeun)، وتقييمًا واحدًا. لا تعرف الشبكة أبدًا أي طريقة تخدم: تتلقى صورة ومستوى ضوضاء وتعيد موتّرًا بشكل صورة تحدد الطريقة معناه. ويعمل التوجيه بدون مصنِّف (classifier-free guidance) مع كل طريقة. حجم النماذج افتراضيًا 0.21 M معلمة لتتدرب في دقائق على المعالج المركزي؛ ويدرّبها دفتر Kaggle/Colab بحجم أكبر على CIFAR-10.
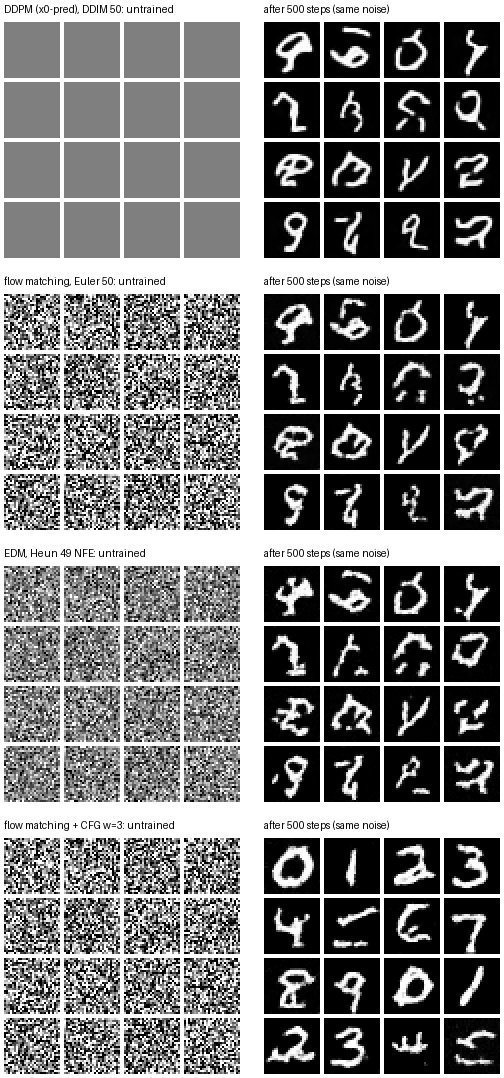
بعد 500 خطوة على MNIST، ينتج التنبؤ بـ x0 والتنبؤ بـ v ومطابقة التدفق وEDM كلها أرقامًا، ومع الضوضاء الابتدائية نفسها تنتج الأرقام نفسها. التنبؤ بـ ε هو الأبطأ تعلّمًا والمعايِنات الحتمية تكشف ذلك، وهذا بالضبط عدم الاستقرار الذي دفع إلى ابتكار التنبؤ بـ v والتكييف المسبق في EDM. يرفع التوجيه عند w = 3 التزام النموذج الشرطي بالتسمية من 58.5% إلى 96.0%. يحل هذا المستودع محل دفتر مقرر كان يستدعي Stable Diffusion عبر خط معالجة بمقبضين غامضين هما num_inference_steps وguidance_scale؛ وهو يبني ما يختبئ خلف هذين الرقمين.
السؤال
كل طرق الانتشار تضيف ضوضاء غاوسية وتتعلم إزالتها؛ فمع تثبيت الشبكة والبيانات والميزانية، إلى أي حد تغيّر الخيارات الثلاثة المتبقية (كيف تُضاف الضوضاء، وما الذي يُتنبأ به، وكيف يُكامَل المسار العكسي) ما تحصل عليه في كل خطوة معاينة؟
أهم الميزات
- أربع صياغات خلف خيار واحد: DDPM بالتنبؤ بـ ε أو x0 أو v وجداول خطية أو جيبية، وscore SDE بصيغتَي VP وVE، ومطابقة التدفق (rectified flow)، وEDM مع تكييف Karras المسبق.
- ستة معايِنات عبر واجهة واحدة، مع عدّ تقييمات الشبكة بتغليف الشبكة بدلًا من افتراضها (Heun يكلّف 2N - 1).
- توجيه بدون مصنِّف لكل طريقة: تُسقط التسميات في 10% من الحالات أثناء التدريب، ثم يُحسب uncond + w (cond - uncond) عند المعاينة.
- عمودان فقريان بالاستدعاء نفسه: شبكة U-Net التفافية مع انتباه عند 7x7، ومحوّل على الرقع (DiT) مع adaLN-Zero.
- تقييم واحد: FID على سمات مصنِّف من شبكة CNN صغيرة لـ MNIST، ودقة التسميات للنماذج الشرطية، ومسح لـ NFE عند 5 و10 و20 و50 و100 تقييم لكل صورة.
- أربعة أوامر (diffusion-data، وdiffusion-train، وdiffusion-sample مع مسارات إزالة الضوضاء، وdiffusion-eval)، وخمسة سكربتات أمثلة على مجموعة أشكال تعمل دون اتصال، ودفتر Kaggle/Colab يشتق كل طريقة قبل تشغيلها.
- 45 اختبارًا، منها اختبارات مزيل الضوضاء الدقيق: لبيانات مكوّنة من صورة واحدة يكون الخرج الأمثل للشبكة معروفًا بصيغة مغلقة، ويجب أن ينتهي كل معايِن إلى تلك الصورة.
كيف يعمل
إضافة الضوضاء
تعرّف كل طريقة عينة مشوَّشة عند مستوى عشوائي: sqrt(ā) x0 + sqrt(1 - ā) ε في DDPM، وm(t) x0 + s(t) ε في المعادلات العشوائية، والخط المستقيم (1 - t) x0 + t ε في مطابقة التدفق، وx0 + σ ε في EDM. كل صورة في الدفعة تحصل على مستواها الخاص.
انحدار نحو هدف
تحدد الطريقة معنى خرج الشبكة: الضوضاء ε، أو الصورة النظيفة x0، أو v = sqrt(ā) ε - sqrt(1 - ā) x0، أو السرعة ε - x0، أو الخرج المكيَّف مسبقًا في EDM. إذا عُرف أحدها استُنتجت البقية جبريًا؛ لكنها تختلف في صعوبة تعلّمها عند كل مستوى ضوضاء.
شبكة واحدة وحلقة واحدة
تتلقى U-Net أو DiT الصورة المشوَّشة وتضمينًا زمنيًا (مع تسمية) وتعيد موتّرًا بشكل صورة. تسحب الحلقة دفعة من الذاكرة، وتستدعي method.loss()، وتقصّ التدرّجات، وتنفّذ خطوة AdamW مع إحماء (warm-up)، وتحدّث نسخة EMA تُستخدم للمعاينة.
مكاملة المسار العكسي
تبدأ method.sample() من ضوضاء خالصة وتشغّل معايِنًا: DDPM السلفي أو DDIM لـ DDPM، وEuler-Maruyama أو معادلة تدفق الاحتمال التفاضلية لـ score SDE، وEuler أو Heun لمطابقة التدفق وEDM. عدد تقييمات الشبكة (NFE) هو التكلفة الحقيقية.
التوجيه والقياس
مع التوجيه، يشغّل التقييم الواحد الشبكة على دفعة مضاعفة ويستقرئ انطلاقًا من الخرج غير الشرطي. تُقيَّم كل نقطة حفظ عند عدة ميزانيات من NFE بمقياس FID على سمات المصنِّف مقابل مجموعة الاختبار، وبدقة التسميات للنماذج الشرطية.
أمثلة
المدخل
diffusion-eval runs/flow-matching-cfg/last.pt --guidance 0 1 3 --nfe 20
المخرج
w = 0: FID 3.20, label accuracy 11.0% (chance) w = 1: FID 2.07, label accuracy 58.5% w = 3: FID 1.10, label accuracy 96.0%
التقنيات المستخدمة
الطرق والأعمدة الفقرية والمعايِنات وحلقة التدريب والتقييم
تنزيل MNIST وFashionMNIST وCIFAR-10
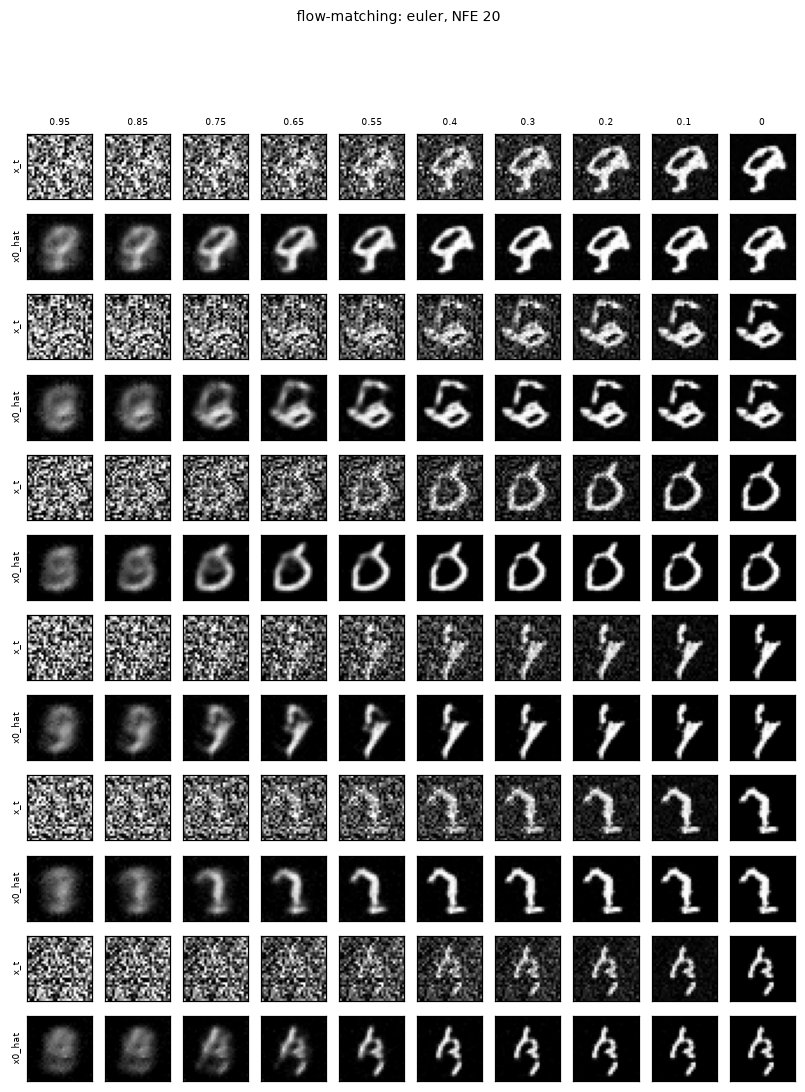
شبكات العينات ومسارات إزالة الضوضاء ومنحنيات الخسارة وNFE
45 اختبارًا، منها فحوص المعايِنات بمزيل الضوضاء الدقيق
دفتر يشتق كل طريقة ويدرّب نماذج أكبر على CIFAR-10 على وحدة معالجة رسومية مجانية
ما تعلمته
- المعايِنات الحتمية للصياغات المختلفة تتعلم تقريبًا التحويل نفسه من الضوضاء إلى الصورة: الضوضاء الابتدائية نفسها تعطي الأرقام نفسها
- هدف التنبؤ يحدد مدى صعوبة الخطوات الأكثر تشويشًا: خطأ صغير في ε قرب الضوضاء الخالصة يترك ضوضاء لا يزيلها شيء لاحقًا
- اختبار المعايِنات مقابل مزيل ضوضاء دقيق يفصل أخطاء المعايِن عن آثار التدريب؛ وقد بيّن أن معايِنات score SDE كانت تحتاج إلى خطوة إزالة ضوضاء أخيرة
الحدود
- تشغيلات قصيرة أحادية الخيط على المعالج المركزي على MNIST بحجم 28 بكسل مع FID على 200 عينة من مصنِّف صغير لا من Inception: الأرقام ترتّب تشغيلات هذا المستودع ولا شيء غيره
- العمود الفقري DiT غير مدرَّب بما يكفي بعد 500 خطوة (FID 13.8-17.6، ورقع مكعّبة)، ولا تُنشر أي أوزان مدرَّبة مسبقًا
الكلمات المفتاحية
نماذج الانتشار · DDPM · DDIM · التنبؤ بـ v · التنبؤ بـ x0 · النماذج التوليدية القائمة على الدرجة · score SDE · معادلة تدفق الاحتمال التفاضلية (probability-flow ODE) · مطابقة التدفق · rectified flow · EDM · التوجيه بدون مصنِّف · DiT · U-Net · NFE · FID · MNIST · PyTorch · النماذج التوليدية