Diffusion Workbench
Modèles de diffusion et de flux sur une même boucle
DDPM, SDE de score, flow matching et EDM avec un seul réseau et une seule boucle, pour que seule la formulation change.
- FID 1,06 à 50 NFE
- CFG : 58,5 % → 96,0 % de bonnes classes
- 45 tests
Construit avec PyTorchtorchvisionMatplotlib
 pytest
 Kaggle
Présentation
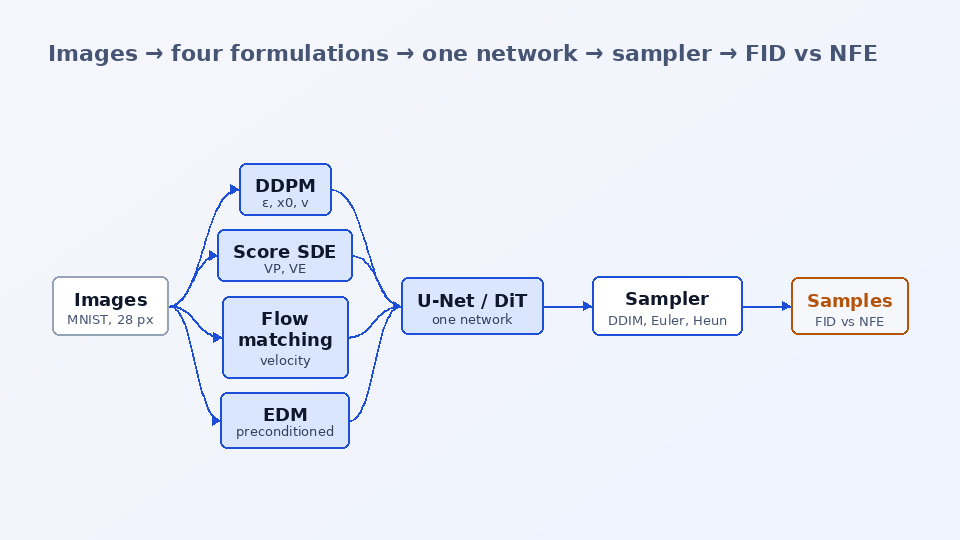
DDPM, les SDE de score, le flow matching et EDM sont généralement présentés comme des modèles différents, mais ils relèvent d'une seule idée : corrompre les données avec du bruit gaussien à de nombreux niveaux, entraîner un réseau à en retirer un peu, puis partir d'un bruit pur et le retirer pas à pas. Ils diffèrent par trois choix : comment le bruit est ajouté, ce que le réseau prédit, et comment le processus inverse est intégré. Je voulais voir ces trois choix et rien d'autre, j'ai donc écrit chaque formulation comme une classe à deux fonctions, loss() et sample(), en PyTorch pur.
Toutes partagent un même petit U-Net (ou un DiT), une même boucle d'entraînement avec AdamW et des poids EMA, une même interface de sampler (DDPM ancestral, DDIM, Euler-Maruyama, l'ODE de flot de probabilité, Euler et Heun) et une même évaluation. Le réseau ne sait jamais quelle méthode il sert : il reçoit une image et un niveau de bruit et renvoie un tenseur de la forme d'une image dont la méthode décide le sens. Le guidage sans classifieur fonctionne avec chaque méthode. Les modèles font 0.21 M de paramètres par défaut pour s'entraîner en quelques minutes sur un CPU ; un notebook Kaggle/Colab les entraîne en plus grand sur CIFAR-10.
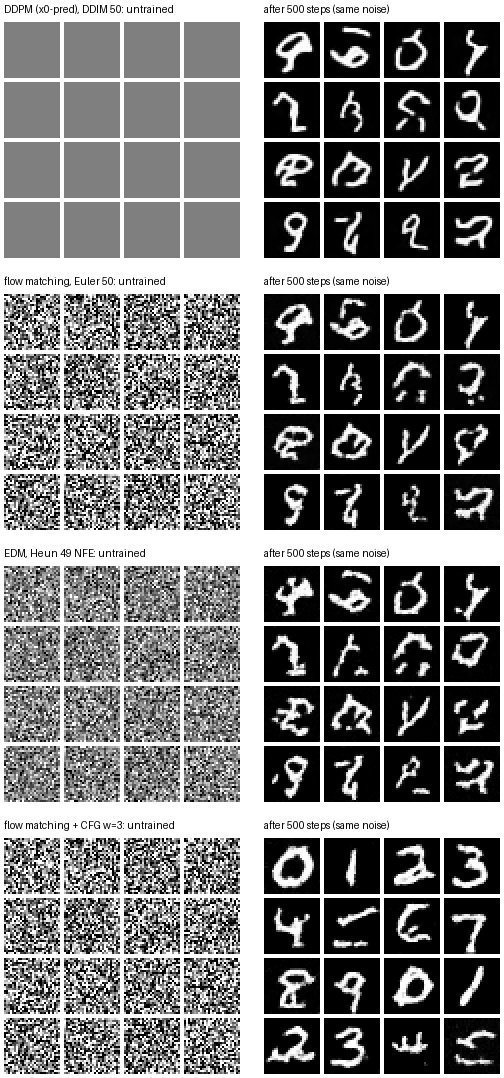
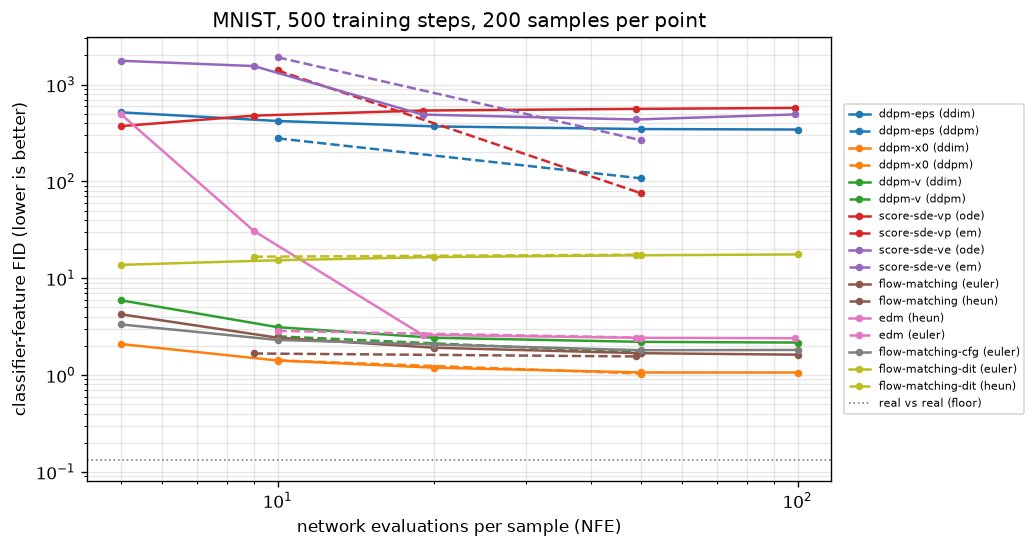
Après 500 pas sur MNIST, la prédiction de x0, la prédiction de v, le flow matching et EDM produisent tous des chiffres, et avec le même bruit de départ ils produisent les mêmes chiffres. La prédiction de ε est la plus lente à apprendre et les samplers déterministes le révèlent, ce qui est exactement l'instabilité qui a motivé la prédiction de v et le préconditionnement d'EDM. Le guidage à w = 3 fait passer le modèle conditionnel de 58.5 % à 96.0 % de respect du label. Le dépôt remplace un notebook de cours qui appelait Stable Diffusion via un pipeline avec num_inference_steps et guidance_scale comme boutons opaques ; il construit ce qui se cache derrière ces deux nombres.
La question
Toutes les méthodes de diffusion ajoutent du bruit gaussien et apprennent à le retirer ; à réseau, données et budget fixés, à quel point les trois choix restants (comment le bruit est ajouté, ce qui est prédit, comment le processus inverse est intégré) changent-ils ce qu'on obtient par pas d'échantillonnage ?
Fonctionnalités clés
- Quatre formulations derrière un seul flag : DDPM avec prédiction de ε, de x0 ou de v et schedules linéaire ou cosinus, SDE de score sous forme VP et VE, flow matching (rectified flow) et EDM avec préconditionnement de Karras.
- Six samplers via une même interface, le nombre d'évaluations du réseau étant compté en enveloppant le réseau plutôt que supposé (Heun coûte 2N - 1).
- Guidage sans classifieur pour chaque méthode : labels supprimés 10 % du temps pendant l'entraînement, puis uncond + w (cond - uncond) à l'échantillonnage.
- Deux backbones avec le même appel : un U-Net convolutif avec attention en 7x7, et un Transformer sur patchs (DiT) avec adaLN-Zero.
- Une seule évaluation : un FID sur features de classifieur issu d'un petit CNN MNIST, la précision sur les labels pour les modèles conditionnels, et un balayage en NFE à 5, 10, 20, 50 et 100 évaluations par image.
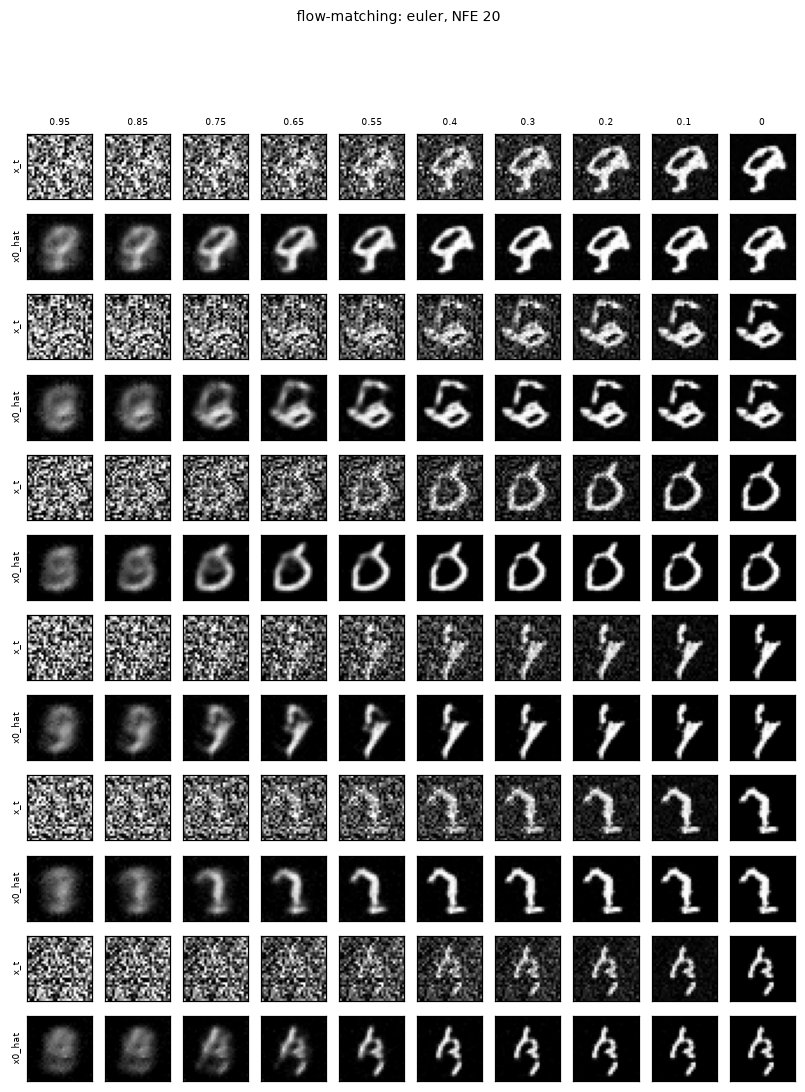
- Quatre commandes (diffusion-data, diffusion-train, diffusion-sample avec trajectoires de débruitage, diffusion-eval), cinq scripts d'exemple sur un jeu de formes hors ligne, et un notebook Kaggle/Colab qui dérive chaque méthode avant de l'exécuter.
- 45 tests, dont des tests avec débruiteur exact : pour des données constituées d'une seule image, la sortie optimale du réseau est connue en forme close, et chaque sampler doit atterrir sur cette image.
Comment ça marche
Ajouter du bruit
Chaque méthode définit un échantillon bruité à un niveau aléatoire : sqrt(ā) x0 + sqrt(1 - ā) ε pour DDPM, m(t) x0 + s(t) ε pour les SDE, la ligne droite (1 - t) x0 + t ε pour le flow matching, x0 + σ ε pour EDM. Chaque image d'un batch reçoit son propre niveau.
Régresser une cible
La méthode décide du sens de la sortie du réseau : le bruit ε, l'image propre x0, v = sqrt(ā) ε - sqrt(1 - ā) x0, la vitesse ε - x0, ou la sortie préconditionnée d'EDM. À partir de l'une d'elles, les autres s'obtiennent par algèbre ; elles diffèrent par leur difficulté d'apprentissage à chaque niveau de bruit.
Un réseau, une boucle
Le U-Net ou le DiT reçoit l'image bruitée et un embedding temporel (plus un label) et renvoie un tenseur de la forme d'une image. La boucle tire un batch depuis la mémoire, appelle method.loss(), clippe les gradients, fait un pas d'AdamW avec warm-up et met à jour une copie EMA utilisée pour l'échantillonnage.
Intégrer le processus inverse
method.sample() part d'un bruit pur et exécute un sampler : DDPM ancestral ou DDIM pour DDPM, Euler-Maruyama ou l'ODE de flot de probabilité pour les SDE de score, Euler ou Heun pour le flow matching et EDM. Le nombre d'évaluations du réseau (NFE) est le vrai coût.
Guider et mesurer
Avec le guidage, une évaluation fait tourner le réseau sur un batch doublé et extrapole à partir de la sortie inconditionnelle. Chaque checkpoint est noté à plusieurs budgets de NFE avec le FID sur features de classifieur contre le jeu de test et, pour les modèles conditionnels, la précision sur les labels.
Exemples
Entrée
diffusion-eval runs/flow-matching-cfg/last.pt --guidance 0 1 3 --nfe 20
Sortie
w = 0: FID 3.20, label accuracy 11.0% (chance) w = 1: FID 2.07, label accuracy 58.5% w = 3: FID 1.10, label accuracy 96.0%
Stack technique
Méthodes, backbones, samplers, boucle d'entraînement et évaluation
Téléchargement de MNIST, FashionMNIST et CIFAR-10
Grilles d'échantillons, trajectoires de débruitage, courbes de perte et de NFE
45 tests, dont les vérifications des samplers avec débruiteur exact
Notebook qui dérive chaque méthode et entraîne de plus grands modèles sur CIFAR-10 sur un GPU gratuit
Ce que j’ai appris
- Les samplers déterministes de formulations différentes apprennent presque la même application bruit-vers-image : le même bruit de départ donne les mêmes chiffres
- La cible de prédiction décide de la difficulté des pas les plus bruités : une petite erreur sur ε près du bruit pur laisse un bruit que rien ne retire ensuite
- Tester les samplers contre un débruiteur exact sépare les bugs de sampler des effets de l'entraînement ; cela a montré que les samplers de SDE de score avaient besoin d'un pas de débruitage final
Limites
- Des runs CPU courts et mono-thread sur MNIST en 28 px avec des FID à 200 échantillons issus d'un petit classifieur, pas d'Inception : les chiffres classent les runs de ce dépôt et rien d'autre
- Le backbone DiT est sous-entraîné après 500 pas (FID 13.8-17.6, patchs en blocs), et aucun poids pré-entraîné n'est publié
Mots-clés
modèles de diffusion · DDPM · DDIM · prédiction de v · prédiction de x0 · modèles génératifs par score · SDE de score · ODE de flot de probabilité · flow matching · rectified flow · EDM · guidage sans classifieur · DiT · U-Net · NFE · FID · MNIST · PyTorch · modèles génératifs