English-to-Arabic Translator
Traduction automatique par Transformer
Un Transformer encodeur-décodeur écrit de zéro qui apprend la traduction de l'anglais vers l'arabe à partir de n'importe quel corpus parallèle.
- BLEU 98,4 sur le jeu jouet
- chrF 99,0
- Préréglages de 3,0 M à 52,3 M paramètres
Construit avec PyTorchCustom TransformersHugging Face TokenizersBeam search
 Hugging Face DatasetssacreBLEU
 pytest
Présentation
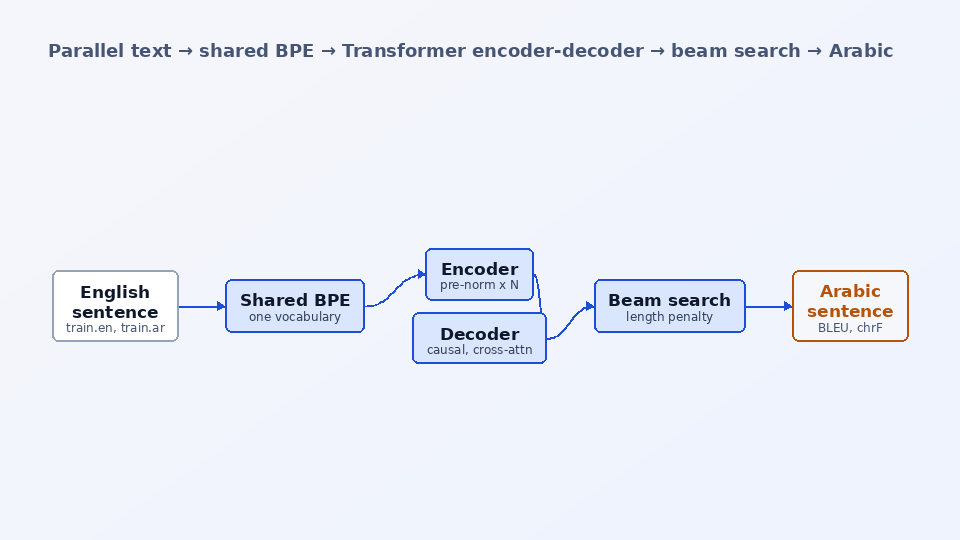
La traduction automatique est la tâche pour laquelle le Transformer a été conçu, j'ai donc écrit le modèle encodeur-décodeur d'Attention Is All You Need en PyTorch pur, environ 150 lignes pour le modèle lui-même, et construit autour tout ce dont un système de traduction a besoin : préparation des données, tokenizer, entraînement, décodage et évaluation. L'anglais vers l'arabe est la paire par défaut, mais les codes de langue ne sont que des suffixes de fichiers.
Le modèle utilise des blocs résiduels pre-norm, un vocabulaire BPE partagé avec embeddings d'entrée et de sortie liés, et une attention par produit scalaire fusionnée avec masques de padding côté source et masques causaux côté cible. Le tokenizer est entraîné sur les données et gère n'importe quel alphabet, de sorte que l'arabe reste dans son ordre naturel sans aucune astuce d'inversion. L'entraînement comprend le lissage des labels, un schedule de warm-up, des batchs regroupés par longueur, l'accumulation de gradients, la reprise et des checkpoints autonomes ; le décodage est glouton par batch ou par recherche en faisceau avec pénalité de longueur ; l'évaluation rapporte BLEU et chrF avec sacreBLEU, plus le moyennage de checkpoints.
J'ai vérifié le pipeline de bout en bout sur un jeu de données jouet intégré : 2 000 paires synthétiques issues d'un lexique anglais de 16 mots traduites mot à mot en arabe. Un modèle de 0.95 M de paramètres entraîné pendant 1 500 pas CPU atteint BLEU 98.4 et chrF 99.0 sur 100 paires jamais vues. Cela prouve que le code fonctionne ; cela ne dit rien de la qualité de traduction réelle, qui exige un corpus tel qu'OPUS-100 et un GPU.
La question
Un Transformer compact et lisible, plus le pipeline complet qui l'entoure (nettoyage des données, tokenizer, entraînement, décodage, scoring), peut-il aller du texte parallèle brut jusqu'aux traductions sans aucune boîte noire ?
Fonctionnalités clés
- L'encodeur-décodeur Transformer écrit de zéro : positions sinusoïdales, attention multi-têtes avec masques de padding et causaux, blocs pre-norm et embeddings liés.
- en2ar-prepare nettoie, dédoublonne, découpe et tokenise n'importe quel corpus parallèle : vos propres fichiers, un jeu de données Hugging Face avec une colonne translation, ou le jeu jouet intégré.
- Un tokenizer BPE partagé avec normalisation NFKC qui fonctionne pour n'importe quel alphabet et garde le texte de droite à gauche dans l'ordre logique.
- Entraînement avec lissage des labels, warm-up de Noam, batchs à budget de tokens, accumulation de gradients, reprise, un test de sur-apprentissage et des checkpoints qui embarquent leur propre tokenizer.
- Décodage glouton par batch et recherche en faisceau avec pénalité de longueur, depuis la CLI, depuis des fichiers, depuis des pipes ou depuis Python.
- Évaluation BLEU et chrF avec sacreBLEU et moyennage de checkpoints.
- 43 tests CPU uniquement, dont un vrai run d'entraînement qui doit traduire exactement plus de 90 % des phrases jouets jamais vues.
Comment ça marche
Préparer
Les phrases sont nettoyées (filtres sur la longueur, le ratio de longueurs et les doublons), mélangées, découpées et utilisées pour entraîner un seul vocabulaire BPE pour les deux langues.
Plonger
Les identifiants de tokens passent par une seule table d'embeddings partagée par l'encodeur, le décodeur et la projection de sortie, mise à l'échelle par la racine carrée de la largeur et additionnée aux positions sinusoïdales.
Encoder et décoder
Les couches d'encodeur pre-norm construisent une mémoire de la source ; les couches du décodeur utilisent une auto-attention causale sur la cible produite jusque-là et une attention croisée sur cette mémoire.
Entraîner
Entropie croisée avec lissage des labels sur le token cible suivant, Adam avec le schedule de Noam, batchs regroupés par longueur jusqu'à un budget de tokens, et la meilleure perte de validation sauvegardée dans best.pt.
Traduire et évaluer
Décodage glouton pour la vitesse ou recherche en faisceau avec pénalité de longueur pour la qualité ; en2ar-evaluate note le split de test avec le BLEU de corpus et chrF.
Exemples
Entrée
en2ar-translate --checkpoint checkpoints/toy/best.pt --text "three red bird" --text "blue cat" --text "seven green dog one"
Sortie
ثلاثة أحمر طائر أزرق قطة سبعة أخضر كلب واحد
Entrée
en2ar-train --data-dir data/toy --preset small --max-steps 1500 --warmup-steps 200 --eval-every 500 --tokens-per-batch 1000 --device cpu && en2ar-evaluate --checkpoint checkpoints/toy/best.pt --beam-size 1
Sortie
val loss 0.092 (perplexity 1.10) at step 1000; test BLEU 98.4, chrF 99.0 greedy; BLEU 95.1, chrF 95.9 with beam size 4
Stack technique
Le Transformer, la boucle d'entraînement et le décodage
Custom Transformers
Encodeur-décodeur avec blocs pre-norm, embeddings liés et attention fusionnée
Tokenizer BPE partagé entraîné sur le corpus
Beam search
Recherche en faisceau avec pénalité de longueur et décodage glouton par batch
Téléchargement de corpus parallèles tels qu'OPUS-100 (extra optionnel)
Scores BLEU de corpus et chrF
43 tests : masques, tokenizer, batching, décodage, un vrai run d'entraînement
Ce que j’ai appris
- Un vocabulaire BPE partagé est ce qui rend possibles les embeddings liés, et il supprime toute bidouille propre à un alphabet, y compris l'inversion de l'arabe
- La recherche en faisceau n'est pas toujours meilleure que le décodage glouton : sur une tâche mot à mot, la pénalité de longueur, réglée pour de vraies phrases, coûte environ 3 points de BLEU
Limites
- Seul le jeu de données jouet a été entraîné et évalué ; il n'y a aucun score BLEU sur OPUS-100 ou un autre corpus réel, ni de poids pré-entraînés
Mots-clés
traduction automatique · traduction automatique neuronale · NMT · anglais vers arabe · TAL arabe · Transformer · encodeur-décodeur · attention · de zéro · BPE · byte-pair encoding · recherche en faisceau · lissage des labels · BLEU · chrF · sacreBLEU · OPUS-100 · PyTorch · séquence à séquence