FrozenLake RL
Méthodes classiques d’apprentissage par renforcement confrontées à l’optimum exact
Quatorze méthodes classiques d’apprentissage par renforcement sur FrozenLake, Taxi et CliffWalking, chacune mesurée par rapport à l’optimum exact calculé à partir du modèle.
- Dyna-Q optimal en 240 épisodes
- 4 environnements en grille
Construit avec Python
 NumPyGymnasium
 PyTorchMatplotlib
 pytest
Présentation
Les environnements toy-text de Gymnasium sont assez petits pour que la politique optimale se calcule exactement à partir du modèle de transition, ce qui en fait le bon terrain pour vérifier qu’une méthode d’apprentissage fonctionne vraiment, plutôt que de deviner à partir de courbes bruitées. J’ai construit un seul package où chaque méthode classique de Sutton et Barto se lance avec la même commande : itération sur les valeurs et sur les politiques, contrôle Monte Carlo first-visit et every-visit, SARSA, expected SARSA, Q-learning, double Q-learning, SARSA à n pas, SARSA(lambda) et Q(lambda) avec traces d’éligibilité, Dyna-Q, ainsi que DQN et REINFORCE sur des états one-hot.
Toutes les méthodes utilisent le même calendrier d’exploration et les deux mêmes évaluations : un score exact de la politique gloutonne calculé à partir du modèle dans la limite de temps, et 1,000 épisodes réels. Un programme dynamique à horizon fini donne le plafond de chaque environnement, si bien que chaque tableau se lit comme une distance à la meilleure politique possible. Le même code produit les cartes de chaleur des valeurs, les flèches de politique, les courbes d’apprentissage et les animations avant/après.
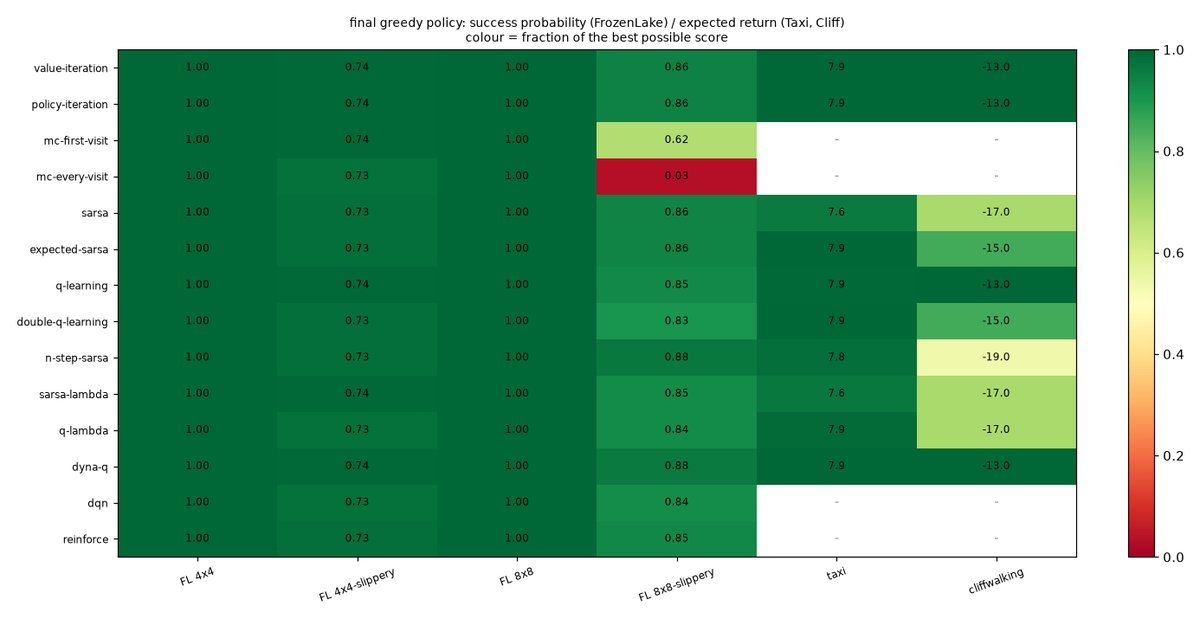
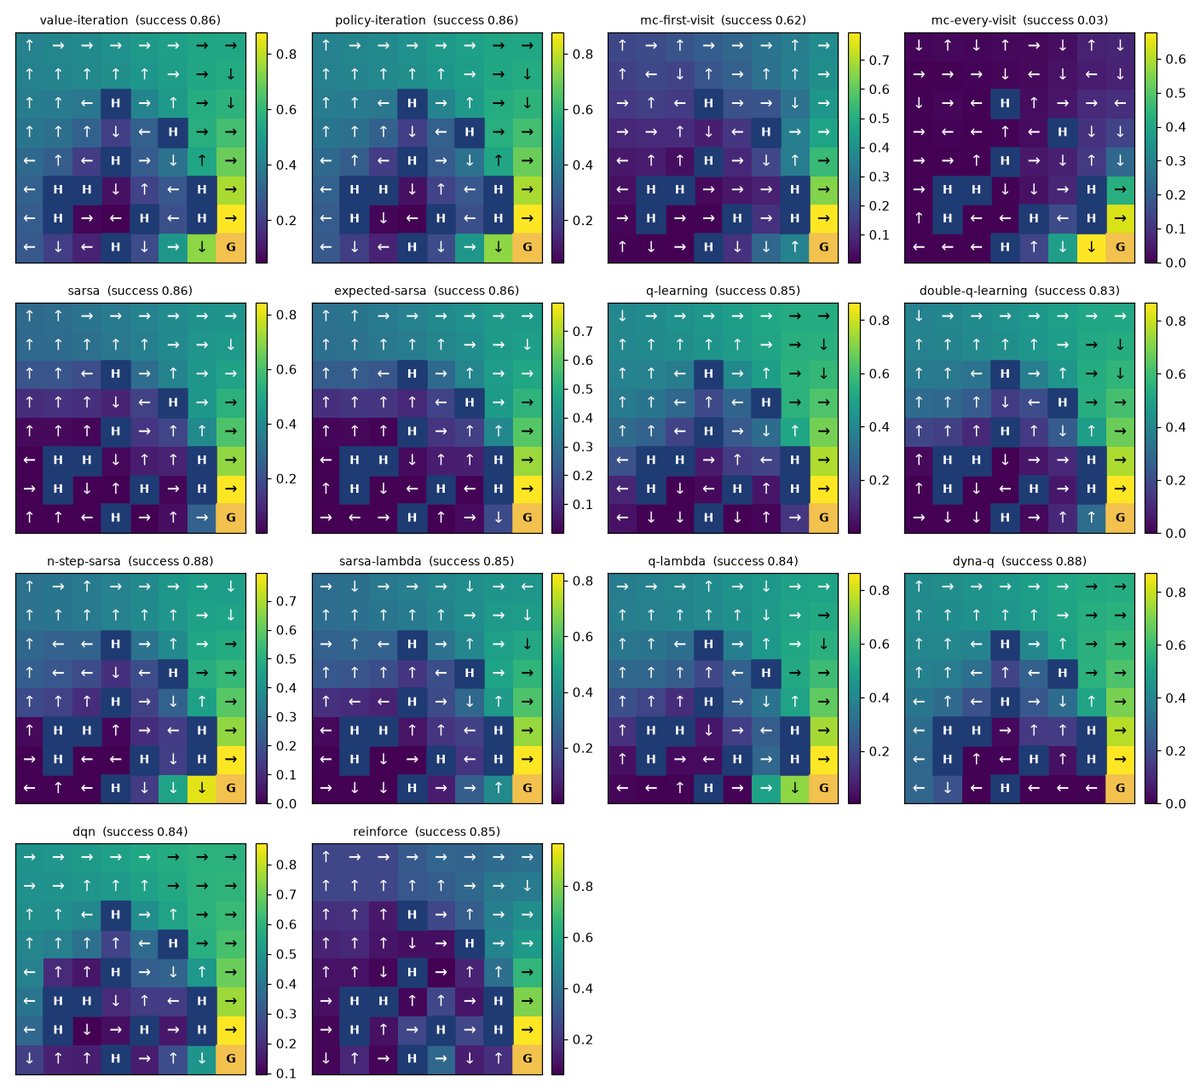
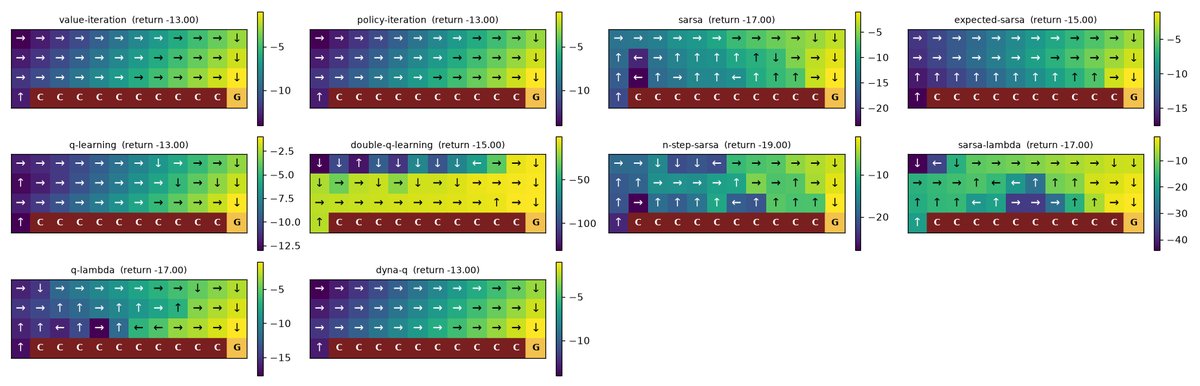
Les runs confirment le manuel et le chiffrent. Toutes les méthodes atteignent l’optimum sur le lac 4x4 glissant, mais Dyna-Q a besoin de 240 épisodes là où le Monte Carlo every-visit en demande 19,200. Sur le lac 8x8 glissant, Monte Carlo échoue nettement (0.62 et 0.03 de réussite) tandis que les méthodes TD atteignent 0.83-0.88. Sur CliffWalking, Q-learning trouve le chemin à -13 le long du bord et SARSA garde un chemin plus sûr à -17, exactement comme dans l’exemple 6.6 du livre.
La question
Quand le problème est assez petit pour que la politique optimale se calcule à partir du modèle, à quel point chaque méthode classique s’en approche-t-elle, et combien d’épisodes lui faut-il pour y parvenir ?
Fonctionnalités clés
- Quatorze méthodes derrière un seul flag
--method, regroupées en DP, Monte Carlo, TD, n pas et traces, planification et neuronales, sur six environnements : FrozenLake 4x4 et 8x8 avec et sans glissement, Taxi et CliffWalking. - Évaluation exacte de n’importe quelle politique à partir du modèle de transition P avec la limite de temps, plus une évaluation par rollouts sur 1,000 épisodes qui concorde avec elle à l’erreur Monte Carlo près.
- Un plafond DP à horizon fini par environnement (0.744 et 0.913 sur les lacs glissants, 7.93 sur Taxi, -13 sur CliffWalking), pour que chaque résultat se lise comme une distance à l’optimum.
- Un Tracker qui note la politique gloutonne en 100 points par run et rapporte le nombre d’épisodes jusqu’à la cible, avec courbes d’apprentissage et retours d’entraînement en ligne.
- Cartes de chaleur des valeurs, flèches de politique, tables Q et figure récapitulative pour chaque run ; GIF avant/après rendus à partir des frames rgb_array de Gymnasium, avec les cases visitées marquées.
frozenlake-comparelance n’importe quel groupe de méthodes sur un environnement et écrit le tableau comparatif ; les six suites prennent 12 minutes sur un seul thread CPU.- 40 tests pytest et six scripts d’exemple qui suivent l’ordre du livre, plus un notebook Kaggle/Colab qui montre le code de chaque méthode à côté de son run.
Comment ça marche
Exposer le modèle
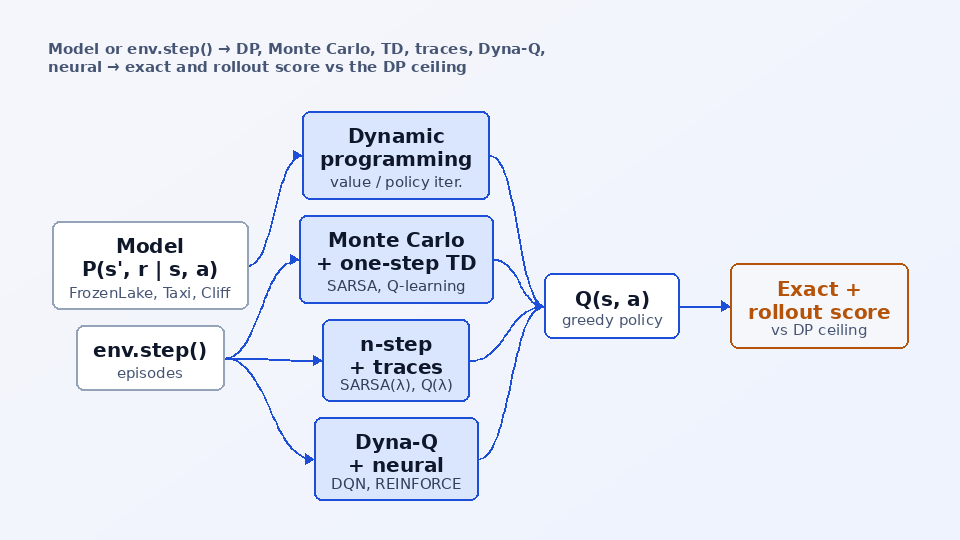
La table de transition P(s', r | s, a) de chaque environnement est lue une fois depuis Gymnasium. Seuls la programmation dynamique et l’évaluateur exact s’en servent ; les agents qui apprennent ne voient que env.step().
Programmation dynamique
L’itération sur les valeurs applique l’équation d’optimalité de Bellman à tous les états jusqu’à ce que les valeurs ne bougent plus (39 balayages sur le lac 8x8 glissant) ; l’itération sur les politiques alterne évaluation exacte et amélioration gloutonne (8 balayages).
Apprendre à partir d’épisodes
Monte Carlo rapproche Q(s, a) du retour complet ; SARSA, expected SARSA, Q-learning et double Q-learning font du bootstrap à un pas avec leur propre cible ; SARSA à n pas, SARSA(lambda) et Q(lambda) répartissent chaque erreur TD sur les paires récemment visitées ; Dyna-Q rejoue un modèle de comptage appris 10 fois par pas réel.
Versions neuronales
DQN entraîne un Q-network MLP sur des états one-hot avec un replay buffer et un réseau cible ; REINFORCE entraîne une politique softmax avec une baseline de valeur apprise et moyenne 10 épisodes par mise à jour, sans quoi il reste bloqué à 60 % sur le lac 4x4 glissant.
Évaluer exactement, puis pour de vrai
La probabilité de réussite ou le retour espéré de la politique gloutonne est calculé à partir de P dans la limite de temps, puis mesuré à nouveau sur 1,000 épisodes réels ; le premier des 100 points d’évaluation où le score exact atteint la cible donne le nombre d’épisodes jusqu’à la cible.
Exemples
Entrée
frozenlake-train --env frozenlake-4x4-slippery --method q-learning
Sortie
runs/frozenlake-4x4-slippery/q-learning/ (agent.npz, summary.json, history.json, run.png): 10,000 episodes in 5.5 s, target reached after 1,400 episodes, exact greedy success 0.740, rollout success 0.729 over 1,000 episodes
Stack technique
Tous les algorithmes, l’évaluateur exact et les CLI
Tables Q, modèle de transition P et évaluation exacte
FrozenLake, Taxi et CliffWalking (toy-text) et le rendu rgb_array pour les GIF
DQN et REINFORCE sur des états one-hot
Cartes de chaleur, flèches de politique, courbes d’apprentissage et tableau récapitulatif
40 tests, dont la concordance entre évaluation exacte et rollouts
Ce que j’ai appris
- Évaluer exactement la politique gloutonne à partir du modèle de transition supprime le bruit des rollouts, et c’est ce qui fait du nombre d’« épisodes jusqu’à la cible » une grandeur mesurable sur un lac glissant
- Le contrôle Monte Carlo casse sur les épisodes longs et stochastiques : avec 50-200 pas glissants par retour, le MC every-visit n’apprend jamais de politique 8x8 exploitable, alors que le TD à un pas y parvient
Limites
- Une seule graine par run : des écarts de quelques centièmes entre méthodes sur les lacs glissants restent dans le bruit
- Taxi et CliffWalking n’ont été lancés qu’avec les méthodes DP, TD et Dyna-Q (10 sur 14)
Mots-clés
apprentissage par renforcement · RL tabulaire · FrozenLake · Taxi · CliffWalking · Gymnasium · programmation dynamique · itération sur les valeurs · itération sur les politiques · contrôle Monte Carlo · SARSA · Q-learning · traces d’éligibilité · Dyna-Q · Sutton et Barto