FrozenLake RL
طرق التعلم المعزز الكلاسيكية مقارنةً بالحل الأمثل الدقيق
أربع عشرة طريقة كلاسيكية للتعلم المعزز على FrozenLake وTaxi وCliffWalking، تُقاس كل منها مقارنةً بالحل الأمثل الدقيق المحسوب من النموذج.
- Dyna-Q يبلغ الأمثل في 240 حلقة
- 4 بيئات شبكية
التقنيات Python
 NumPyGymnasium
 PyTorchMatplotlib
 pytest
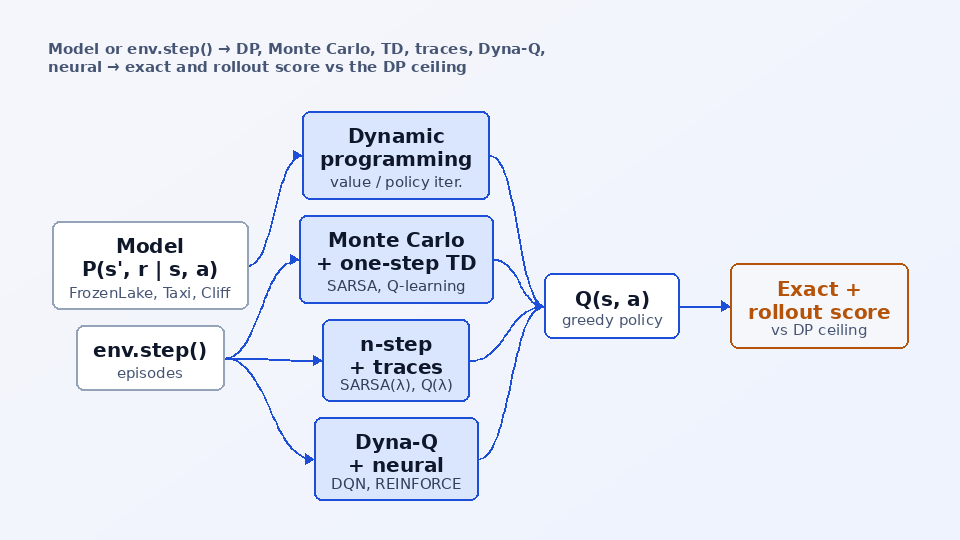
نظرة عامة
بيئات toy-text في Gymnasium صغيرة بما يكفي لحساب السياسة المثلى بدقة من نموذج الانتقال، ما يجعلها المكان المناسب للتحقق من أن طريقة التعلم تعمل فعلًا بدل التخمين من منحنيات مليئة بالضجيج. بنيتُ حزمة واحدة تُشغَّل فيها كل طريقة كلاسيكية من كتاب Sutton وBarto بالأمر نفسه: تكرار القيمة (Value Iteration) وتكرار السياسة (Policy Iteration)، والتحكم بطريقة مونت كارلو (Monte Carlo) بنسختيه first-visit وevery-visit، وSARSA وexpected SARSA وQ-learning وdouble Q-learning، وSARSA متعدد الخطوات، وSARSA(lambda) وQ(lambda) مع آثار الأهلية (Eligibility Traces)، وDyna-Q، إضافة إلى DQN وREINFORCE على حالات بترميز one-hot.
تستخدم جميع الطرق جدول الاستكشاف نفسه والتقييمين نفسيهما: درجة دقيقة للسياسة الجشعة تُحسب من النموذج ضمن الحد الزمني، و1,000 حلقة حقيقية. ويعطي برنامج ديناميكي بأفق محدود السقفَ لكل بيئة، فيُقرأ كل جدول على أنه المسافة إلى أفضل سياسة ممكنة. وترسم الشيفرة نفسها خرائط حرارية للقيم، وأسهم السياسة، ومنحنيات التعلم، والرسوم المتحركة قبل التدريب وبعده.
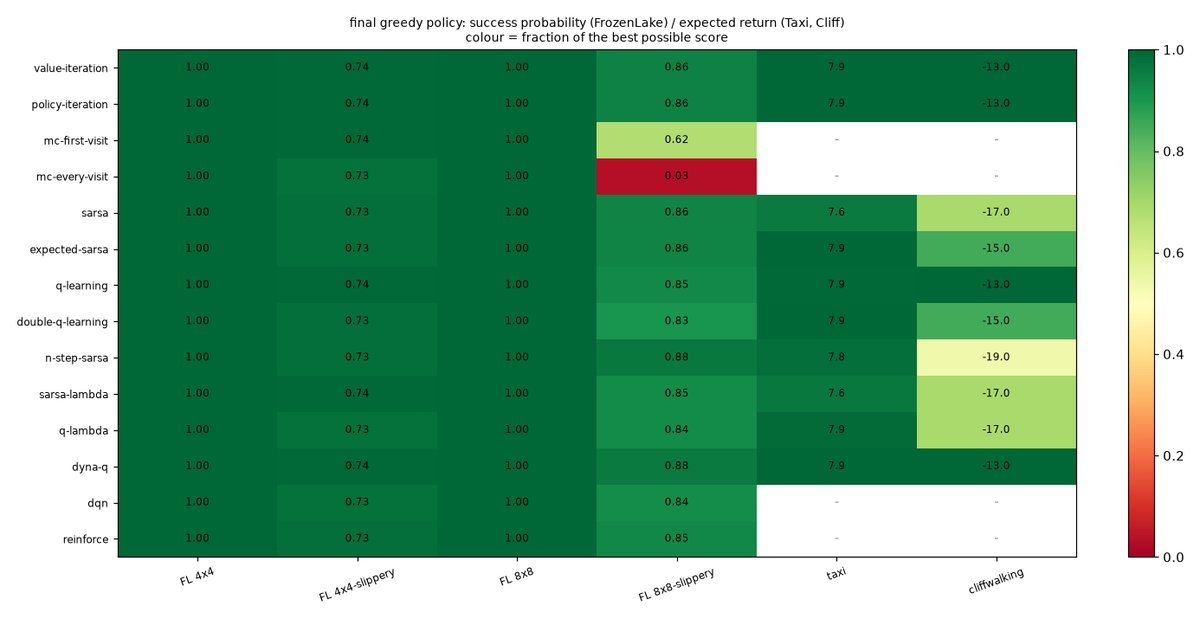
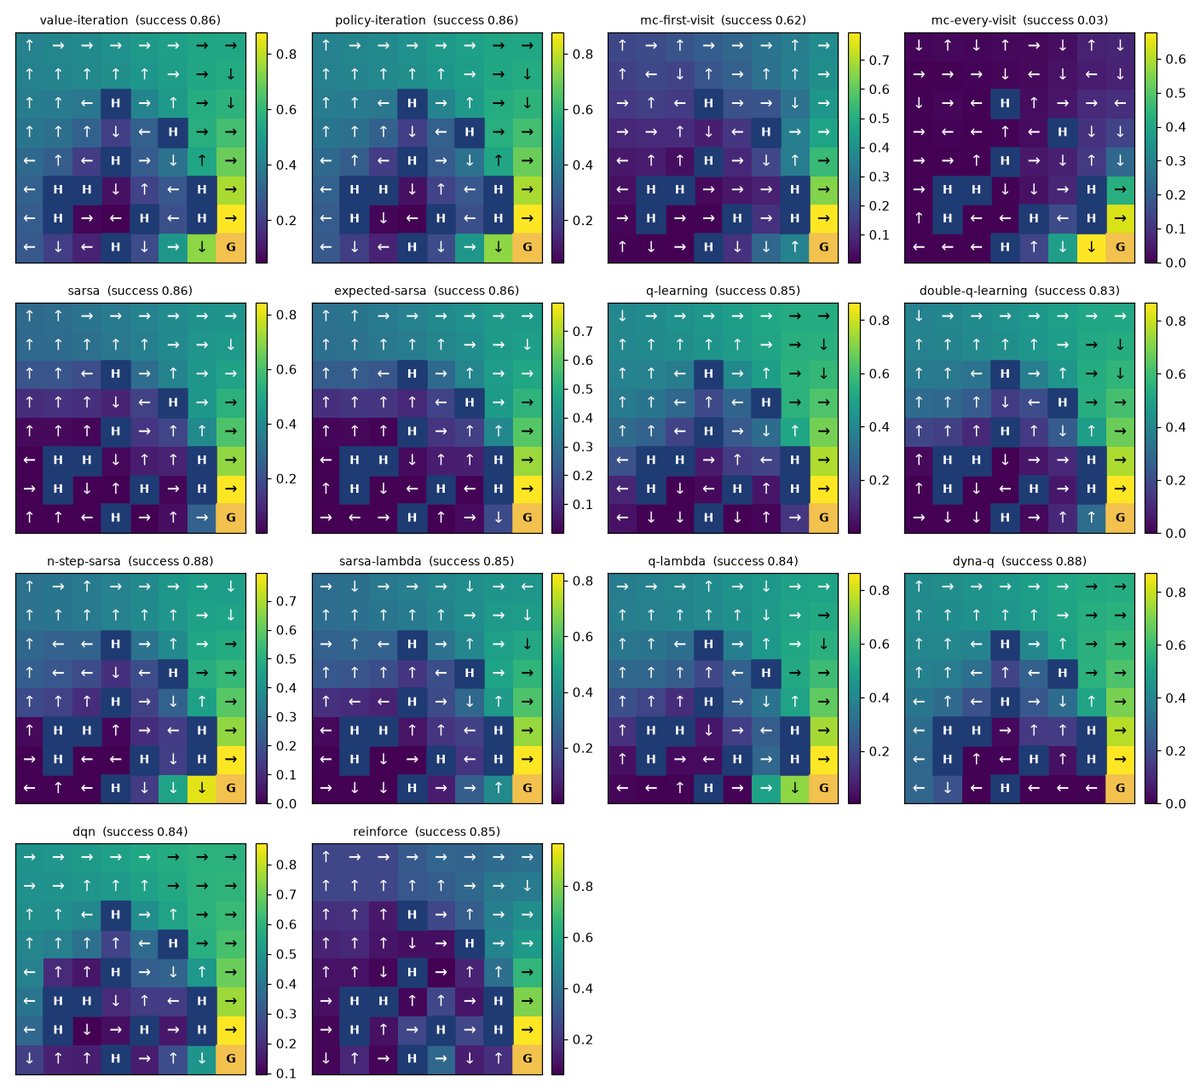
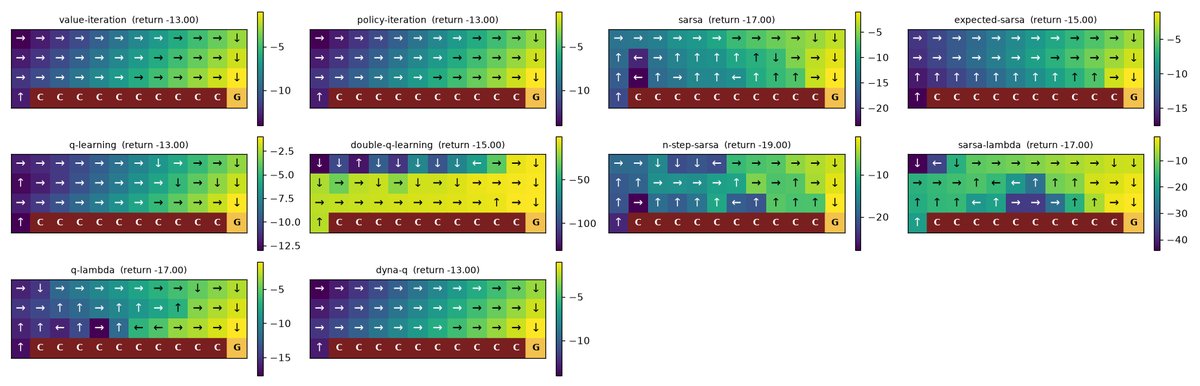
تؤكد التشغيلات ما في الكتاب وتضع له أرقامًا. تبلغ جميع الطرق الحل الأمثل على البحيرة 4x4 الزلقة، لكن Dyna-Q يحتاج 240 حلقة بينما يحتاج مونت كارلو every-visit إلى 19,200. وعلى البحيرة 8x8 الزلقة يفشل مونت كارلو فشلًا واضحًا (نسبة نجاح 0.62 و0.03) بينما تبلغ طرق TD 0.83-0.88. وعلى CliffWalking يجد Q-learning مسار الحافة بعائد -13 ويحافظ SARSA على مسار أكثر أمانًا بعائد -17، تمامًا كما في المثال 6.6 من الكتاب.
السؤال
حين تكون المسألة صغيرة بما يكفي لحساب السياسة المثلى من النموذج مباشرة، إلى أي حد تقترب منها كل طريقة كلاسيكية، وكم حلقة تحتاج لبلوغها؟
أهم الميزات
- أربع عشرة طريقة خلف خيار واحد
--method، مجمّعة في البرمجة الديناميكية ومونت كارلو وTD والخطوات المتعددة والآثار والتخطيط والطرق العصبية، على ست بيئات: FrozenLake بحجمي 4x4 و8x8 مع الانزلاق ودونه، وTaxi، وCliffWalking. - تقييم دقيق لأي سياسة انطلاقًا من نموذج الانتقال P مع الحد الزمني، إضافة إلى تقييم بالمحاكاة على 1,000 حلقة يتوافق معه ضمن خطأ مونت كارلو.
- سقف بالبرمجة الديناميكية ذات الأفق المحدود لكل بيئة (0.744 و0.913 على البحيرات الزلقة، و7.93 على Taxi، و-13 على CliffWalking)، كي تُقرأ كل نتيجة على أنها مسافة إلى الحل الأمثل.
- أداة Tracker تقيّم السياسة الجشعة عند 100 نقطة في كل تشغيل وتُبلغ عن عدد الحلقات حتى بلوغ الهدف، مع منحنيات التعلم وعوائد التدريب المباشرة.
- خرائط حرارية للقيم وأسهم للسياسة وجداول Q ولوحة نتائج لكل تشغيل؛ وصور GIF قبل التدريب وبعده مولّدة من إطارات rgb_array في Gymnasium مع تمييز الخلايا التي زارها العميل.
- يشغّل
frozenlake-compareأي مجموعة من الطرق على بيئة واحدة ويكتب جدول المقارنة؛ وتستغرق المجموعات الست كلها 12 دقيقة على خيط CPU واحد. - 40 اختبارًا بـ pytest وستة نصوص أمثلة تتبع ترتيب الكتاب، إضافة إلى دفتر Kaggle/Colab يعرض شيفرة كل طريقة بجانب تشغيلها.
كيف يعمل
كشف النموذج
يُقرأ جدول الانتقال P(s', r | s, a) لكل بيئة من Gymnasium مرة واحدة. ولا يستخدمه إلا البرمجة الديناميكية والمقيِّم الدقيق؛ أما العملاء المتعلمون فلا يرون إلا env.step().
البرمجة الديناميكية
يمسح تكرار القيمة معادلة بيلمان للأمثلية على جميع الحالات حتى تتوقف القيم عن التغير (39 مسحًا على البحيرة 8x8 الزلقة)؛ ويتناوب تكرار السياسة بين التقييم الدقيق والتحسين الجشع (8 مسوح).
التعلم من الحلقات
يحرّك مونت كارلو Q(s, a) نحو العائد الكامل؛ وتعتمد SARSA وexpected SARSA وQ-learning وdouble Q-learning على التمهيد (bootstrapping) بخطوة واحدة نحو هدف خاص بكل منها؛ وتوزّع SARSA متعدد الخطوات وSARSA(lambda) وQ(lambda) كل خطأ TD على الأزواج التي زيرت مؤخرًا؛ ويعيد Dyna-Q تشغيل نموذج عدّ متعلَّم 10 مرات لكل خطوة حقيقية.
النسخ العصبية
يدرّب DQN شبكة Q من نوع MLP على حالات one-hot مع مخزن إعادة التشغيل (replay buffer) وشبكة هدف؛ ويدرّب REINFORCE سياسة softmax مع خط أساس متعلَّم للقيمة ويأخذ متوسط 10 حلقات لكل تحديث، ودون ذلك يعلق عند 60 % على البحيرة 4x4 الزلقة.
التقييم الدقيق ثم الفعلي
تُحسب احتمالية نجاح السياسة الجشعة أو عائدها المتوقع من P ضمن الحد الزمني، ثم تُقاس مجددًا على 1,000 حلقة حقيقية؛ وأول نقطة من نقاط التقييم المئة تبلغ فيها الدرجة الدقيقة الهدف تعطي عدد الحلقات حتى بلوغ الهدف.
أمثلة
المدخل
frozenlake-train --env frozenlake-4x4-slippery --method q-learning
المخرج
runs/frozenlake-4x4-slippery/q-learning/ (agent.npz, summary.json, history.json, run.png): 10,000 episodes in 5.5 s, target reached after 1,400 episodes, exact greedy success 0.740, rollout success 0.729 over 1,000 episodes
التقنيات المستخدمة
جميع الخوارزميات والمقيِّم الدقيق وواجهات سطر الأوامر
جداول Q ونموذج الانتقال P والتقييم الدقيق
FrozenLake وTaxi وCliffWalking (toy-text) ومُصيِّر rgb_array لصور GIF
DQN وREINFORCE على حالات one-hot
الخرائط الحرارية وأسهم السياسة ومنحنيات التعلم ولوحة النتائج
40 اختبارًا، منها التوافق بين التقييم الدقيق والتقييم بالمحاكاة
ما تعلمته
- تقييم السياسة الجشعة تقييمًا دقيقًا من نموذج الانتقال يُزيل ضجيج المحاكاة، وهذا ما يجعل «عدد الحلقات حتى بلوغ الهدف» رقمًا قابلًا للقياس على بحيرة زلقة
- ينهار التحكم بطريقة مونت كارلو في الحلقات الطويلة العشوائية: مع 50-200 خطوة زلقة لكل عائد، لا يتعلم مونت كارلو every-visit أبدًا سياسة صالحة على 8x8، بينما ينجح TD أحادي الخطوة في ذلك
الحدود
- بذرة عشوائية واحدة لكل تشغيل: الفروق ببضعة أجزاء من المئة بين الطرق على البحيرات الزلقة تقع ضمن هامش الضجيج
- لم تُشغَّل Taxi وCliffWalking إلا بطرق DP وTD وDyna-Q (10 من أصل 14)
الكلمات المفتاحية
التعلم المعزز · التعلم المعزز الجدولي · FrozenLake · Taxi · CliffWalking · Gymnasium · البرمجة الديناميكية · تكرار القيمة · تكرار السياسة · التحكم بطريقة مونت كارلو · SARSA · Q-learning · آثار الأهلية · Dyna-Q · Sutton وBarto