GAN Workbench
Dix variantes de GAN sur une seule boucle d’entraînement
Dix variantes de GAN derrière une seule boucle d’entraînement : mêmes données, même budget, mêmes métriques, seule la méthode change.
- FID cGAN 29,6
- IoU pix2pix 0,977
- 8 GAN comparés
Construit avec PyTorchtorchvisionMatplotlib
 pytest
 Kaggle
Présentation
Un GAN, ce sont deux réseaux entraînés l’un contre l’autre : un générateur qui transforme du bruit en images et un discriminateur qui essaie de les distinguer des vraies. Depuis 2014, ce jeu a été rafistolé de nombreuses fois avec de nouvelles fonctions de perte, de nouveaux réseaux et de nouvelles façons de tenir le discriminateur en respect, et les articles se comparent rarement dans les mêmes conditions. Je voulais voir chaque correctif agir isolément, j’ai donc écrit dix variantes en PyTorch pur : le GAN original, DCGAN, le GAN conditionnel, ACGAN, LSGAN, WGAN, WGAN-GP, SNGAN (hinge loss avec spectral norm), pix2pix et CycleGAN.
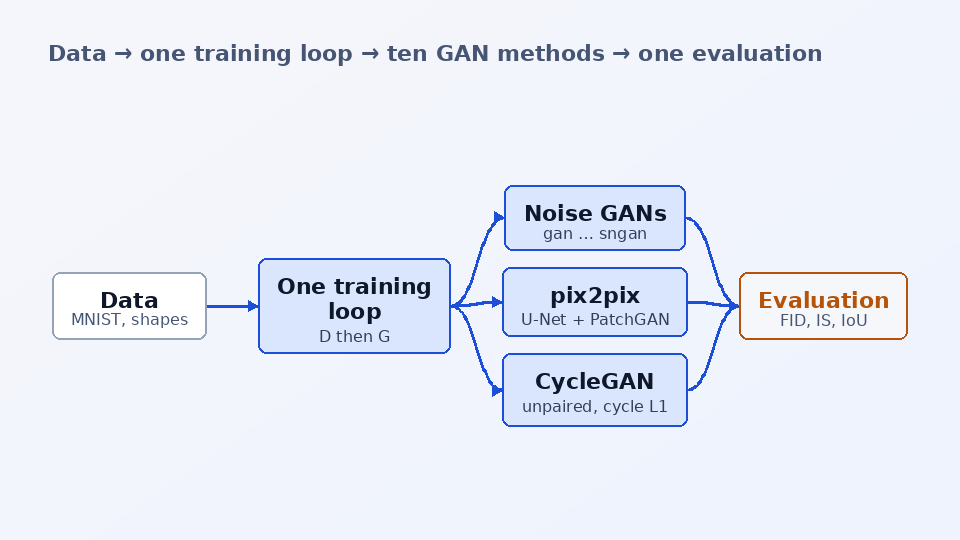
Elles partagent une seule boucle d’entraînement, un seul pipeline de données et une seule évaluation. Une méthode est un petit objet qui définit un pas du discriminateur et un pas du générateur ; la boucle décide quand ils s’exécutent et ce qui est mesuré, si bien que changer de méthode tient en un flag et que chaque run reçoit les mêmes graines, le même ordre des données et le même nombre de mises à jour du générateur. Les réseaux sont volontairement petits (0.1-3 M paramètres) pour qu’on puisse observer chaque mécanisme sur un CPU en quelques minutes, et un notebook Kaggle/Colab fait tourner le même code plus longtemps sur GPU.
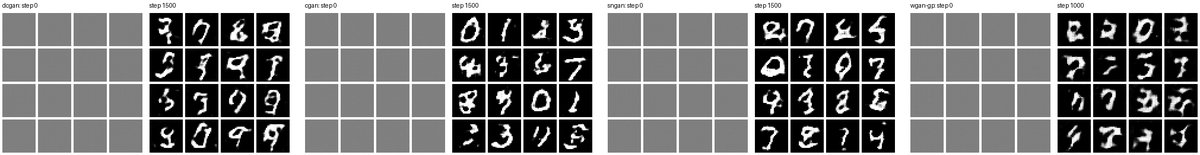
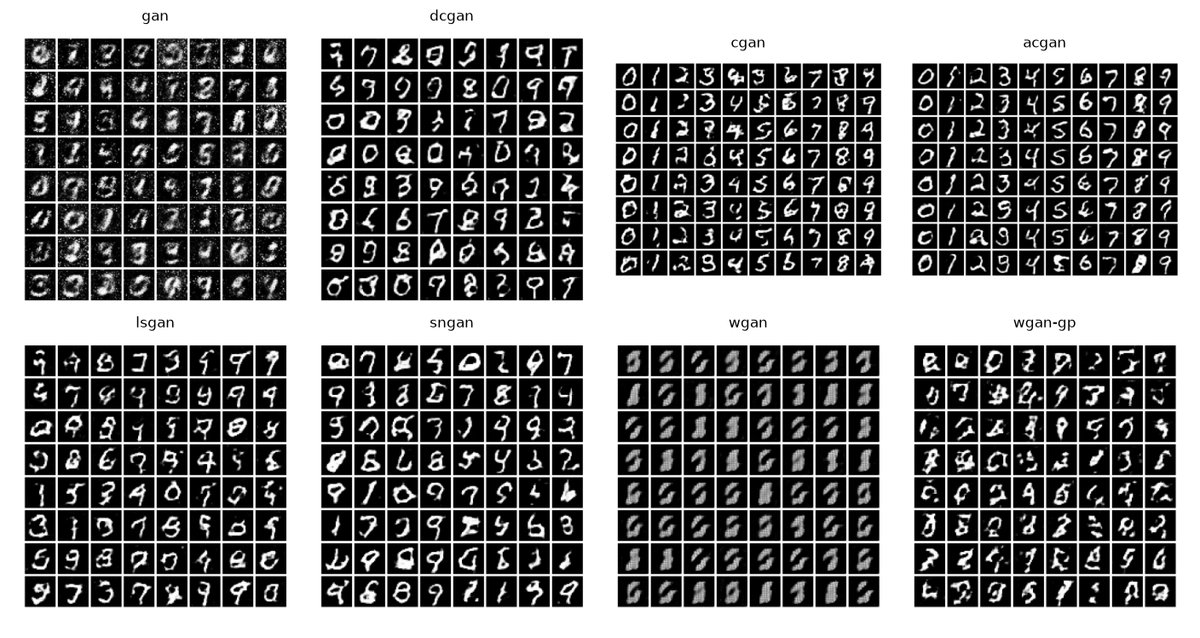
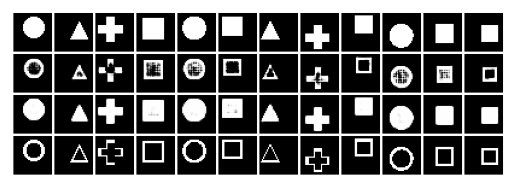
Sur MNIST, le conditionnement l’emporte (FID cGAN 29.6, ACGAN 44.1), la spectral norm avec la hinge loss est la meilleure méthode non conditionnelle (57.5), et le WGAN avec weight clipping n’arrive pas à s’entraîner dans le budget (1035.5) tant que la pénalité de gradient ne remplace pas le clipping (127.2). Sur les formes synthétiques, pix2pix apprend la conversion photo-vers-masque presque parfaitement (IoU 0.977), tandis que CycleGAN trouve le raccourci de « stéganographie » bien connu et n’atteint qu’un IoU de 0.28. Le dépôt est né de deux notebooks de cours ; leurs onze bugs, dont des optimiseurs construits pour des réseaux remplacés ensuite, sont documentés et couverts par des tests.
La question
Si dix variantes de GAN partagent les mêmes données, le même budget, la même boucle et les mêmes métriques, lesquelles de leurs différences (fonction de perte, conditionnement, contrôle de Lipschitz, convolutions) comptent vraiment sur un run à l’échelle d’un CPU ?
Fonctionnalités clés
- Dix méthodes derrière un seul flag --method (gan, dcgan, cgan, acgan, lsgan, wgan, wgan-gp, sngan, pix2pix, cyclegan), chacune avec ses propres réseaux, fonction de perte, conditionnement, contrôle de Lipschitz et réglages d’optimiseur par défaut.
- Des astuces communes sous forme de flags de la même boucle : label smoothing, TTUR, n pas du critique, un générateur EMA, la pénalité R1, le feature matching et la perte saturante d’origine.
- Une évaluation pensée pour des chiffres de 28 px : une FID sur les features d’un classifieur et un analogue de l’Inception Score issus d’un petit CNN MNIST (98.6% de précision en test), la couverture des modes, la précision des labels, ainsi que L1, IoU de masque et L1 de cycle pour les méthodes image-vers-image.
- Quatre commandes, gans-data, gans-train, gans-sample (grilles, grilles par classe, interpolations latentes, traductions) et gans-eval, plus six scripts d’exemple exécutables.
- Trois jeux de données synthétiques hors ligne (formes, formes appariées pour pix2pix, formes non appariées pour CycleGAN) où la bonne réponse est connue exactement, de sorte que la qualité image-vers-image devient un chiffre plutôt qu’une appréciation.
- Des courbes d’entraînement en trois panneaux : les pertes, D(x) face à D(G(z)), et le ratio réel de mise à jour par pas de chaque réseau, mesuré sur le pas Adam effectif.
- 43 tests CPU en une minute environ, dont « DCGAN apprend une seule image » et « pix2pix surapprend un batch », qui prouvent que les gradients atteignent les bons poids.
Comment ça marche
Une seule boucle
Chaque pas exécute n_critic mises à jour du discriminateur puis une mise à jour du générateur, met éventuellement à jour une copie EMA de G, et journalise les pertes, D(x), D(G(z)) et les ratios de mise à jour. La boucle décide quand les choses s’exécutent ; la méthode décide de ce qu’elles sont.
Une méthode, ce sont deux pas
NoiseGAN, Pix2Pix et CycleGAN définissent chacun un pas de D et un pas de G à partir d’une table METHODS qui fixe les réseaux, la perte (BCE, moindres carrés, Wasserstein, hinge), le conditionnement, le contrôle de Lipschitz et les réglages d’optimiseur par défaut.
Tenir D en respect
DCGAN s’appuie sur la BatchNorm ; WGAN écrête chaque poids du critique à ±0.01 après chaque pas ; WGAN-GP pénalise la norme du gradient sur des interpolations réel/faux et supprime la BatchNorm ; SNGAN divise chaque couche de D par sa plus grande valeur singulière.
Image vers image
pix2pix utilise un générateur U-Net, un discriminateur PatchGAN qui juge des paires (entrée, sortie) et un terme L1 pondéré par 100x. CycleGAN utilise deux U-Net, deux PatchGAN, une perte aux moindres carrés et un L1 de cycle pondéré par 10x, sans aucune paire.
Évaluer
5,000 échantillons sont comparés à 5,000 images de test dans l’espace de features à 128 dimensions du petit classifieur : distance de Fréchet, un analogue de l’IS, le nombre de classes qui reçoivent au moins 1/(4K) des échantillons, et la précision des labels pour les modèles conditionnels.
Exemples
Entrée
gans-train --method cgan --dataset mnist --steps 2000 && gans-eval checkpoints/cgan/last.pt
Sortie
FID (clf) 29.64, IS (clf) 8.02, modes 10/10, label accuracy 87.5% (0.27 M / 0.04 M parameters, 9.7 min on one CPU thread)
Stack technique
Réseaux, fonctions de perte, boucle d’entraînement et évaluation
Téléchargement de MNIST, FashionMNIST et CIFAR-10
Courbes d’entraînement, grilles d’échantillons et figures comparatives
43 tests CPU, dont les deux tests de bout en bout « apprend »
Notebook pour des runs GPU plus longs sur MNIST, CIFAR-10 et Facades
Ce que j’ai appris
- Le conditionnement est le gain le plus important : donner le label à G et à D supprime la partie la plus difficile du problème, choisir quel chiffre dessiner
- Les convolutions comptent plus que la fonction de perte : la même perte BCE passe d’une FID de 399 avec des MLP à 94 avec les réseaux DCGAN
- CycleGAN peut satisfaire sa perte de cycle en cachant l’entrée dans un motif haute fréquence à peine visible au lieu d’apprendre la vraie correspondance
Limites
- Tous les chiffres viennent de courts runs CPU mono-thread (2,000 pas du générateur, 0.1-3 M paramètres), pas de benchmarks ; la FID utilise un petit classifieur MNIST au lieu d’Inception et n’est donc comparable qu’à l’intérieur du dépôt
- CycleGAN n’est que partiellement résolu avec ce budget (IoU 0.28 par rapport au vrai contour)
Mots-clés
GAN · réseaux antagonistes génératifs · DCGAN · GAN conditionnel · ACGAN · LSGAN · WGAN · WGAN-GP · pénalité de gradient · normalisation spectrale · hinge loss · pix2pix · CycleGAN · traduction image-vers-image · effondrement de modes · FID · MNIST · PyTorch · modèles génératifs