YOLO Object Detector
YOLOv1 depuis l’article, en PyTorch
Donnez-lui une image et il trace une boîte autour de chaque objet qu’il connaît, avec sa classe, en une seule passe.
- mAP@0.5 0,952
- 8,3 M paramètres, ~25 min sur CPU
- Réseau de l’article : 271,7 M paramètres
Construit avec PyTorchtorchvision
 pytestMatplotlib
 NumPy
 Kaggle
 Google Colab
Présentation
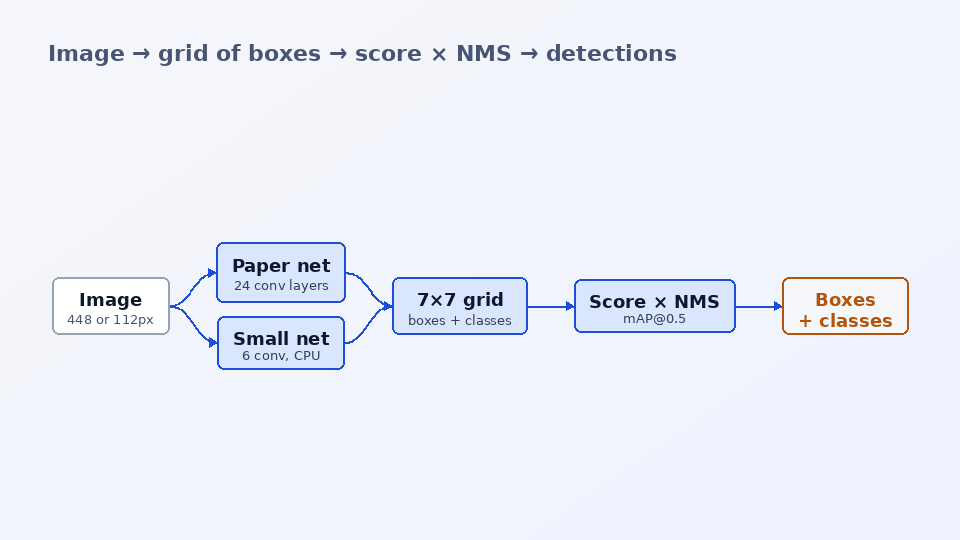
YOLOv1 transforme la détection d’objets en une seule régression : l’image est découpée en une grille 7 × 7, et la cellule qui contient le centre d’un objet prédit sa classe et deux boîtes candidates avec une confiance. Le réseau voit toute l’image d’un coup, donc la détection tient en une seule passe avant. J’en ai écrit chaque partie en PyTorch depuis l’article : le réseau à 24 couches, la perte en somme des carrés des erreurs, l’encodage des cibles, le décodage, la suppression des non-maxima et le mAP, sans bibliothèque de détection ni poids pré-entraînés.
Le projet a commencé en 2023 sous forme de deux notebooks entraînés sur les panneaux routiers Mapillary. En le réécrivant comme package testé, j’ai découvert que les CSV de test et de validation étaient des sous-ensembles du CSV d’entraînement, donc que chaque mAP avait été mesuré sur des images d’entraînement ; que les classes au-delà de 20 n’étaient jamais comptées ; que les boîtes étaient tracées depuis leur centre comme s’il s’agissait d’un coin ; et que la deuxième boîte de chaque cellule n’était jamais utilisée au test. Le dossier legacy conserve les notebooks et la liste complète des corrections.
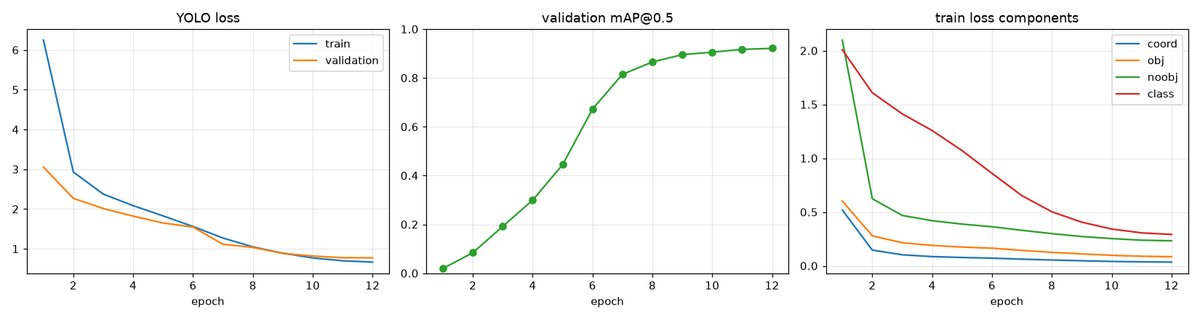
Pour montrer que le pipeline apprend sans pré-entraînement ImageNet, j’ai ajouté deux jeux de données qui tournent sur CPU : des formes synthétiques et des chiffres MNIST dispersés sur un canevas. Un petit réseau de 8,3M de paramètres atteint un mAP@0.5 de validation de 0,952 sur les formes et 0,921 sur les chiffres en environ 25 minutes chacun. PASCAL VOC et tout dossier au format YOLO sont pris en charge par la même commande et un notebook Kaggle / Colab, mais ces runs GPU ne sont pas rapportés.
La question
Un détecteur à passe unique écrit sans bibliothèque de détection ni poids pré-entraînés peut-il apprendre à trouver et classer des objets, et comment prouver que le code de la perte, du décodage et du mAP est juste ?
Fonctionnalités clés
- Deux architectures derrière un seul drapeau : le réseau de l’article à 24 conv + 2 FC (271,7M de paramètres, 448 px) et un petit réseau à 6 conv (8,3M de paramètres, 112 px) pour les runs CPU, tous deux avec batch norm et un multiplicateur de largeur.
- La perte de l’article pour un nombre quelconque de boîtes par cellule : le prédicteur de meilleur IoU est responsable, λ_coord = 5 et λ_noobj = 0,5, tailles de boîtes en racine carrée, et les quatre composantes journalisées à chaque époque.
- Décodage avec le score par classe confiance × P(classe), suppression des non-maxima par classe et mAP@0.5 à la façon VOC avec interpolation sur tous les points.
- Quatre jeux de données via un seul drapeau : formes générées à la volée, chiffres MNIST sur un canevas, PASCAL VOC 2007 / 2012, et tout dossier images/ + labels/ au format texte YOLO avec une partition entraînement / validation à graine fixe.
- Augmentation à la façon de l’article (échelle, translation, retournement, jitter de luminosité et de saturation) qui déplace et rogne les boîtes, avec un interrupteur pour la désactiver.
- Trois commandes : yolov1-train écrit best.pt, les courbes d’historique, une grille de prédictions et l’AP par classe ; yolov1-evaluate rapporte le mAP ; yolov1-predict trace les boîtes sur des fichiers ou un flux webcam.
- Une suite pytest qui vérifie l’IoU, l’encodage et le décodage, chaque composante de la perte, le mAP et la NMS contre des valeurs calculées à la main, plus une vérification de surapprentissage sur quatre images.
Comment ça marche
Encoder les cibles
Chaque boîte de vérité terrain va dans la cellule de la grille qui contient son centre, sous forme d’un décalage dans la cellule, d’une taille relative à l’image et d’une classe one-hot, ce qui donne un tenseur S × S × (C + 5B).
Une seule passe avant
Des blocs conv, batch-norm et leaky-ReLU avec quatre max-pools réduisent l’image à une carte 7 × 7 ; deux couches entièrement connectées produisent d’un coup chaque boîte, confiance et probabilité de classe.
Perte en somme des carrés des erreurs
Pour chaque objet, la boîte de plus haut IoU est responsable et est tirée vers les coordonnées cibles et vers une confiance de 1 ; tout autre prédicteur est poussé vers une confiance de 0, pondéré par λ_noobj ; les probabilités de classe sont régressées dans les cellules contenant un objet.
Décoder et supprimer
Chaque boîte reçoit le score confiance × meilleure probabilité de classe ; les boîtes sous le seuil sont écartées et les boîtes de même classe qui chevauchent une boîte retenue au-delà de l’IoU de NMS sont supprimées.
Mesurer le mAP
Par classe, les détections sont triées par score, appariées à une vérité terrain non encore appariée à IoU ≥ 0,5, et l’AP est l’aire sous l’enveloppe de précision ; le mAP moyenne les classes qui ont une vérité terrain.
Exemples
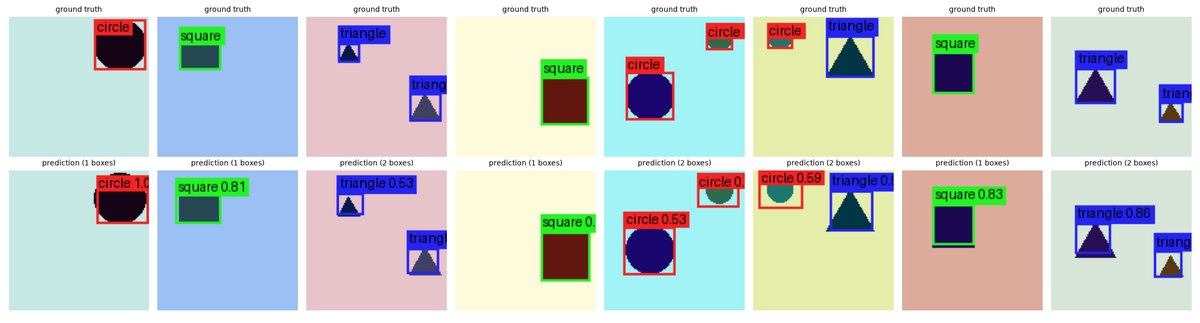
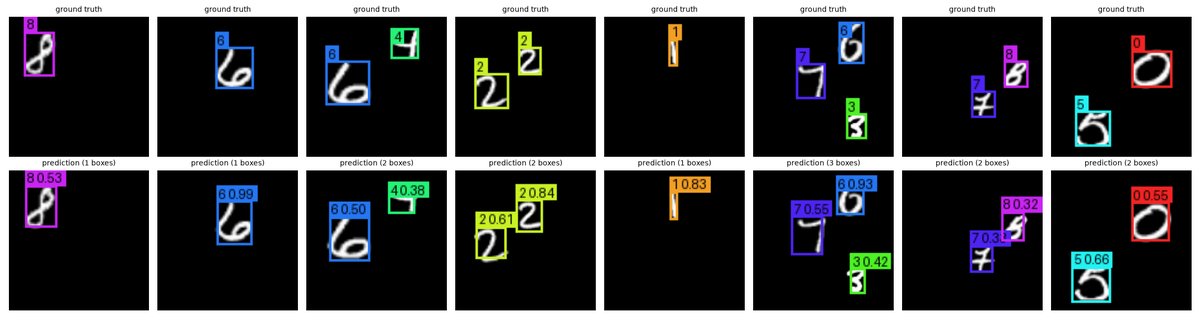
Entrée
yolov1-train --dataset mnist --root data --image-size 112 --arch small --hidden 512 --dropout 0.3 --no-augment --train-size 10000 --val-size 500 --epochs 12 --batch-size 32 --lr 1e-3 --output-dir checkpoints/mnist
Sortie
checkpoints/mnist/: best.pt (highest validation mAP), last.pt, history.json, history.png, predictions.png, best_metrics.json — validation mAP@0.5 0.921 after 12 epochs, about 26 minutes on an 8-core CPU.
Stack technique
Le réseau, la perte, le décodage, la NMS, le mAP et la boucle d’entraînement
Téléchargements de MNIST et PASCAL VOC et transformations d’images
Vérifications calculées à la main des boîtes, de la perte, des métriques, des données et un test de surapprentissage
Courbes d’entraînement et grilles de prédictions
Génération des formes et gestion des boîtes
Notebook d’entraînement GPU pour VOC et les jeux de données au format YOLO
Le même notebook, généré depuis src par build_notebook.py
Ce que j’ai appris
- Un détecteur incapable de mémoriser quatre images a un bug dans ses données, sa perte ou son décodage, donc le test de surapprentissage est le plus utile de la suite
- L’augmentation doit respecter les étiquettes : un chiffre retourné horizontalement est un autre chiffre, donc l’entraînement MNIST se fait sans retournements
Limites
- Aucun entraînement PASCAL VOC ou Mapillary n’est rapporté : le réseau de l’article exige un GPU, et les chiffres publiés sont de courts entraînements sur CPU avec des données simples
- Les notebooks de 2023 dont tout est parti mesuraient le mAP sur des images d’entraînement, donc aucun de leurs chiffres n’est comparable avec le package
Mots-clés
YOLO · YOLOv1 · détection d’objets · You Only Look Once · PyTorch · suppression des non-maxima · NMS · précision moyenne (mAP) · mAP · PASCAL VOC · MNIST · panneaux routiers Mapillary · vision par ordinateur · apprentissage profond