SegNet Semantic Segmentation
Étiquetage pixel par pixel avec unpooling par indices de pooling
Donnez-lui une photo et il étiquette chaque pixel : route, voiture, panneau de signalisation, animal ou fond.
- 29,5 M paramètres, comme dans l’article
- 3 jeux de données
Construit avec PyTorchtorchvision
 pytestMatplotlib
 NumPy
 Kaggle
 Google Colab
Présentation
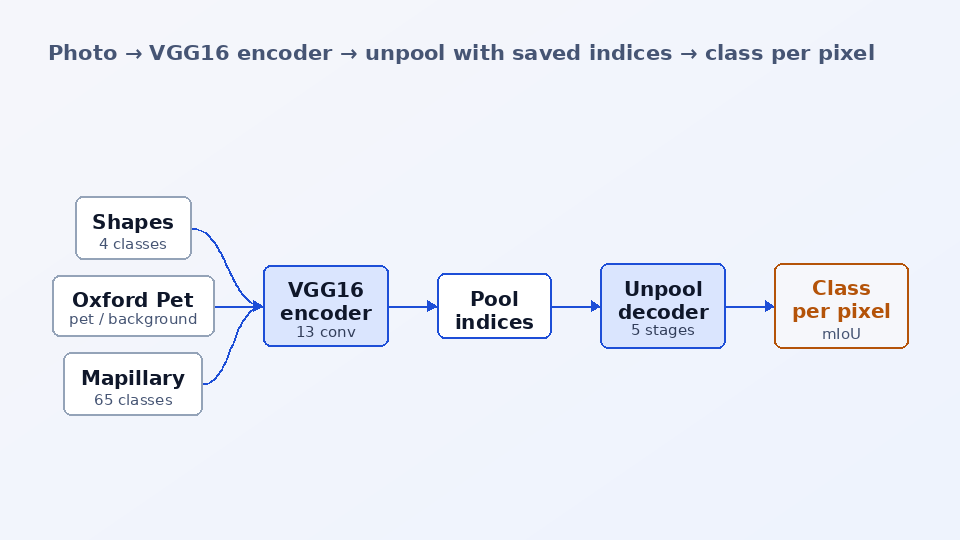
La segmentation sémantique attribue une classe à chaque pixel. SegNet le fait avec un encodeur-décodeur : les 13 couches de convolution de VGG16 réduisent l’image d’un facteur 32, puis un décodeur miroir la ramène à sa taille d’origine. Son idée propre tient à la façon dont le décodeur suréchantillonne. Chaque max-pool de l’encodeur enregistre aussi lequel des quatre pixels de chaque fenêtre contenait le maximum, et le décodeur replace chaque valeur à cette position. Les frontières restent nettes et le décodeur stocke quelques bits par fenêtre au lieu de cartes de caractéristiques complètes.
Je l’ai implémenté en PyTorch pur, sans poids pré-entraînés ni bibliothèque de segmentation : l’encodeur VGG16-BN, le décodeur à max-unpooling par indices, une perte d’entropie croisée plus soft dice qui ignore les pixels non étiquetés, la précision pixel et le mIoU calculés à partir d’une matrice de confusion sur l’ensemble du jeu de validation. La largeur est un seul nombre : le même code donne le modèle à 29.5M paramètres de l’article sur GPU ou un modèle à 1.8M paramètres sur CPU.
Le projet a commencé en 2023 comme un notebook TensorFlow sur les panneaux de signalisation de Mapillary Vistas. Le portage a révélé plusieurs bugs : le jeu d’entraînement avait été écrasé par le jeu de validation, les PNG de labels en palette étaient décodés en niveaux de gris, l’image et son masque étaient retournés indépendamment, et la perte était une MSE sur les identifiants de classe. Le package corrige chacun d’eux et conserve le notebook dans un dossier legacy avec la liste. La suite de tests vérifie qu’un petit SegNet mémorise quatre images de formes ; les chiffres de runs plus longs ne sont pas encore publiés.
La question
Que fait réellement l’unpooling par indices de pooling de SegNet, et une implémentation from scratch sans poids pré-entraînés peut-elle apprendre à étiqueter chaque pixel sur des images jouets et réelles ?
Fonctionnalités clés
- Encodeur VGG16 : 13 couches conv → batch-norm → ReLU en 5 étages, chacun terminé par un max-pool 2 × 2 qui renvoie aussi ses indices.
- Décodeur miroir : 5 étages de max-unpooling avec les indices correspondants de l’encodeur suivis de convolutions, puis une conv 1 × 1 vers un logit par classe ; toute taille d’entrée à partir de 32 × 32 fonctionne.
- Un seul réglage de largeur : base_channels 64 donne les 29.5M paramètres de l’article, 32 donne 7.4M pour un petit GPU, 16 donne 1.8M pour un CPU ; dropout optionnel sur la carte la plus profonde comme dans Bayesian SegNet.
- Perte et métriques dans un seul fichier : entropie croisée plus un terme soft dice pondéré pour les petites classes, précision pixel et mIoU, avec le label 255 ignoré partout.
- Trois jeux de données via une seule option : formes générées à la volée, Oxford-IIIT Pet téléchargé automatiquement, et Mapillary Vistas avec les 65 classes ou un sous-ensemble choisi comme l’avant et l’arrière des panneaux de signalisation.
- Boucle d’entraînement avec AdamW, warmup puis calendrier cosinus, clipping du gradient, autocast float16 sur CUDA, sauvegarde du checkpoint au meilleur mIoU et reprise des sessions Kaggle interrompues.
- Une suite pytest : taille de sortie égale à la taille d’entrée, nombre de paramètres de l’article, au plus une valeur non nulle par fenêtre après unpooling, décodage des labels en palette, et un test de surapprentissage sur quatre images.
Comment ça marche
Encoder et mémoriser les maxima
Cinq étages de conv, batch-norm et ReLU, chacun suivi d’un max-pool 2 × 2, réduisent une image H × W à H/32 × W/32 ; chaque pool renvoie aussi lequel de ses quatre pixels contenait le max.
Unpooling avec les indices
Chaque étage du décodeur replace ses valeurs aux positions enregistrées, laisse les trois autres positions de chaque fenêtre à zéro, et des convolutions complètent la carte creuse.
Un logit par classe
Une dernière convolution 1 × 1 donne num_classes logits par pixel ; l’entraînement utilise l’entropie croisée softmax plus un terme soft dice optionnel, et la prédiction prend l’argmax.
Mesurer sur tout le split
Une matrice de confusion est accumulée sur chaque pixel de validation ; la précision pixel et le mIoU en sont tirés, et le checkpoint au meilleur mIoU est conservé.
Choisir les données
Les formes vérifient le pipeline en quelques minutes, Oxford-IIIT Pet fournit les premières vraies photos, et les labels en palette de Mapillary Vistas passent par une table de correspondance vers toutes les classes ou un sous-ensemble choisi.
Exemples
Entrée
segnet-train --dataset shapes --image-size 64 --base-channels 16 --shapes-train-size 1000 --epochs 12 --lr 3e-3 --output-dir checkpoints/shapes
Sortie
checkpoints/shapes/: best.pt (best validation mIoU, with configs and class names), last.pt, history.json (per-epoch train / val loss, pixel accuracy, mIoU, lr), history.png and predictions.png (image / ground truth / prediction for 4 validation images).
Entrée
segnet-predict --checkpoint checkpoints/pets/best.pt --images cat.jpg dog.jpg
Sortie
outputs/cat_mask.png, outputs/cat_overlay.png, outputs/dog_mask.png, outputs/dog_overlay.png
Stack technique
Encodeur, décodeur à unpooling par indices, fonction de perte, métriques et boucle d’entraînement
Téléchargement d’Oxford-IIIT Pet et transformations d’images
Vérifications du modèle, des données et des métriques, plus le test de surapprentissage
Courbes d’entraînement et grilles de prédictions
Génération des formes et tables de correspondance des labels
Notebook d’entraînement sur GPU pour Pet et Mapillary Vistas
Le même notebook
Ce que j’ai appris
- L’unpooling avec les indices sauvegardés remet chaque valeur à l’endroit d’où venait son maximum, ce qui garde des frontières nettes sans stocker les cartes de caractéristiques complètes de l’encodeur comme le fait U-Net
- Le notebook de 2023 s’entraînait sur son split de validation, décodait les labels en palette comme des niveaux de gris et régressait les identifiants de classe avec une MSE ; le portage n’a eu de sens qu’une fois ces erreurs corrigées et de vraies métriques ajoutées
Limites
- Aucun chiffre de mIoU ou de précision pixel issu d’entraînements complets n’est publié dans le dépôt ; le seul chiffre vérifié est le test de surapprentissage
- Entraînement depuis une initialisation aléatoire : le pré-entraînement VGG16 sur ImageNet de l’article n’est pas utilisé
Mots-clés
SegNet · segmentation sémantique · encodeur-décodeur · max-unpooling · indices de pooling · VGG16 · PyTorch · mIoU · dice loss · Oxford-IIIT Pet · Mapillary Vistas · segmentation des panneaux de signalisation · vision par ordinateur · deep learning