SegNet Semantic Segmentation
توسيم البكسلات بإلغاء التجميع عبر مؤشرات التجميع
أعطه صورة فيوسم كل بكسل فيها: طريق، سيارة، إشارة مرور، حيوان أليف أو خلفية.
- 29.5 M معامل كما في الورقة
- 3 مجموعات بيانات
التقنيات PyTorchtorchvision
 pytestMatplotlib
 NumPy
 Kaggle
 Google Colab
نظرة عامة
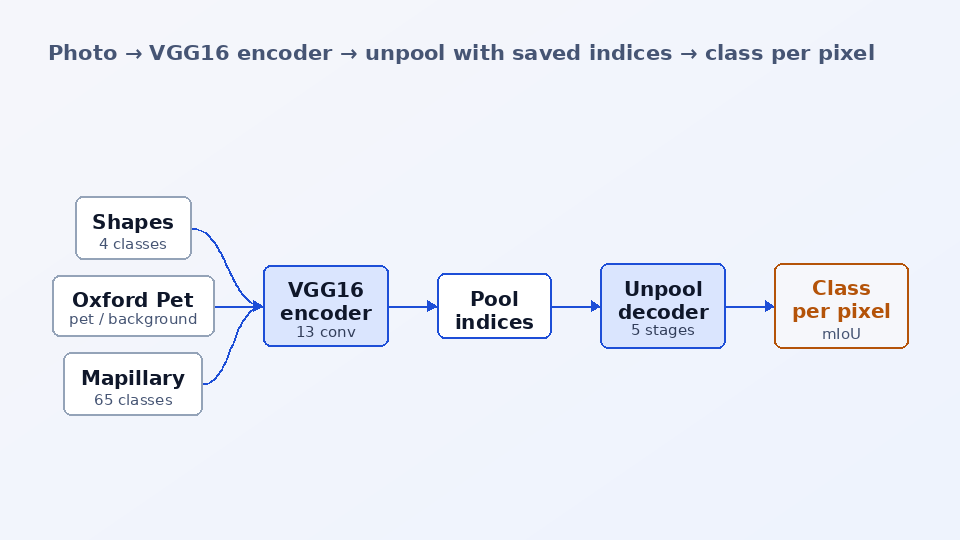
تمنح التجزئة الدلالية (Semantic Segmentation) كل بكسل فئة. يقوم SegNet بذلك عبر بنية مُرمِّز-مفكك (encoder-decoder): تقلّص طبقات الالتفاف الـ 13 في VGG16 الصورة 32 مرة، ثم يعيدها مفكك مرآوي إلى حجمها الكامل. فكرته المميزة هي طريقة رفع الدقة في المفكك: كل عملية max-pool في المُرمِّز تسجّل أيضاً أي البكسلات الأربعة في كل نافذة كان يحمل القيمة القصوى، ثم يعيد المفكك كل قيمة إلى ذلك الموضع. تبقى الحدود حادة، ويخزن المفكك بضع بتات لكل نافذة بدلاً من خرائط سمات كاملة.
نفّذته بـ PyTorch خالصة دون أوزان مدرَّبة مسبقاً ودون مكتبة تجزئة: مُرمِّز VGG16-BN، ومفكك max-unpooling القائم على المؤشرات، ودالة خسارة تجمع الإنتروبيا المتقاطعة وsoft dice وتتجاهل البكسلات غير الموسومة، ودقة البكسل وmIoU المحسوبين من مصفوفة التباس على مجموعة التحقق كاملة. العرض رقم واحد، فالشيفرة نفسها تعطي نموذج الورقة ذا 29.5M معاملاً على GPU أو نموذجاً بـ 1.8M معامل على المعالج المركزي.
بدأ المشروع عام 2023 كدفتر TensorFlow على إشارات المرور في Mapillary Vistas. وكشف نقله عدة أخطاء: كانت مجموعة التدريب قد استُبدلت بمجموعة التحقق، وكانت ملفات PNG لتسميات اللوحة اللونية تُفك كتدرج رمادي، وكانت الصورة وقناعها يُقلبان بشكل مستقل، وكانت الخسارة MSE على معرّفات الفئات. تصلح الحزمة كل واحد منها وتحتفظ بالدفتر في مجلد legacy مع قائمة الأخطاء. تتحقق مجموعة الاختبارات من أن SegNet صغيراً يحفظ أربع صور أشكال؛ أما أرقام التشغيلات الأطول فلم تُنشر بعد.
السؤال
ماذا يفعل فعلياً إلغاء التجميع عبر مؤشرات التجميع (pooling-index unpooling) في SegNet، وهل يستطيع تنفيذ من الصفر بلا أوزان مدرَّبة مسبقاً أن يتعلم توسيم كل بكسل في صور تجريبية وحقيقية؟
أهم الميزات
- مُرمِّز VGG16: 13 طبقة conv ← batch-norm ← ReLU في 5 مراحل، تنتهي كل منها بـ max-pool بحجم 2 × 2 يعيد مؤشراته أيضاً.
- مفكك مرآوي: 5 مراحل من max-unpooling بمؤشرات المُرمِّز المقابلة تليها طبقات التفاف، ثم التفاف 1 × 1 إلى قيمة logit واحدة لكل فئة، فيعمل مع أي حجم إدخال من 32 × 32 فما فوق.
- مقبض عرض واحد: base_channels بقيمة 64 يعطي 29.5M معاملاً كما في الورقة، و32 يعطي 7.4M لـ GPU صغير، و16 يعطي 1.8M للمعالج المركزي؛ مع dropout اختياري على أعمق خريطة كما في Bayesian SegNet.
- الخسارة والمقاييس في ملف واحد: الإنتروبيا المتقاطعة مع حد soft dice موزون للفئات الصغيرة، ودقة البكسل وmIoU، مع تجاهل التسمية 255 في كل مكان.
- ثلاث مجموعات بيانات عبر خيار واحد: أشكال تُولَّد آنياً، وOxford-IIIT Pet يُنزَّل تلقائياً، وMapillary Vistas بكل فئاته الـ 65 أو بمجموعة فرعية مختارة مثل الوجه الأمامي والخلفي لإشارات المرور.
- حلقة تدريب مع AdamW، وإحماء ثم جدول جيب التمام، وقص التدرج، وautocast بدقة float16 على CUDA، وحفظ نقطة الحفظ ذات أفضل mIoU، واستئناف جلسات Kaggle المنقطعة.
- مجموعة اختبارات pytest: حجم الإخراج يساوي حجم الإدخال، وعدد معاملات الورقة، وقيمة غير صفرية واحدة على الأكثر في كل نافذة بعد إلغاء التجميع، وفك تسميات اللوحة اللونية، واختبار سلامة بالإفراط في التخصيص على أربع صور.
كيف يعمل
الترميز وتذكّر القيم القصوى
خمس مراحل من conv وbatch-norm وReLU، يلي كلاً منها max-pool بحجم 2 × 2، تقلّص صورة H × W إلى H/32 × W/32؛ ويعيد كل تجميع أيضاً أي بكسلاته الأربعة كان يحمل القيمة القصوى.
إلغاء التجميع بالمؤشرات
تعيد كل مرحلة من المفكك قيمها إلى المواضع المسجَّلة، تاركةً المواضع الثلاثة الأخرى في كل نافذة صفراً، ثم تملأ طبقات الالتفاف الخريطة المتفرقة.
قيمة logit لكل فئة
يعطي التفاف أخير 1 × 1 عدد num_classes من قيم logit لكل بكسل؛ ويستخدم التدريب إنتروبيا softmax المتقاطعة مع حد soft dice اختياري، ويأخذ التنبؤ قيمة argmax.
القياس على القسم كاملاً
تُجمَّع مصفوفة التباس على كل بكسل تحقق؛ ومنها تُحسب دقة البكسل وmIoU، وتُحفظ نقطة الحفظ ذات أفضل mIoU.
اختيار البيانات
تتحقق الأشكال من خط المعالجة في دقائق، ويقدم Oxford-IIIT Pet أولى الصور الحقيقية، وتُحوَّل تسميات اللوحة اللونية في Mapillary Vistas عبر جدول بحث إلى كل الفئات أو إلى مجموعة فرعية مختارة.
أمثلة
المدخل
segnet-train --dataset shapes --image-size 64 --base-channels 16 --shapes-train-size 1000 --epochs 12 --lr 3e-3 --output-dir checkpoints/shapes
المخرج
checkpoints/shapes/: best.pt (best validation mIoU, with configs and class names), last.pt, history.json (per-epoch train / val loss, pixel accuracy, mIoU, lr), history.png and predictions.png (image / ground truth / prediction for 4 validation images).
المدخل
segnet-predict --checkpoint checkpoints/pets/best.pt --images cat.jpg dog.jpg
المخرج
outputs/cat_mask.png, outputs/cat_overlay.png, outputs/dog_mask.png, outputs/dog_overlay.png
التقنيات المستخدمة
المُرمِّز، ومفكك إلغاء التجميع بالمؤشرات، ودالة الخسارة، والمقاييس، وحلقة التدريب
تنزيل Oxford-IIIT Pet وتحويلات الصور
فحوص النموذج والبيانات والمقاييس، إضافة إلى اختبار سلامة الإفراط في التخصيص
منحنيات التدريب وشبكات التنبؤات
توليد الأشكال وجداول بحث التسميات
دفتر تدريب على GPU لـ Pet وMapillary Vistas
الدفتر نفسه
ما تعلمته
- إلغاء التجميع بالمؤشرات المحفوظة يعيد كل قيمة إلى الموضع الذي جاء منه حدّها الأقصى، فتبقى الحدود حادة دون تخزين خرائط سمات المُرمِّز كاملة كما يفعل U-Net
- كان دفتر 2023 يتدرب على قسم التحقق، ويفك تسميات اللوحة اللونية كتدرج رمادي، ويقوم بانحدار معرّفات الفئات بـ MSE؛ ولم يصبح النقل ذا معنى إلا بعد إصلاح ذلك وإضافة مقاييس حقيقية
الحدود
- لا توجد في المستودع أرقام منشورة لـ mIoU أو دقة البكسل من تشغيلات تدريب كاملة؛ والرقم الوحيد المتحقَّق منه هو اختبار الإفراط في التخصيص
- يتدرب انطلاقاً من تهيئة عشوائية: لا يُستخدم التدريب المسبق لـ VGG16 على ImageNet الوارد في الورقة
الكلمات المفتاحية
SegNet · التجزئة الدلالية · مُرمِّز-مفكك · max-unpooling · مؤشرات التجميع · VGG16 · PyTorch · mIoU · خسارة dice · Oxford-IIIT Pet · Mapillary Vistas · تجزئة إشارات المرور · الرؤية الحاسوبية · التعلم العميق