MyTorcha
إطار عمل للتعلم العميق مبني من الصفر
إطار عمل للتعلم العميق أُعيد بناؤه من المبادئ الأولى: من الاشتقاق التلقائي إلى LSTM والانتباه، مع فحص كل تدرّج.
- 160 اختبارًا
- مطابق لـ PyTorch حتى ~1e-10
- دقة 97.1% على الأرقام (CNN)
التقنيات Python
 NumPy
 pytest
 PyTorch
نظرة عامة
أطر العمل مثل PyTorch تختزل تدريب الشبكة في استدعاء واحد، وهو ما يخفي أيضًا كيفية عملها. MyTorcha يزيل هذه الطبقة: كل تدرّج (gradient) هو شيفرة كتبتها بنفسي واختبار يتحقق منها، وNumPy هي التبعية الوحيدة.
بدأ المشروع كمحرّك اشتقاق تلقائي (autograd) عددي، حيث كل رقم هو عقدة في رسم بياني حسابي. تلك النسخة محفوظة كفصل تعليمي. وهي أيضًا سبب ظهور محرّك ثانٍ في الإطار: طبقة واحدة من 784 إلى 10 تبني 31,427 عقدة عددية لكل صورة. محرّك الموتّرات (Tensor) يطبّق قاعدة السلسلة نفسها على مصفوفات كاملة، وهو ما يجعل النماذج الالتفافية والتكرارية ونماذج الانتباه عملية على المعالج المركزي.
إعادة البناء عنت أولًا اختبار النسخة الأصلية. كشفت فحوص الفروق المحدودة أخطاء حقيقية في الإصدار v1: مشتق لدالة log خاطئ بمعامل يقارب 3، وعُقد تتساوى بحسب القيمة فتُدمج بصمت أثناء الانتشار العكسي، وحالة محسِّن مشتركة بين كل الأوزان. كل واحد منها صار الآن اختبار انحدار (regression test).
السؤال
هل أفهم التعلم العميق فهمًا كافيًا لإعادة بناء إطار عمل كامل، من الاشتقاق التلقائي إلى LSTM والانتباه، تتطابق تدرّجاته مع تدرّجات PyTorch؟
أهم الميزات
- اشتقاق تلقائي على الموتّرات: تدرّجات واعية بالبثّ (broadcasting)، وضرب المصفوفات، والاختزالات، والفهرسة، وconcat/stack، وno_grad.
- 20 دالة تنشيط (من ReLU إلى GELU وMish وPReLU متعلَّمة) و10 دوال خسارة، منها إنتروبيا متقاطعة مستقرة مع تنعيم التسميات (label smoothing).
- الطبقات: Linear وConv1d/Conv2d/ConvTranspose2d (عبر im2col) والتجميع (pooling) وBatchNorm/LayerNorm/GroupNorm وDropout وEmbedding.
- RNN وLSTM وGRU (متعددة الطبقات وثنائية الاتجاه)، وانتباه متعدد الرؤوس، وكتلة Transformer من نوع pre-norm.
- 8 محسِّنات (SGD مع Nesterov، وAdagrad، وRMSprop، وAdadelta، وAdam/AMSGrad، وAdamW، وAdamax، وLion)، ومجدوِلات معدل التعلم، وقصّ التدرّجات.
- 160 اختبارًا: فحوص التدرّجات بالفروق المحدودة والتطابق مع PyTorch للطبقات وLSTM/GRU والانتباه والمحسِّنات.
- موقع تعليمي من سبعة فصول مع أدوات تفاعلية: رسم بياني حسابي حيّ، وسباق محسِّنات، ومُصوِّر للالتفاف.
كيف يعمل
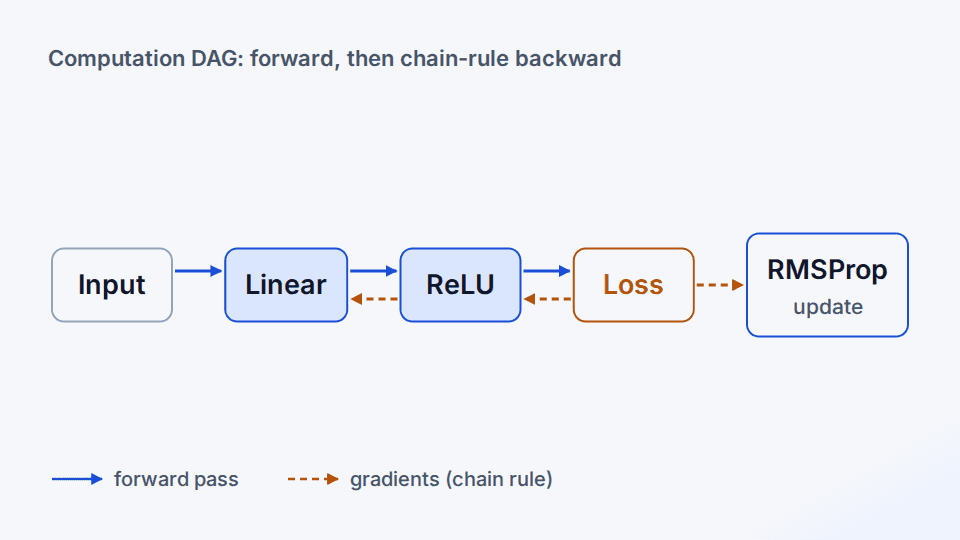
كل عملية تسجّل مدخلاتها
تحسب العملية مصفوفة خرجها وتخزّن دالة تحوّل تدرّج الخرج إلى تدرّج واحد لكل مدخل.
backward() تجتاز الرسم البياني
ترتيب طوبولوجي تكراري يرتّب الرسم البياني؛ وتتدفق التدرّجات في الاتجاه المعاكس وتُجمع مجددًا فوق أبعاد البثّ.
الطبقات وحدات (Modules)
تعثر الوحدة Module على معلماتها Parameters باجتياز خصائصها، لذلك فإن شبكة CNN أو LSTM ليست سوى Python عادي مركَّب من قطع مختبَرة.
فحص مزدوج
تُقارَن كل قاعدة انتشار عكسي مع الفروق المحدودة بدقة float64، ويُقارَن التمرير الأمامي والعكسي لكل طبقة مع نظيريهما في PyTorch.
أمثلة
المدخل
cnn = nn.Sequential(nn.Conv2d(1, 8, 3, padding=1), nn.BatchNorm2d(8), nn.ReLU(), nn.MaxPool2d(2), ..., nn.Linear(784, 10)); mt.Trainer(cnn, nn.CrossEntropyLoss(), optim.Adam(cnn.parameters(), lr=2e-3)).fit(train_loader, epochs=3, val_loader=val_loader)
المخرج
Validation accuracy 94.35%, 96.70%, 97.10% over 3 epochs (9,146 parameters; an MLP with 101,770 parameters reaches 93.65%).
المدخل
model = CharLSTM(vocab); 300 Adam steps on a short text
المخرج
step 0: 'the dbveclgk stmap,sed d ahylb...' -> step 100: 'the chain rule walks that memory backwards.'
التقنيات المستخدمة
ما تعلمته
- الانتشار العكسي (backpropagation) هو قاعدة السلسلة مطبَّقة على رسم بياني موجَّه لا دوري (DAG)؛ أما الأجزاء الصعبة فهي البثّ والحالة المشتركة والاستقرار العددي
- لا تثق أبدًا بتدرّج من دون فحص بالفروق المحدودة: كان في الإصدار v1 مشتق لدالة log خاطئ بمعامل 3
- السرعة تأتي من تنظيم الذاكرة: إعادة كتابة الالتفاف كضرب مصفوفي واحد متجاور عبر im2col جعلت التمرير الأمامي لطبقة التفافية أسرع بنحو 4 مرات
الحدود
- يعمل على المعالج المركزي فقط ومقيَّد بـ NumPy: إطار عمل للتعلم والتجارب الصغيرة، لا للتدريب واسع النطاق