MyTorcha
Un framework de deep learning écrit de zéro
Un framework de deep learning reconstruit à partir des premiers principes : de l'autograd aux LSTM et à l'attention, chaque gradient vérifié.
- 160 tests
- Identique à PyTorch à ~1e-10
- 97,1 % de précision sur les chiffres (CNN)
Construit avec Python
 NumPy
 pytest
 PyTorch
Présentation
Des frameworks comme PyTorch réduisent l'entraînement d'un réseau à un appel, ce qui en cache aussi le fonctionnement. MyTorcha retire cette couche : chaque gradient est du code que j'ai écrit et un test qui le vérifie, avec NumPy pour seule dépendance.
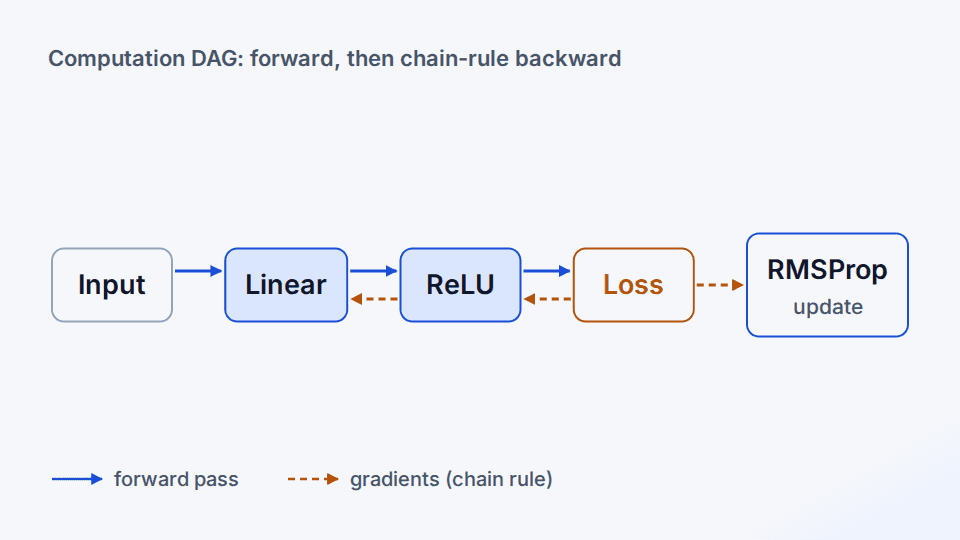
Tout a commencé par un moteur d'autograd scalaire, où chaque nombre est un nœud d'un graphe de calcul. Cette version est conservée comme chapitre pédagogique. C'est aussi la raison pour laquelle le framework a gagné un second moteur : une seule couche 784-vers-10 construit 31 427 nœuds scalaires par image. Le moteur Tensor applique la même règle de dérivation en chaîne à des tableaux entiers, ce qui rend les modèles convolutifs, récurrents et à attention praticables sur un CPU.
Le reconstruire a d'abord voulu dire tester l'original. Les vérifications par différences finies ont révélé de vrais bugs dans la v1 : une dérivée du log fausse d'un facteur d'environ 3, des nœuds qui étaient égaux par valeur et se retrouvaient fusionnés en silence pendant la rétropropagation, et un état d'optimiseur partagé entre tous les poids. Chacun est aujourd'hui un test de régression.
La question
Est-ce que je comprends assez bien le deep learning pour reconstruire un framework, de l'autograd aux LSTM et à l'attention, dont les gradients coïncident avec ceux de PyTorch ?
Fonctionnalités clés
- Autograd sur tenseurs : gradients compatibles avec le broadcasting, matmul, réductions, indexation, concat/stack, no_grad.
- 20 fonctions d'activation (de ReLU à GELU, Mish et un PReLU appris) et 10 fonctions de perte, dont une entropie croisée stable avec lissage des labels.
- Couches : Linear, Conv1d/Conv2d/ConvTranspose2d (im2col), pooling, BatchNorm/LayerNorm/GroupNorm, Dropout, Embedding.
- RNN, LSTM et GRU (multicouches, bidirectionnels), attention multi-têtes et un bloc Transformer pre-norm.
- 8 optimiseurs (SGD avec Nesterov, Adagrad, RMSprop, Adadelta, Adam/AMSGrad, AdamW, Adamax, Lion), planificateurs de taux d'apprentissage et clipping des gradients.
- 160 tests : vérifications des gradients par différences finies et parité avec PyTorch pour les couches, LSTM/GRU, l'attention et les optimiseurs.
- Un site pédagogique en sept chapitres avec des widgets interactifs : graphe de calcul en direct, course d'optimiseurs, visualiseur de convolution.
Comment ça marche
Chaque opération enregistre ses entrées
Une opération calcule son tableau de sortie et stocke une fonction qui transforme le gradient de la sortie en un gradient par entrée.
backward() parcourt le graphe
Un tri topologique itératif ordonne le graphe ; les gradients circulent en sens inverse et sont sommés sur les dimensions diffusées par broadcasting.
Les couches sont des Modules
Un Module trouve ses Parameters en parcourant ses attributs, de sorte qu'un CNN ou un LSTM n'est que du Python ordinaire composé de briques testées.
Vérifié deux fois
Chaque règle de rétropropagation est comparée aux différences finies en float64, et la passe avant comme la passe arrière de chaque couche à celles de PyTorch.
Exemples
Entrée
cnn = nn.Sequential(nn.Conv2d(1, 8, 3, padding=1), nn.BatchNorm2d(8), nn.ReLU(), nn.MaxPool2d(2), ..., nn.Linear(784, 10)); mt.Trainer(cnn, nn.CrossEntropyLoss(), optim.Adam(cnn.parameters(), lr=2e-3)).fit(train_loader, epochs=3, val_loader=val_loader)
Sortie
Validation accuracy 94.35%, 96.70%, 97.10% over 3 epochs (9,146 parameters; an MLP with 101,770 parameters reaches 93.65%).
Entrée
model = CharLSTM(vocab); 300 Adam steps on a short text
Sortie
step 0: 'the dbveclgk stmap,sed d ahylb...' -> step 100: 'the chain rule walks that memory backwards.'
Stack technique
Moteur d'autograd, couches, optimiseurs et boucle d'entraînement
L'unique dépendance à l'exécution : calcul sur tableaux et convolution im2col
Vérifications des gradients et tests de régression pour les bugs de la v1
Implémentation de référence dans les tests de parité uniquement
Ce que j’ai appris
- La rétropropagation, c'est la règle de dérivation en chaîne appliquée à un DAG ; les vraies difficultés sont le broadcasting, l'état partagé et la stabilité numérique
- Ne jamais faire confiance à un gradient sans vérification par différences finies : ma v1 avait une dérivée du log fausse d'un facteur 3
- La vitesse vient de la disposition en mémoire : réécrire la convolution comme un seul produit matriciel im2col contigu a rendu la passe avant d'une couche de convolution environ 4 fois plus rapide
Limites
- CPU uniquement et limité par NumPy : un framework pour apprendre et mener de petites expériences, pas pour l'entraînement à grande échelle