MusicGen
Transformer vs LSTM vs RNN pour la musique
Trois réseaux de neurones rivalisent pour composer des airs de style folk à partir d'une notation textuelle.
- 3 architectures
- 3 tokenizers
Construit avec PyTorch
 Keras
 Streamlitmusic21FluidSynth + pydub
 Poetry
Présentation
Je voulais une comparaison contrôlée des trois modèles de séquence classiques (Transformer, LSTM et RNN) sur les mêmes données musicales, plutôt qu'un seul modèle fortement optimisé et une hypothèse sur les raisons de son succès.
MusicGen représente les morceaux en notation ABC, un format textuel de partition, et entraîne chaque architecture à continuer ce texte token par token. J'ai implémenté le Transformer, le LSTM et le RNN de zéro en PyTorch ; le LSTM et le RNN existent aussi en versions construites sur les couches natives de PyTorch. J'ai ajouté trois tokenizers (un au niveau des caractères, un tokenizer par byte-pair encoding que j'ai entraîné moi-même et un tokenizer de mots Keras) pour observer comment la tokenisation change les résultats.
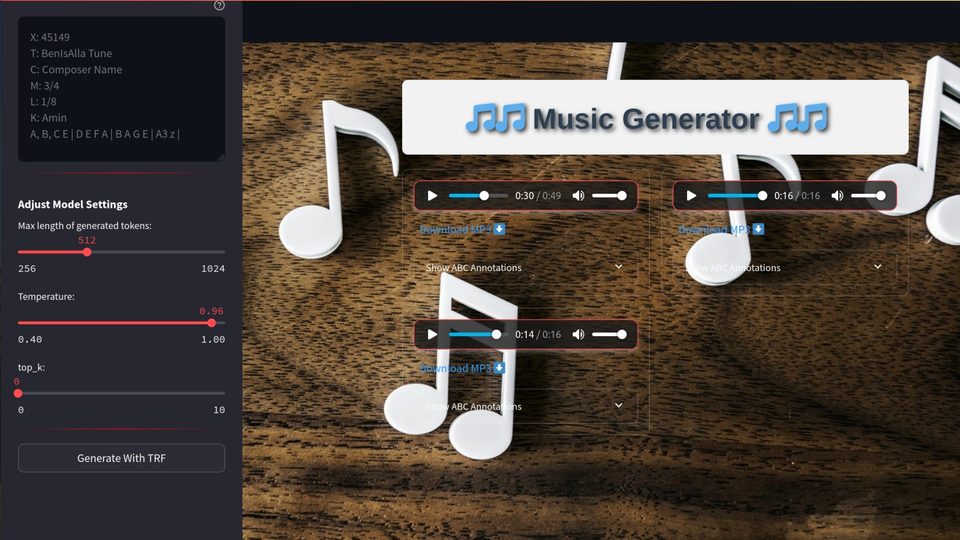
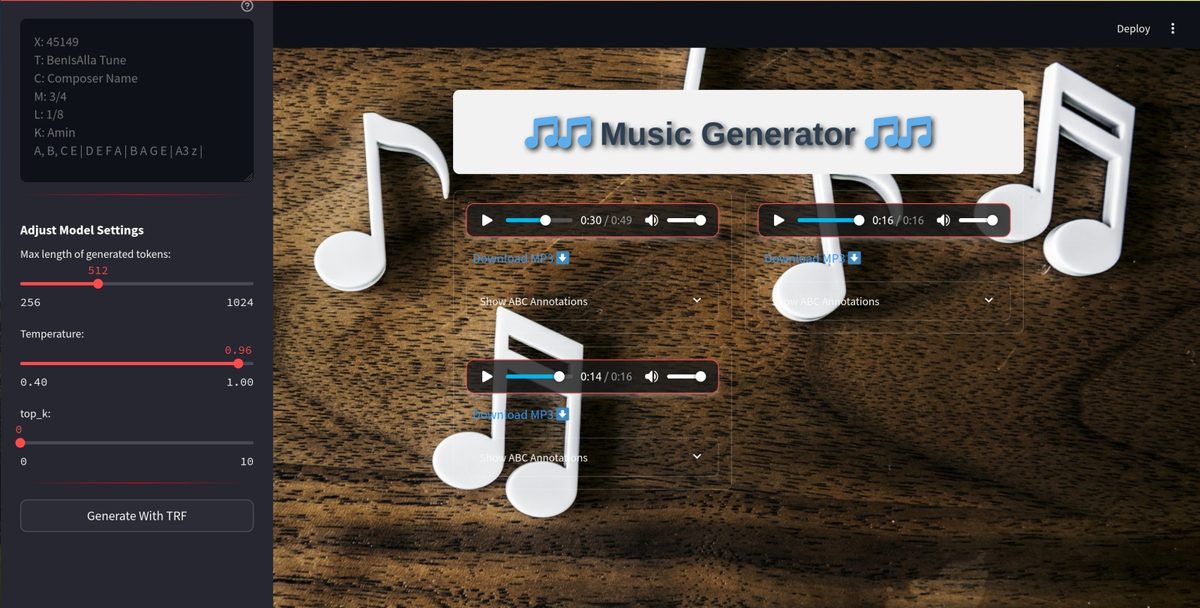
Une application Streamlit relie le tout. On choisit un modèle, on lui donne quelques notes d'ouverture, et il génère des airs rendus en audio et téléchargeables en MP3.
La question
Sur un même corpus musical, comment se comparent Transformer, LSTM et RNN pour la génération de musique symbolique ?
Fonctionnalités clés
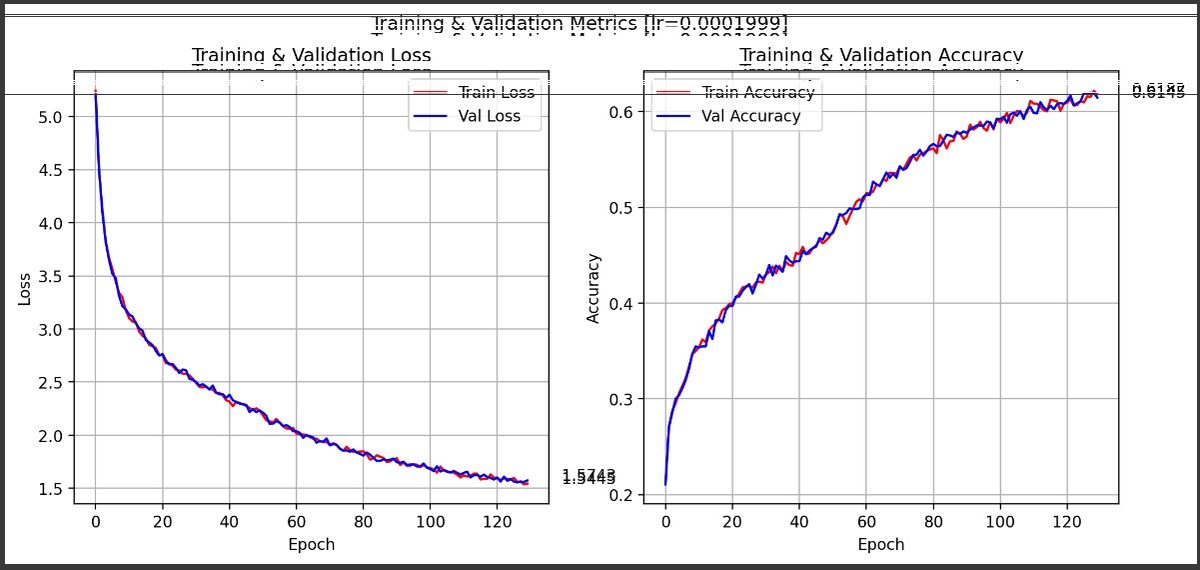
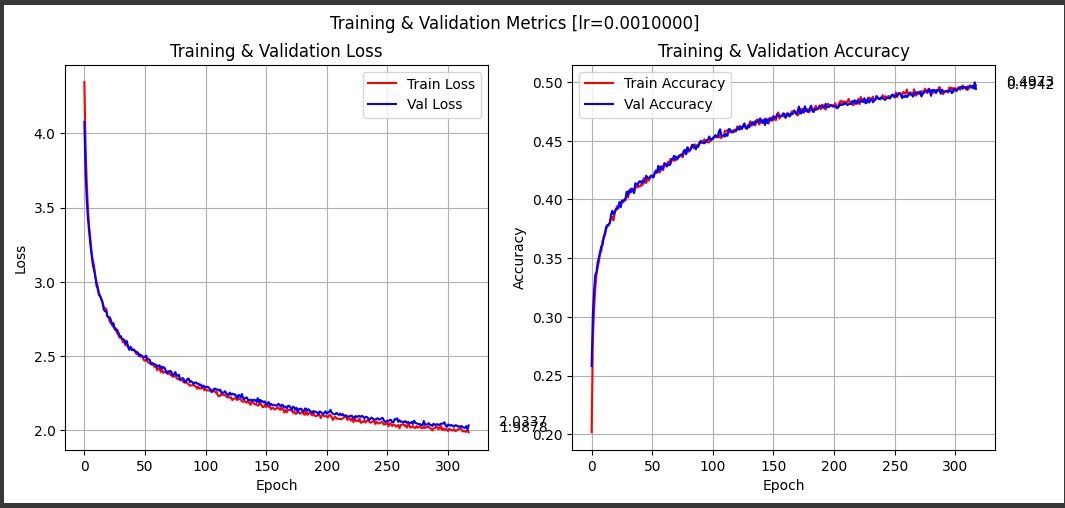
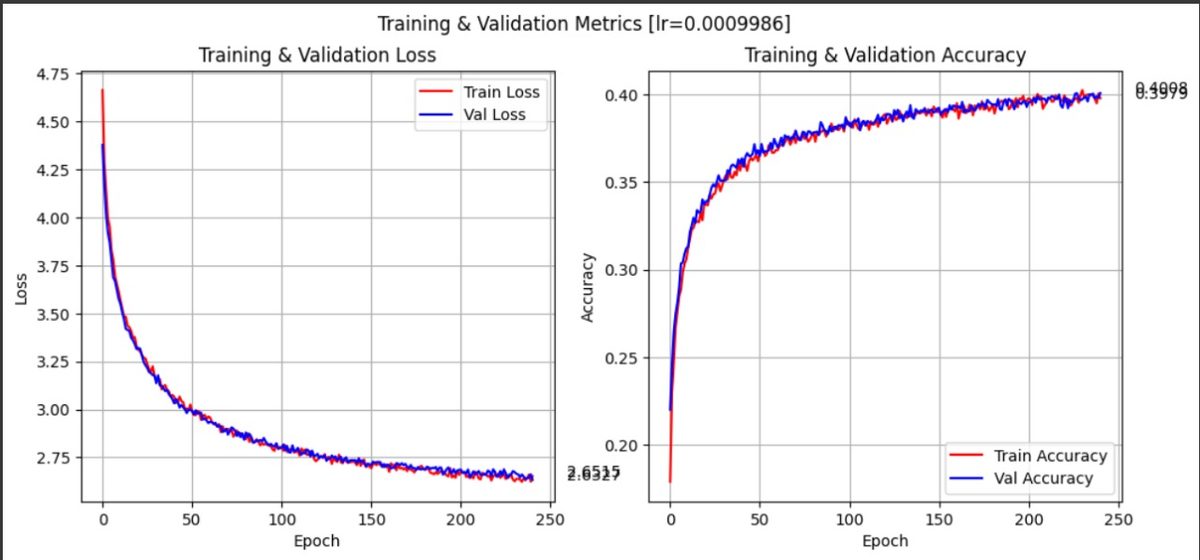
- Générateurs Transformer, LSTM et RNN entraînés sur le même corpus en notation ABC, chacun avec ses courbes de perte et de précision en entraînement et en validation.
- Cellules LSTM et RNN écrites de zéro, à côté de versions construites sur les couches natives de PyTorch.
- Trois tokenizers interchangeables (caractères, byte-pair encoding personnalisé et Keras), chacun avec des tests unitaires.
- Application Streamlit avec un sélecteur de modèle, un champ pour les notes ABC de départ et des curseurs pour la longueur, la température et le top-k.
- L'ABC généré est converti en MIDI puis en audio, de sorte que chaque air peut être joué dans le navigateur, téléchargé en MP3 ou consulté dans sa source ABC.
Comment ça marche
Les morceaux comme texte
La notation ABC de chaque air est encadrée par des tokens de début et de fin, et les airs sont concaténés en un seul long texte d'entraînement.
Tokeniser
Le texte est découpé en tokens par l'un des trois tokenizers : caractères individuels, fusions apprises par byte-pair encoding, ou tokens de mots Keras.
Entraîner des prédicteurs du token suivant
Un Transformer décodeur seul, un LSTM et un RNN apprennent chacun à prédire le token suivant, pendant que la perte et la précision en entraînement et en validation sont suivies.
Échantillonner de nouvelles musiques
À partir des notes d'ouverture de l'utilisateur, le modèle échantillonne les tokens un à un, sous le contrôle de la température et du top-k.
Rendre en audio
L'ABC généré est analysé avec music21, écrit en MIDI, synthétisé en WAV avec FluidSynth et converti en MP3 pour la lecture et le téléchargement.
Exemples
Stack technique
Ce que j’ai appris
- Une comparaison contrôlée d'architectures enseigne plus qu'un seul modèle fortement optimisé
- La stratégie de tokenisation déplace visiblement la qualité de génération
Limites
- Musique symbolique uniquement ; pas de synthèse audio brute