ImageGen
GAN et diffusion derrière une seule boucle d’entraînement
Un DCGAN, un GAN ResNet et un U-Net de diffusion qui s’entraînent, sauvegardent leurs checkpoints et échantillonnent de la même façon, de MNIST sur CPU aux visages d’animaux sur GPU.
- 3 architectures
- Multi-GPU avec torchrun
- AFHQ, 16 130 images
Construit avec PyTorchtorchvision
 Hugging Face Datasetstorchrun
 pytest
Présentation
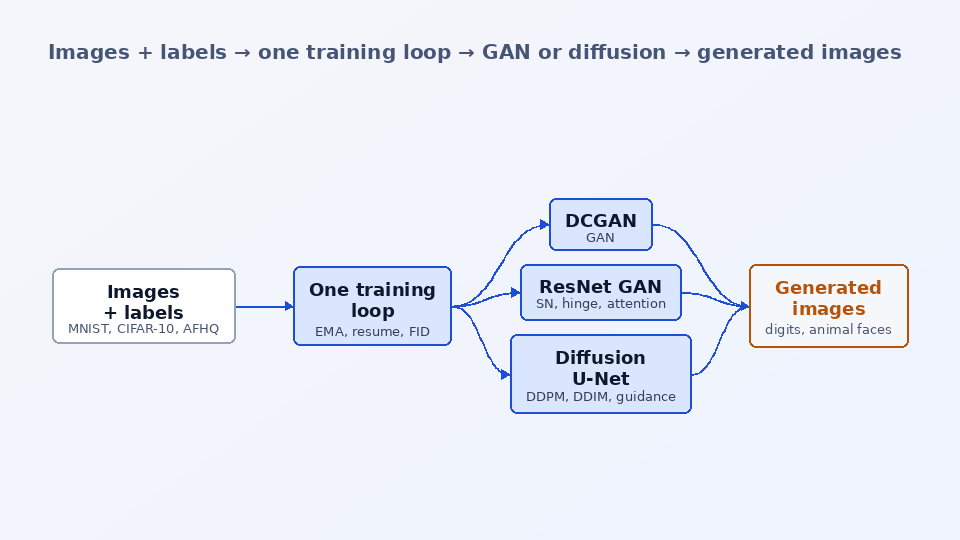
Je voulais générer des visages d’animaux et comprendre les deux familles de modèles qui en sont capables : les GAN, où un générateur et un discriminateur sont entraînés l’un contre l’autre, et la diffusion, où un U-Net apprend à retirer un peu de bruit et où générer revient à débruiter du bruit pur pas à pas. ImageGen place un DCGAN, un GAN ResNet de type SNGAN/BigGAN et un U-Net DDPM derrière une seule boucle d’entraînement, un seul sampler et un seul format de checkpoint, en PyTorch pur.
Les trois peuvent être conditionnés par classe (« dessine un chat »), conservent une copie EMA des poids pour l’échantillonnage, reprennent depuis un checkpoint atomique qui stocke optimiseurs, EMA, état RNG et configurations, et tournent sur un CPU, un GPU, plusieurs GPU ou plusieurs machines via torchrun. Des presets couvrent MNIST, CIFAR-10 et AFHQ (16,130 visages d’animaux en trois classes : chat, chien, sauvage) en 64 et 128 px, avec une commande de préparation qui récupère AFHQ en streaming depuis le Hugging Face Hub dans des dossiers de classes redimensionnés. La FID peut être calculée pendant l’entraînement, et best.pt suit le meilleur score.
Le projet a commencé comme un notebook Colab avec un GAN à ResBlocks sur une archive zip de photos d’animaux ; il s’entraînait sur les mêmes 32 vecteurs de bruit à chaque pas et contenait plusieurs autres bugs, tous listés et corrigés dans le package. Jusqu’ici, chaque architecture et chaque perte de GAN a été vérifiée sur MNIST avec un CPU, y compris les combinaisons qui n’ont pas fonctionné. Les runs GPU complets sur CIFAR-10 et AFHQ, les scores FID et les checkpoints publiés sont la prochaine étape.
La question
Une même base de code peut-elle entraîner les deux familles de GAN et un modèle de diffusion avec la même boucle, le même checkpoint et la même interface d’échantillonnage, et passer d’un run de vérification sur CPU avec MNIST aux visages d’animaux AFHQ sur plusieurs GPU ?
Fonctionnalités clés
- Trois architectures derrière un seul flag --arch : un DCGAN pour toute résolution en puissance de deux, un GAN ResNet avec spectral norm, hinge loss, BatchNorm conditionnelle, discriminateur à projection et self-attention, et un U-Net de diffusion avec schedule cosinus, prédiction ε ou v, échantillonnage DDIM et classifier-free guidance.
- Quatre pertes de GAN (non saturante, hinge, WGAN-GP, LSGAN), la pénalité R1 et DiffAugment pour les petits jeux de données, sélectionnables par flag.
- Une seule interface de tâche, GANTask / DiffusionTask, si bien que la boucle d’entraînement, les checkpoints, l’EMA et l’échantillonnage ignorent quelle famille ils exécutent.
- Des presets nommés pour MNIST, CIFAR-10, AFHQ 64 / 128 et un jeu de formes hors ligne, chaque hyperparamètre pouvant être surchargé en ligne de commande.
- Entraînement sur CPU, un GPU, plusieurs GPU et plusieurs nœuds, avec autocast bf16 sur les GPU récents, un budget de temps qui arrête et sauvegarde proprement, et une reprise exacte.
- imagegen-sample pour les grilles, la génération par classe et les marches latentes, imagegen-fid pour la FID Inception, et imagegen-prepare pour AFHQ, des dossiers ou des archives zip de photos.
- Un notebook Kaggle/Colab construit à partir des sources du package, avec un tableau de bord en direct, un budget de 12 heures et la reprise.
Comment ça marche
Données dans [-1, 1]
Les images sont redimensionnées sur le petit côté, recadrées au centre et ramenées dans [-1, 1], pour que la sortie tanh des générateurs et le bruit de diffusion partagent l’échelle des données. Les sous-dossiers deviennent des classes.
Un pas de GAN
d_steps fois : produire des faux sans gradients vers G, noter les vrais et les faux, ajouter une pénalité de gradient ou R1 si demandé, mettre à jour D. Puis geler D, produire de nouveaux faux, mettre à jour G à travers D, et mettre à jour la copie EMA de G utilisée pour l’échantillonnage.
Un pas de diffusion
Ajouter du bruit à un pas de temps aléatoire du schedule cosinus et régresser ε ou v avec une erreur quadratique moyenne ; l’échantillonnage exécute DDIM (ou une variante de type DDPM avec η = 1) à partir de bruit pur, avec classifier-free guidance pour les modèles conditionnels.
Une boucle pour les deux
La boucle n’appelle que task.train_step(), écrit last.pt et des grilles d’aperçu à partir d’un bruit fixe tous les quelques pas, journalise les métriques dans un fichier JSONL et, sur demande, calcule la FID et conserve best.pt.
Passer à l’échelle
Sous torchrun, chaque processus calcule ses propres gradients et un all-reduce en fait la moyenne avant chaque pas d’optimiseur ; seul le rang 0 écrit des fichiers. Un test lance deux processus CPU et vérifie qu’ils finissent avec des poids identiques.
Exemples
Entrée
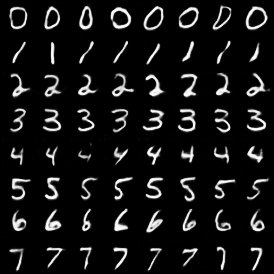
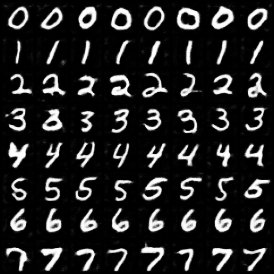
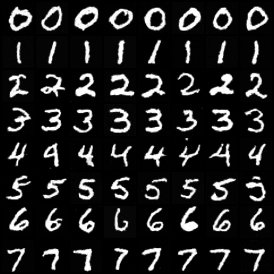
imagegen-train --preset mnist-dcgan --conditional --steps 4000 --output-dir checkpoints/mnist-dcgan imagegen-sample --checkpoint checkpoints/mnist-dcgan/last.pt --class 7 --num 16 --out sevens.png
Sortie
checkpoints/mnist-dcgan/last.pt, samples/step_*.png and metrics.jsonl, then sevens.png: 16 generated sevens from the EMA generator
Stack technique
Modèles, fonctions de perte, processus de diffusion, boucle d’entraînement et entraînement distribué
MNIST, Fashion-MNIST et CIFAR-10, et les features Inception-v3 pour la FID
Récupère AFHQ en streaming depuis le Hub dans des dossiers de classes redimensionnés
Lancements multi-GPU et multi-nœuds avec un all-reduce par pas
Tests CPU hors ligne pour chaque module, dont une vérification distribuée à deux processus
Ce que j’ai appris
- La prédiction ε amplifie les erreurs du débruiteur d’environ 70x aux pas les plus bruités ; la prédiction v a corrigé les fonds et est devenue le choix par défaut
- Une pénalité de gradient par échantillon et une BatchNorm dans le critique ne font pas bon ménage ; la spectral norm, si
- Le premier notebook entraînait le générateur sur les mêmes 32 vecteurs de bruit à chaque pas, si bien qu’il mémorisait 32 images ; tirer un bruit neuf à chaque pas corrige le problème
Limites
- Seuls des runs de vérification sur CPU avec MNIST sont mesurés ; les runs GPU sur CIFAR-10 et AFHQ, les scores FID et les checkpoints publiés figurent encore sur la feuille de route
Mots-clés
génération d’images · GAN · DCGAN · SNGAN · BigGAN · normalisation spectrale · hinge loss · discriminateur à projection · DiffAugment · modèles de diffusion · DDPM · DDIM · prédiction v · classifier-free guidance · EMA · AFHQ · CIFAR-10 · MNIST · entraînement distribué · PyTorch