ImageGen
شبكات GAN ونماذج الانتشار خلف حلقة تدريب واحدة
DCGAN وGAN من نوع ResNet وشبكة U-Net للانتشار، تتدرب وتحفظ نقاطها وتولّد العينات بالطريقة نفسها، من MNIST على CPU إلى وجوه الحيوانات على GPU.
- 3 معماريات
- عدة GPU عبر torchrun
- AFHQ: 16,130 صورة
التقنيات PyTorchtorchvision
 Hugging Face Datasetstorchrun
 pytest
نظرة عامة
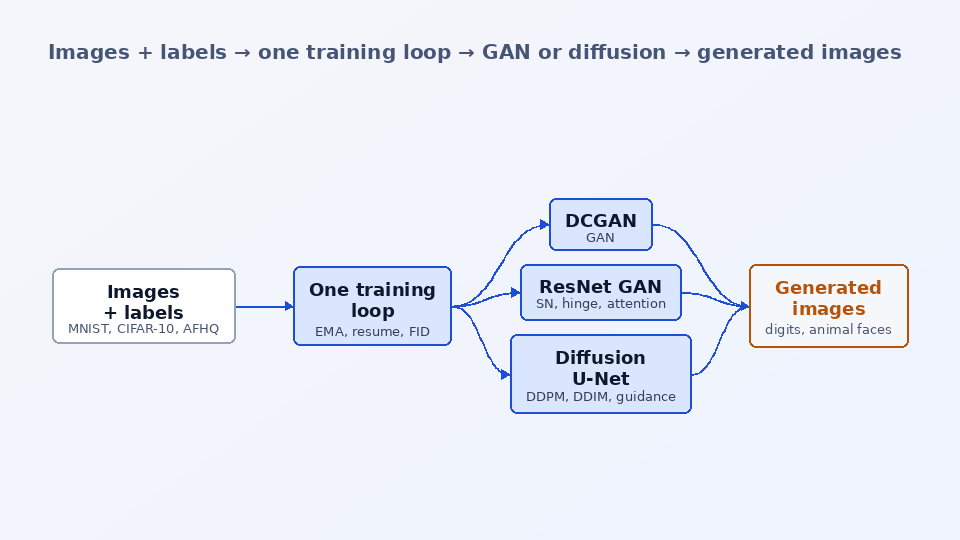
أردتُ توليد وجوه حيوانات وفهم عائلتي النماذج القادرتين على ذلك: شبكات GAN، حيث يُدرَّب مولّد ومميِّز أحدهما ضد الآخر، ونماذج الانتشار (Diffusion Models)، حيث تتعلم شبكة U-Net إزالة قليل من الضجيج ويكون التوليد إزالةً للضجيج من ضجيج خالص خطوة بعد خطوة. يضع ImageGen شبكة DCGAN وشبكة GAN من نوع ResNet على نمط SNGAN/BigGAN وشبكة U-Net لنموذج DDPM خلف حلقة تدريب واحدة وأداة توليد واحدة وصيغة نقاط حفظ واحدة، بـ PyTorch خالص.
يمكن أن تكون النماذج الثلاثة شرطية حسب الفئة («ارسم قطًا»)، وتحتفظ بنسخة EMA من الأوزان للتوليد، وتستأنف من نقطة حفظ ذرّية تخزّن المُحسِّنات وEMA وحالة المولّد العشوائي والإعدادات، وتعمل على CPU أو GPU واحد أو عدة GPU أو عدة أجهزة عبر torchrun. وتغطي الإعدادات الجاهزة MNIST وCIFAR-10 وAFHQ (16,130 وجه حيوان في ثلاث فئات: قط، كلب، بري) بدقة 64 و128 px، مع أمر تجهيز يجلب AFHQ تدفقيًا من Hugging Face Hub إلى مجلدات فئات بأحجام معدّلة. ويمكن حساب FID أثناء التدريب، ويتتبّع best.pt أدنى قيمة.
بدأ المشروع دفترَ Colab فيه GAN مبني على ResBlock يعمل على ملف zip لصور حيوانات؛ كان يدرّب على متجهات الضجيج الـ 32 نفسها في كل خطوة وفيه عدة أخطاء أخرى، كلها مُدرجة ومُصلحة في الحزمة. وحتى الآن تم التحقق من كل معمارية وكل دالة خسارة لـ GAN على MNIST باستخدام CPU، بما في ذلك التركيبات التي لم تنجح. أما التشغيلات الكاملة على GPU مع CIFAR-10 وAFHQ وأرقام FID ونقاط الحفظ المنشورة فهي الخطوة التالية.
السؤال
هل تستطيع قاعدة شيفرة واحدة أن تدرّب عائلتي GAN ونموذج انتشار بالحلقة نفسها ونقطة الحفظ نفسها وواجهة التوليد نفسها، وأن تتوسع من تشغيل تحقّق على CPU مع MNIST إلى وجوه الحيوانات AFHQ على عدة GPU؟
أهم الميزات
- ثلاث معماريات خلف خيار واحد --arch: DCGAN لأي دقة من قوى العدد اثنين، وGAN من نوع ResNet مع spectral norm وhinge loss وBatchNorm شرطية ومميِّز إسقاطي وself-attention، وشبكة U-Net للانتشار مع جدولة جيبية وتنبؤ ε أو v وتوليد DDIM وclassifier-free guidance.
- أربع دوال خسارة لـ GAN (غير مشبعة، hinge، WGAN-GP، LSGAN)، وعقوبة R1، وDiffAugment لمجموعات البيانات الصغيرة، كلها قابلة للاختيار بخيار.
- واجهة مهمة واحدة، GANTask / DiffusionTask، فلا تعرف حلقة التدريب ولا نقاط الحفظ ولا EMA ولا التوليد أي عائلة تشغّل.
- إعدادات جاهزة مسمّاة لـ MNIST وCIFAR-10 وAFHQ 64 / 128 ومجموعة أشكال دون اتصال، مع إمكانية تجاوز كل معامل فائق من سطر الأوامر.
- تدريب على CPU وGPU واحد وعدة GPU وعدة عُقد، مع bf16 autocast على وحدات GPU الحديثة، وميزانية زمنية تتوقف وتحفظ بشكل نظيف، واستئناف دقيق.
- imagegen-sample لشبكات الصور والتوليد حسب الفئة والتجوال في الفضاء الكامن، وimagegen-fid لحساب FID بـ Inception، وimagegen-prepare لتجهيز AFHQ أو مجلدات أو ملفات zip من الصور.
- دفتر Kaggle/Colab مبني من مصدر الحزمة، مع لوحة متابعة حية وميزانية 12 ساعة واستئناف.
كيف يعمل
بيانات ضمن [-1, 1]
يُعاد تحجيم الصور على الضلع الأقصر، وتُقص من المركز، وتُحوَّل إلى المجال [-1, 1]، كي يتشارك مخرج tanh في المولّدات وضجيج الانتشار مقياس البيانات نفسه. وتصبح المجلدات الفرعية فئات.
خطوة GAN
تُكرَّر d_steps مرة: توليد صور مزيفة دون تدرجات نحو G، وتقييم الحقيقية والمزيفة، وإضافة عقوبة التدرج أو R1 عند الطلب، وتحديث D. ثم تجميد D، وتوليد صور مزيفة جديدة، وتحديث G عبر D، وتحديث نسخة EMA من G المستخدمة في التوليد.
خطوة انتشار
إضافة ضجيج عند خطوة زمنية عشوائية من الجدولة الجيبية والانحدار نحو ε أو v بمتوسط مربع الخطأ؛ ويجري التوليد بـ DDIM (أو بأسلوب DDPM مع η = 1) انطلاقًا من ضجيج خالص، مع classifier-free guidance للنماذج الشرطية.
حلقة واحدة للعائلتين
لا تستدعي الحلقة إلا task.train_step()، وتكتب last.pt وشبكات معاينة من ضجيج ثابت كل بضع خطوات، وتسجّل المقاييس في ملف JSONL، وعند الطلب تحسب FID وتحتفظ بـ best.pt.
التوسّع
تحت torchrun تحسب كل عملية تدرجاتها الخاصة، ويأخذ all-reduce واحد متوسطها قبل كل خطوة للمُحسِّن؛ ولا تكتب الملفات إلا العملية ذات الرتبة 0. ويشغّل اختبارٌ عمليتين على CPU ويتحقق من انتهائهما بأوزان متطابقة.
أمثلة
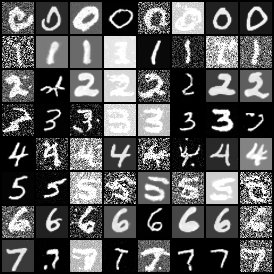
المدخل
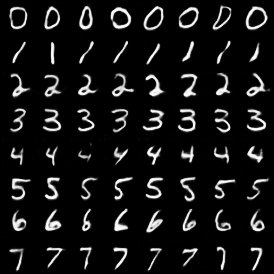
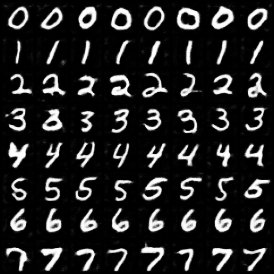
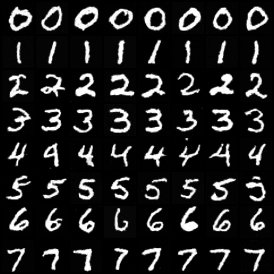
imagegen-train --preset mnist-dcgan --conditional --steps 4000 --output-dir checkpoints/mnist-dcgan imagegen-sample --checkpoint checkpoints/mnist-dcgan/last.pt --class 7 --num 16 --out sevens.png
المخرج
checkpoints/mnist-dcgan/last.pt, samples/step_*.png and metrics.jsonl, then sevens.png: 16 generated sevens from the EMA generator
التقنيات المستخدمة
النماذج ودوال الخسارة وعملية الانتشار وحلقة التدريب والتدريب الموزّع
MNIST وFashion-MNIST وCIFAR-10، وميزات Inception-v3 لحساب FID
يجلب AFHQ تدفقيًا من Hub إلى مجلدات فئات بأحجام معدّلة
إطلاق التدريب على عدة GPU وعدة عُقد مع all-reduce واحد لكل خطوة
اختبارات على CPU دون اتصال لكل وحدة، منها تحقق موزّع بعمليتين
ما تعلمته
- يضخّم تنبؤ ε أخطاء مزيل الضجيج بنحو 70x في الخطوات الأكثر ضجيجًا؛ وقد أصلح تنبؤ v الخلفيات وأصبح الخيار الافتراضي
- عقوبة التدرج لكل عينة لا تنسجم مع BatchNorm في الناقد؛ أما spectral norm فتنسجم
- كان الدفتر الأول يدرّب المولّد على متجهات الضجيج الـ 32 نفسها في كل خطوة، فحفظ 32 صورة؛ والحل هو سحب ضجيج جديد في كل خطوة
الحدود
- لم تُقَس سوى تشغيلات التحقق على CPU مع MNIST؛ وما زالت تشغيلات GPU على CIFAR-10 وAFHQ وأرقام FID ونقاط الحفظ المنشورة على خارطة الطريق
الكلمات المفتاحية
توليد الصور · GAN · DCGAN · SNGAN · BigGAN · التطبيع الطيفي · hinge loss · المميِّز الإسقاطي · DiffAugment · نماذج الانتشار · DDPM · DDIM · تنبؤ v · classifier-free guidance · EMA · AFHQ · CIFAR-10 · MNIST · التدريب الموزّع · PyTorch