ViT Image Classifier
محوّل الرؤية من الصفر
مصنّف صور مبني من الصفر لفهم كيفية عمل محوّلات الرؤية
- 3 استراتيجيات لتضمين الرقع
التقنيات PyTorch
 PoetryViTtorchvision
 scikit-learn
 StreamlitMatplotlib
نظرة عامة
تصنّف محوّلات الرؤية (Vision Transformers) الصور بتقطيعها إلى رقع (patches) ومعاملة هذه الرقع كما تُعامل الكلمات في جملة. أردت معرفة ما يسهم به كل جزء من هذا التصميم فعلًا، فبنيت محوّل رؤية من الصفر في PyTorch بدل استيراد واحد جاهز.
كتبت كل مكوّن بنفسي: ثلاث استراتيجيات لتضمين الرقع، وترميزات موضعية قابلة للتعلم، وانتباهًا ذاتيًا متعدد الرؤوس، ودالة تنشيط GELU مخصصة، ورمز [CLS] على طريقة BERT تغذّي حالته النهائية المصنّف. طوّرته مع فريق أمراض النباتات في مجتمع Moroccan Data Scientists وطبّقته على صور أمراض أوراق الطماطم والبطاطس.
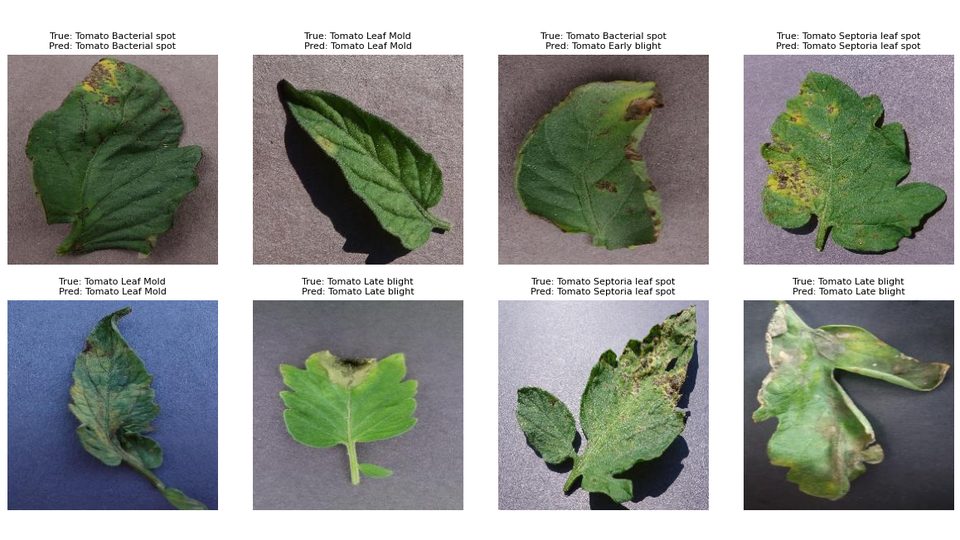
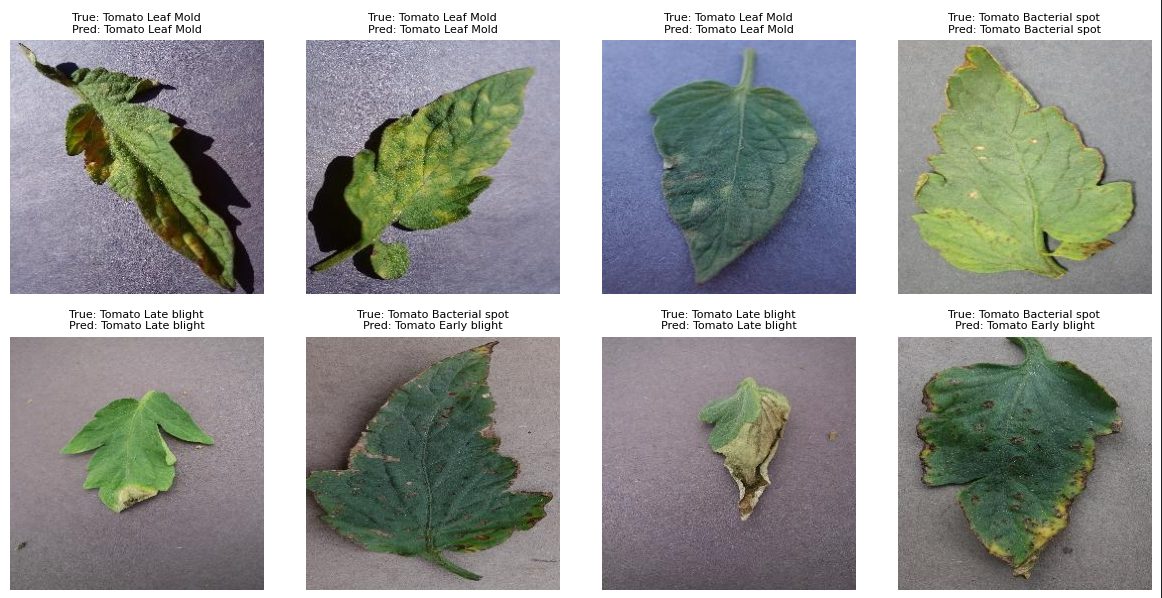
على مجموعة اختبار محجوزة تغطي أربع فئات من أوراق الطماطم، بلغ النموذج دقة تقارب 81% (يذكر ملف README في المستودع 81.6%). إنه نموذج بنطاق تعليمي، لم يُقارَن بنماذج ViT الكبيرة المدرَّبة مسبقًا.
السؤال
ما الذي يسهم به كل جزء من محوّل الرؤية فعلًا؟ هل أستطيع بناء تضمين الرقع ورمز الفئة والانتباه والضبط الدقيق من الصفر مع الحفاظ على تصنيف جيد؟
أهم الميزات
- يوفّر ثلاث استراتيجيات لتضمين الرقع: إسقاط Conv2D، وLayerNorm على الرقع المسطّحة قبل الإسقاط، ونهج يعتمد إعادة تشكيل الموتّر فقط.
- يضيف في المقدمة رمز [CLS] قابلًا للتعلم ويصنّف انطلاقًا من تمثيله النهائي، كما في BERT.
- ينفّذ دالة تنشيط GELU الخاصة به وLayerNorm بانحياز اختياري.
- يستخدم تعزيزًا مكثفًا للبيانات الصغيرة: قصًّا عشوائيًا، وقلبًا، ودورانًا، واضطراب ألوان، وAutoAugment، ومحوًا عشوائيًا.
- يتدرّب بـ AdamW، وتناقص جيب التمام لمعدل التعلم، وتنعيم التسميات، وتقسيمات طبقية للتدريب/التحقق/الاختبار.
- يتضمن تطبيق Streamlit يحمّل نقطة حفظ ويصنّف صورة ورقة نبات مرفوعة.
كيف يعمل
تقسيم الصورة إلى رقع
تُقسَّم كل صورة إلى رقع بحجم 16x16 وتُسقَط إلى متجهات تضمين، مع إضافة رمز [CLS] قابل للتعلم في المقدمة.
إضافة المواضع
ترميزات موضعية قابلة للتعلم تخبر النموذج من أين جاءت كل رقعة، لأن الانتباه وحده يتجاهل الترتيب.
الترميز
مكدّس من كتل Transformer يطبّق الانتباه الذاتي متعدد الرؤوس وطبقات أمامية بحيث تستطيع كل رقعة الالتفات إلى سائر الرقع.
التصنيف
بعد LayerNorm أخير، يمر متجه رمز [CLS] عبر رأس خطي يُخرج درجات الفئات.
التدريب والضبط الدقيق
نقطتا دخول منفصلتان للتدريب والضبط الدقيق تدعمان سير عمل نقل التعلم، مع رسوم حية للخسارة والدقة أثناء التدريب.
أمثلة
التقنيات المستخدمة
كل مكوّنات النموذج وحلقة التدريب
إدارة التبعيات والبيئة
ViT
البنية التي أعدت بناءها من الصفر
خط معالجة التعزيز، بما فيه AutoAugment
تقسيمات طبقية للتدريب/التحقق/الاختبار
تطبيق عرض: ارفع صورة وصنّفها
منحنيات تدريب حية وشبكات تنبؤات
ما تعلمته
- اختيار طريقة تقسيم الصورة إلى رقع يغيّر كل ما يليه
- نموذج التمثيل عبر [CLS] ينتقل بسلاسة من BERT إلى الرؤية الحاسوبية
الحدود
- نطاق تعليمي؛ لم تُجرَ مقارنة مع نماذج ViT الكبيرة المدرَّبة مسبقًا