ViT Image Classifier
Vision Transformer écrit de zéro
Un classifieur d'images construit de zéro pour comprendre le fonctionnement des Vision Transformers
- 3 stratégies de patch embedding
Construit avec PyTorch
 PoetryViTtorchvision
 scikit-learn
 StreamlitMatplotlib
Présentation
Les Vision Transformers classifient les images en les découpant en patchs et en traitant ces patchs comme les mots d'une phrase. Je voulais savoir ce que chaque partie de cette conception apporte réellement, alors j'ai construit un Vision Transformer de zéro en PyTorch plutôt que d'en importer un.
J'ai écrit chaque composant moi-même : trois stratégies d'embedding par patchs, des encodages de position apprenables, l'auto-attention multi-têtes, une activation GELU personnalisée et un token [CLS] à la manière de BERT, dont l'état final alimente le classifieur. Je l'ai développé avec l'équipe maladies des plantes de la communauté Moroccan Data Scientists et je l'ai appliqué à des images de feuilles de tomate et de pomme de terre malades.
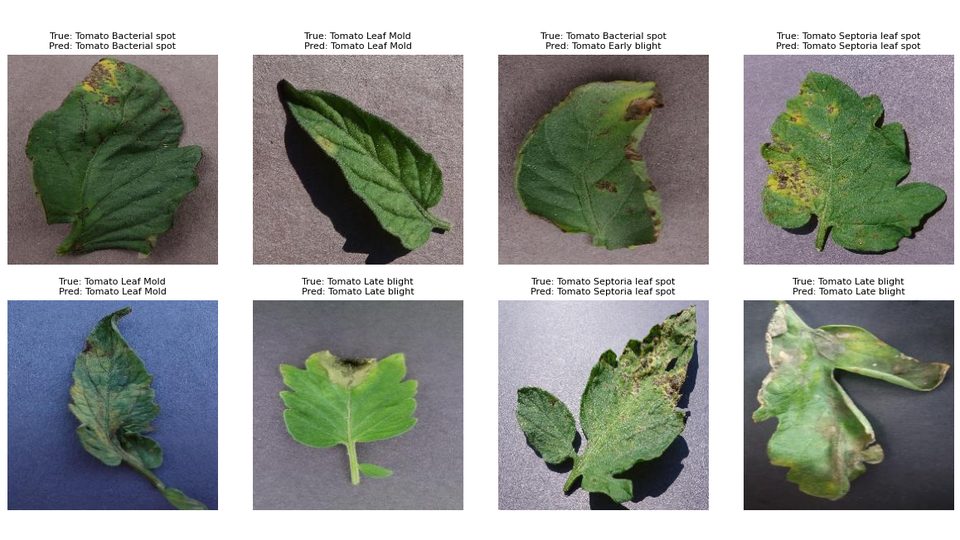
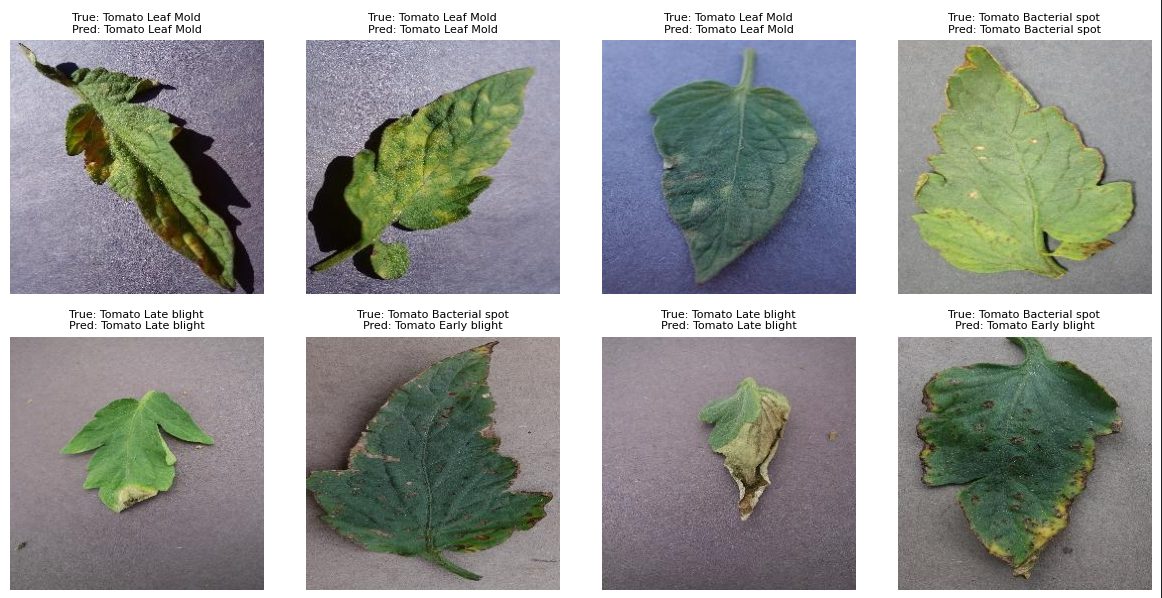
Sur un jeu de test tenu à l'écart couvrant quatre classes de feuilles de tomate, le modèle a atteint environ 81 % de précision (le README du dépôt rapporte 81.6 %). C'est un modèle à échelle pédagogique, non comparé à de grands ViT préentraînés.
La question
Que contribue réellement chaque composant d'un Vision Transformer ? Puis-je construire moi-même l'embedding par patchs, le token de classe, l'attention et le fine-tuning, et obtenir malgré tout une bonne classification ?
Fonctionnalités clés
- Propose trois stratégies d'embedding par patchs : une projection Conv2D, un LayerNorm sur les patchs aplatis avant projection, et une approche par pur remodelage de tenseur.
- Ajoute en tête un token [CLS] apprenable et classifie à partir de sa représentation finale, comme dans BERT.
- Implémente sa propre activation GELU et un LayerNorm à biais optionnel.
- Utilise une forte augmentation pour les petits jeux de données : recadrages aléatoires, retournements, rotations, variations de couleur, AutoAugment et effacement aléatoire.
- S'entraîne avec AdamW, une décroissance cosinus du taux d'apprentissage, le lissage d'étiquettes et des découpages stratifiés entraînement/validation/test.
- Inclut une application Streamlit qui charge un checkpoint et classifie une image de feuille téléversée.
Comment ça marche
Découper l'image en patchs
Chaque image est découpée en patchs de 16x16 et projetée en vecteurs d'embedding, avec un token [CLS] apprenable ajouté en tête.
Ajouter les positions
Des encodages de position apprenables indiquent au modèle d'où vient chaque patch, puisque l'attention seule ignore l'ordre.
Encoder
Une pile de blocs Transformer applique l'auto-attention multi-têtes et des couches feed-forward pour que chaque patch puisse prêter attention à tous les autres.
Classifier
Après un dernier LayerNorm, le vecteur du token [CLS] passe par une tête linéaire qui produit les scores de classe.
Entraîner et affiner
Des points d'entrée séparés pour l'entraînement et le fine-tuning permettent un flux de transfert d'apprentissage, avec des courbes de perte et de précision tracées en direct pendant l'entraînement.
Exemples
Stack technique
Chaque composant du modèle et la boucle d'entraînement
Gestion des dépendances et de l'environnement
ViT
L'architecture reconstruite de zéro
Pipeline d'augmentation, dont AutoAugment
Découpages stratifiés entraînement/validation/test
Application de démo : téléverser et classifier
Courbes d'entraînement en direct et grilles de prédictions
Ce que j’ai appris
- Le choix de la tokenisation en patchs change tout ce qui suit
- Le paradigme de la représentation [CLS] se transpose proprement de BERT à la vision
Limites
- Échelle pédagogique ; aucune comparaison avec de grands ViT préentraînés