Image Captioner
Légendage d'images multimodal
Un modèle qui regarde une photo et écrit une phrase pour la décrire
Construit avec PyTorchCustom Transformers
 Streamlit
 Poetry
 Hugging Face Transformerseinopstorchvision
Présentation
Le légendage d'images demande à un modèle de relier deux modalités : les pixels et les mots. Je voulais comprendre ce lien de l'intérieur, alors j'ai écrit chaque pièce d'un modèle de légendage à la main en PyTorch, au lieu d'assembler des composants préentraînés.
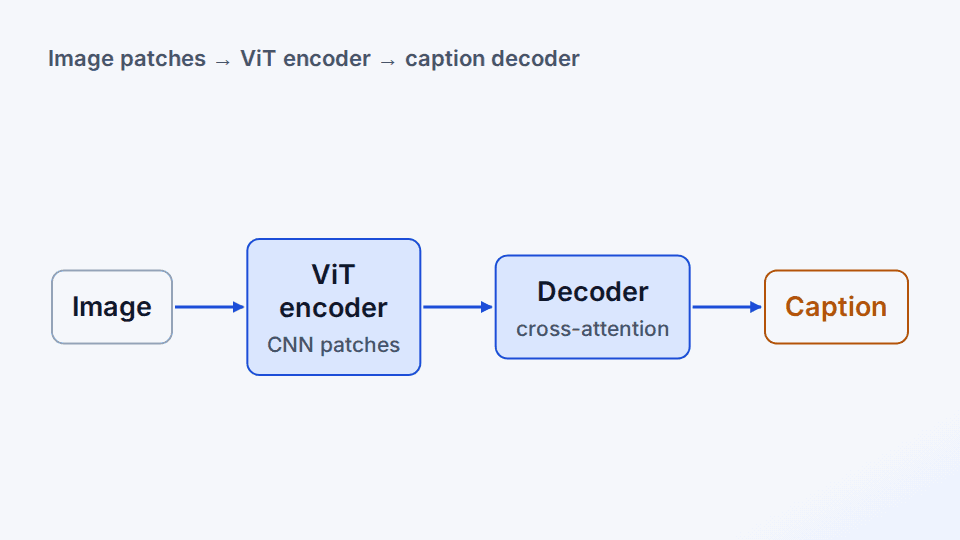
J'ai construit un Transformer encodeur-décodeur : un encodeur Vision Transformer transforme l'image en une séquence de tokens de patchs, et un décodeur Transformer rédige la légende token par token, en utilisant l'attention croisée pour consulter les tokens de l'image à chaque étape. La configuration d'entraînement vise le jeu de données image-légende Flickr30k sur Kaggle.
Le projet m'a appris comment l'attention croisée permet à un décodeur de texte de se conditionner sur une autre modalité, et comment de petits choix comme le partage de poids, le lissage d'étiquettes et le batching par longueur façonnent l'entraînement. C'est un artefact d'apprentissage entraîné sur des données limitées, pas un légendeur de production.
La question
Un encodeur ViT écrit de zéro, associé à un décodeur Transformer à attention croisée, peut-il apprendre à aligner suffisamment bien les représentations visuelles et textuelles pour légender des images de bout en bout ?
Fonctionnalités clés
- Découpe chaque image en patchs de 16x16 avec une convolution à pas (stride) et ajoute des encodages de position apprenables.
- Encode les patchs avec une pile de blocs résiduels d'auto-attention multi-têtes et de couches feed-forward.
- Décode les légendes avec un décodeur Transformer qui applique une attention croisée sur les tokens de l'image.
- Lie l'embedding d'entrée du décodeur à sa projection de sortie pour réduire le nombre de paramètres.
- Génère les légendes par recherche en faisceau, normalisation par la longueur et filtrage top-k / top-p.
- Regroupe les légendes par longueur sous un budget de tokens, avec une perte d'entropie croisée à lissage d'étiquettes qui ignore le padding.
Comment ça marche
Découper l'image en patchs
Une convolution dont le noyau et le pas sont égaux à la taille du patch transforme l'image en une séquence d'embeddings de patchs, puis des encodages de position apprenables sont ajoutés.
Encoder
Des blocs résiduels empilés d'auto-attention et de feed-forward construisent des tokens visuels contextuels.
Décoder avec attention croisée
Le décodeur de légende s'appuie sur les mots précédents par auto-attention masquée et sur les tokens visuels par attention croisée.
Entraîner
Tokenizer GPT-2 avec tokens de début, de fin et de padding ajoutés ; entropie croisée à lissage d'étiquettes sur les vrais tokens de légende ; planification du taux d'apprentissage avec warmup et écrêtage de gradient.
Décrire
La recherche en faisceau avec normalisation par la longueur et filtrage top-k / top-p sélectionne la meilleure hypothèse de légende.
Exemples
Stack technique
Chaque composant du modèle, écrit à la main
Custom Transformers
Encodeur ViT et décodeur de légende à attention croisée
Squelette d'application pour une démo interactive
Gestion des dépendances et de l'environnement
Tokenizer GPT-2 avec tokens spéciaux ajoutés
Remodelage des grilles de patchs en séquences de tokens
Transformations de prétraitement des images
Ce que j’ai appris
- L'attention croisée est le mécanisme qui permet à un décodeur de se conditionner sur une autre modalité
- Le partage de poids (weight tying) est un moyen peu coûteux de réduire le nombre de paramètres
Limites
- Le script d'entraînement du dépôt public est inachevé ; aucun résultat de qualité de légende n'est donc encore rapporté