Image Captioner
توليد أوصاف الصور متعدد الوسائط
نموذج ينظر إلى صورة ويكتب جملة تصفها
التقنيات PyTorchCustom Transformers
 Streamlit
 Poetry
 Hugging Face Transformerseinopstorchvision
نظرة عامة
توليد أوصاف الصور (Image Captioning) يطلب من النموذج الربط بين وسيطين: البكسلات والكلمات. أردت فهم هذا الربط من الداخل، فكتبت كل جزء من نموذج التوصيف يدويًا في PyTorch بدل تجميع مكوّنات مدرَّبة مسبقًا.
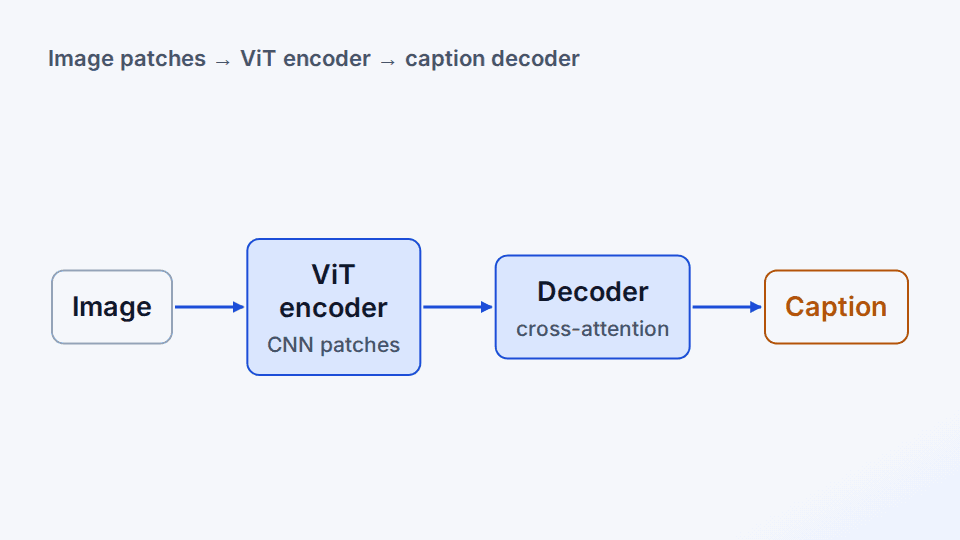
بنيت محوّلًا (Transformer) من نوع مُرمِّز–مُفكِّك: مُرمِّز محوّل الرؤية (Vision Transformer) يحوّل الصورة إلى تسلسل من رموز الرقع (patch tokens)، ومُفكِّك Transformer يكتب الوصف رمزًا تلو الآخر، مستخدمًا الانتباه المتقاطع (cross-attention) للنظر إلى رموز الصورة في كل خطوة. يستهدف إعداد التدريب مجموعة بيانات Flickr30k للصور والأوصاف على Kaggle.
علّمني المشروع كيف يتيح الانتباه المتقاطع لمُفكِّك نصي أن يستند إلى وسيط مختلف، وكيف تشكّل خيارات صغيرة مثل ربط الأوزان وتنعيم التسميات وتجميع الدفعات حسب الطول مسار التدريب. إنه عمل تعليمي مدرَّب على بيانات محدودة، لا أداة توصيف إنتاجية.
السؤال
هل يستطيع مُرمِّز ViT مكتوب من الصفر، مقترنًا بمُفكِّك Transformer يعتمد الانتباه المتقاطع (cross-attention)، أن يتعلم محاذاة التمثيلات البصرية والنصية بما يكفي لوصف الصور من البداية إلى النهاية؟
أهم الميزات
- يقسّم كل صورة إلى رقع بحجم 16x16 عبر التفاف (convolution) بخطوة، ويضيف ترميزات موضعية قابلة للتعلم.
- يرمّز الرقع بمكدّس من كتل الانتباه الذاتي متعدد الرؤوس والطبقات الأمامية (feed-forward) ذات الوصلات المتبقية.
- يفكّ ترميز الأوصاف بمُفكِّك Transformer يطبّق انتباهًا متقاطعًا على رموز الصورة.
- يربط تضمين دخل المُفكِّك بإسقاط خرجه لتقليل عدد المعاملات.
- يولّد الأوصاف ببحث الحزمة (beam search) وتطبيع الطول وترشيح top-k / top-p.
- يجمّع الأوصاف في دفعات حسب الطول ضمن ميزانية رموز، مع دالة خسارة إنتروبيا متقاطعة بتنعيم التسميات تتجاهل الحشو (padding).
كيف يعمل
تقسيم الصورة إلى رقع
التفاف نواته وخطوته مساويتان لحجم الرقعة يحوّل الصورة إلى تسلسل من تضمينات الرقع، ثم تُضاف ترميزات موضعية قابلة للتعلم.
الترميز
كتل متراصّة من الانتباه الذاتي والطبقات الأمامية ذات الوصلات المتبقية تبني رموزًا بصرية سياقية.
فك الترميز بالانتباه المتقاطع
يلتفت مُفكِّك الوصف إلى الكلمات السابقة بانتباه ذاتي مقنّع، وإلى الرموز البصرية بانتباه متقاطع.
التدريب
مُقطِّع GPT-2 مع رموز بداية ونهاية وحشو مضافة؛ إنتروبيا متقاطعة بتنعيم التسميات على رموز الوصف الحقيقية؛ جدولة معدل تعلم مع إحماء (warmup) وقصّ التدرّج (gradient clipping).
الوصف
بحث الحزمة مع تطبيع الطول وترشيح top-k / top-p يختار أفضل فرضية للوصف.
أمثلة
التقنيات المستخدمة
كل مكوّنات النموذج، مكتوبة يدويًا
Custom Transformers
مُرمِّز ViT ومُفكِّك أوصاف بانتباه متقاطع
هيكل تطبيق لعرض تفاعلي
إدارة التبعيات والبيئة
مُقطِّع GPT-2 مع رموز خاصة مضافة
إعادة تشكيل شبكات الرقع إلى تسلسلات رموز
تحويلات المعالجة المسبقة للصور
ما تعلمته
- الانتباه المتقاطع هو الآلية التي تتيح للمُفكِّك أن يستند إلى وسيط مختلف
- ربط الأوزان (weight tying) طريقة زهيدة الكلفة لتقليل عدد المعاملات
الحدود
- سكريبت التدريب في المستودع العام غير مكتمل، لذا لم تُنشر بعد أي نتائج عن جودة الأوصاف