TTS Workbench
مقاربات تحويل النص إلى كلام في PyTorch
أربعة نماذج لتحويل النص إلى كلام ومشفّر صوتي عصبي، صغيرة بما يكفي للتدريب على حاسوب محمول والمقارنة بالمقاييس نفسها.
- FastSpeech 2: 12.3 dB MCD
- 4 نماذج TTS
التقنيات PyTorch
 NumPyMatplotlib
 Hugging Face Transformers
 pytest
 Kaggle
نظرة عامة
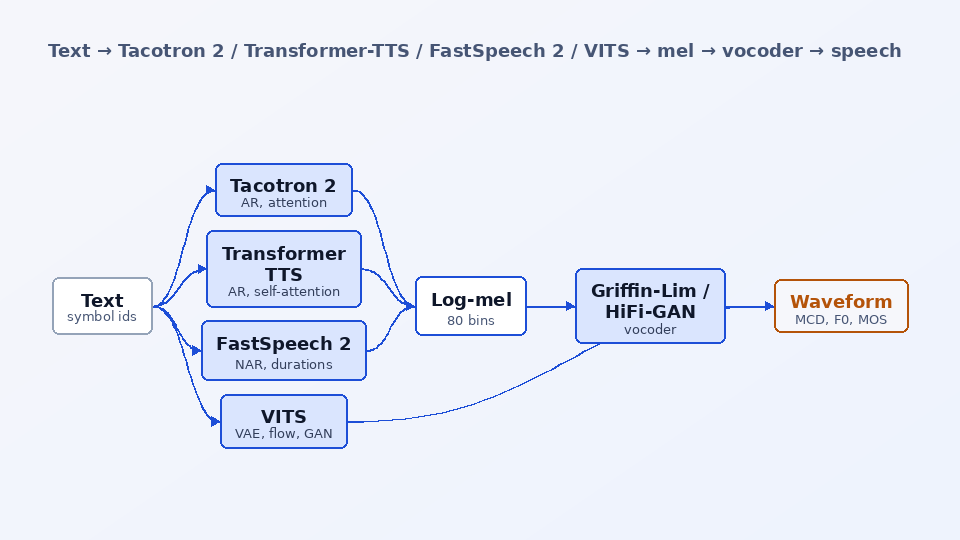
مرّ تحويل النص إلى كلام بعدة تصاميم في سنوات قليلة: نماذج انحدارية ذاتية بالانتباه، ونماذج غير انحدارية ذاتية بمُدد صريحة، ونماذج تبايُنية (variational) من طرف إلى طرف بتدريب تنافسي. بنيت كلاً منها في قاعدة كود PyTorch صغيرة واحدة، بنحو مليون معلمة لكل منها، بحيث يُظهر تشغيل واحد على CPU ما تفعله كل طريقة ويمكن قراءة كل سطر.
النماذج هي Tacotron 2 وTransformer-TTS وFastSpeech 2 وVITS، مع Griffin-Lim ومشفّر صوتي (vocoder) HiFi-GAN، ومحاذٍ مدمج ببحث محاذاة رتيب (monotonic alignment search) لمُدد المعلّم، ووحدة تقييم تقيس MCD على طول مسار DTW، وجذر متوسط مربع خطأ لوغاريتم F0، وأخطاء الجهر والمدة، وقطرية الانتباه، مع WER اختياري عبر Whisper وMOS متنبَّأ به عبر UTMOS. وتتشارك كلها تنظيم البيانات والمدرّب وصيغة نقاط الحفظ والتقييم.
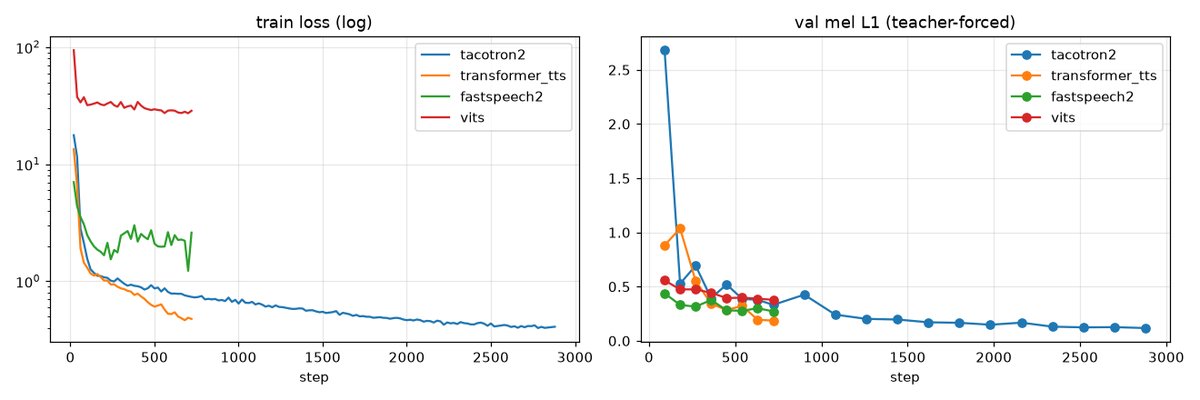
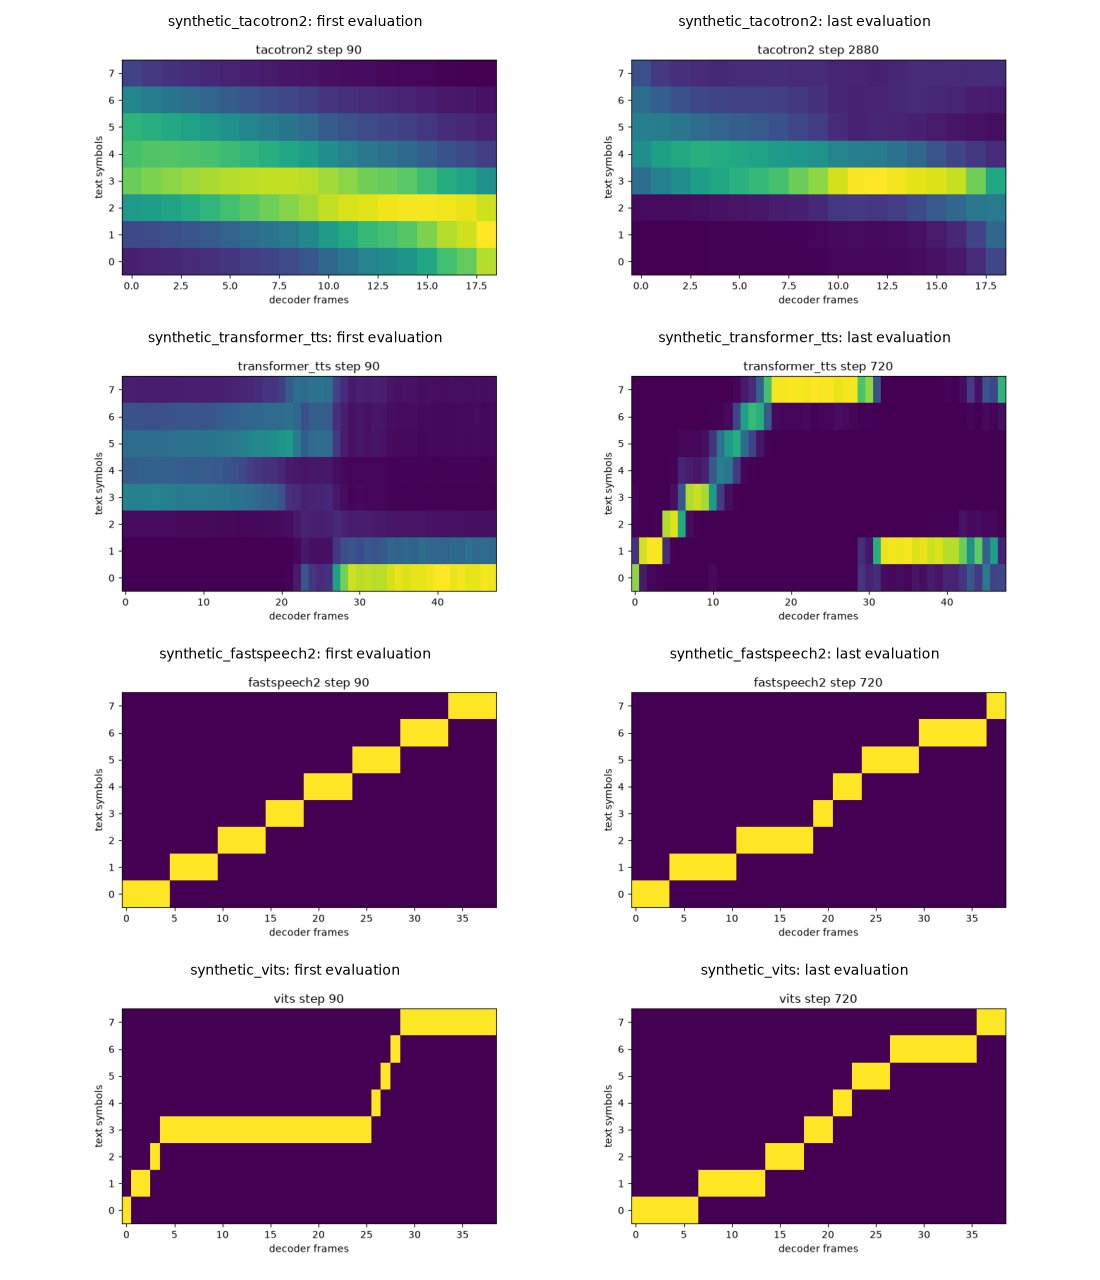
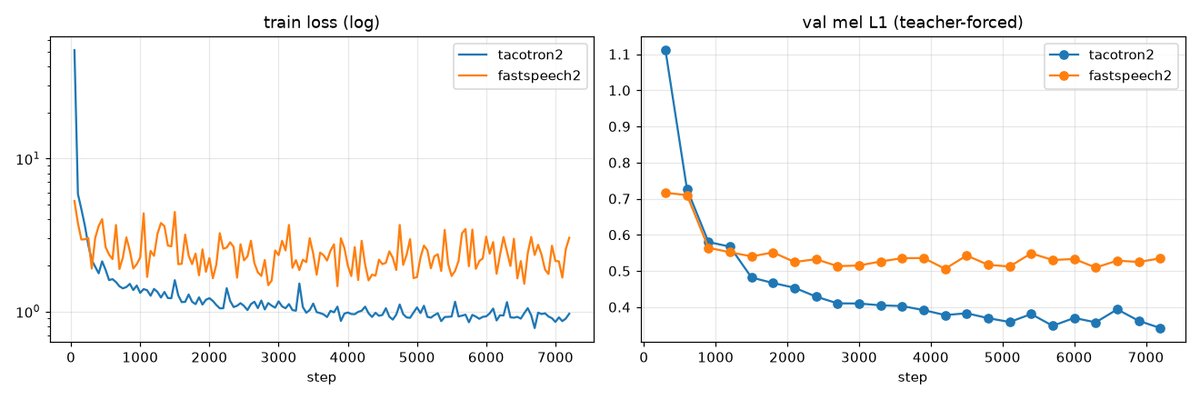
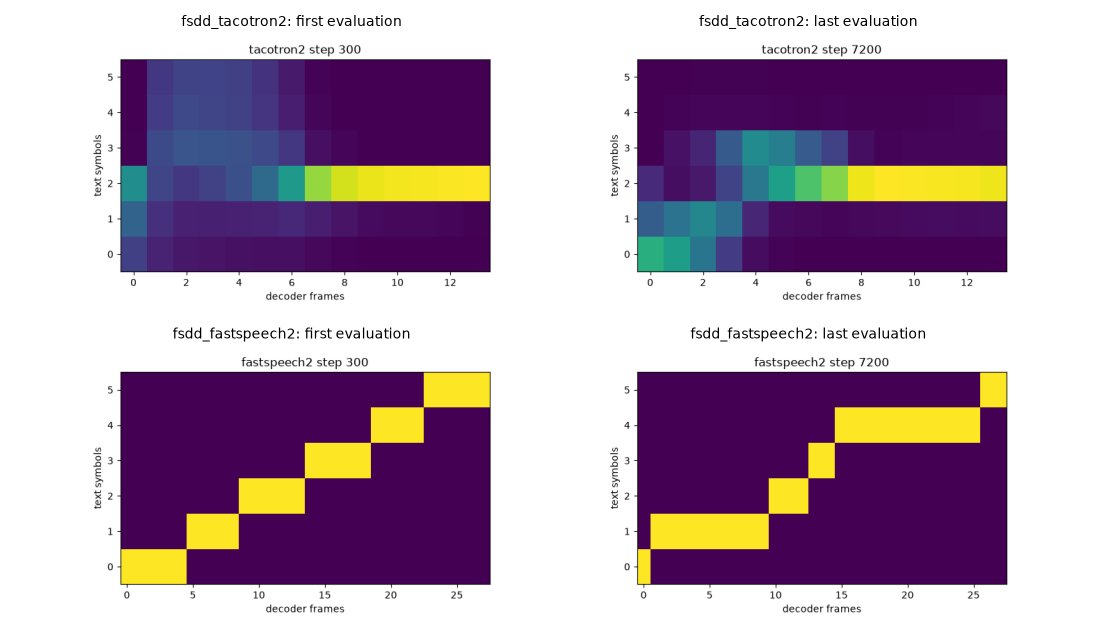
اختبرت كل شيء على بيانات بسيطة بتردد 8 kHz في تشغيلات قصيرة على CPU: لغة تجريبية اصطناعية وأرقام FSDD المنطوقة. على اللغة التجريبية يبلغ Transformer-TTS وFastSpeech 2 وVITS قيم MCD بين 12 و13 dB مقابل حد أدنى قدره 10.5 dB لإعادة التركيب بالنسخ (copy-synthesis)، بمحاذاات شبه قطرية؛ ويُظهر Tacotron 2 فشل الانتباه الكلاسيكي، ومشفّر HiFi-GAN الصوتي ناقص التدريب بوضوح عند هذه الميزانية. تقول الأرقام إن خط المعالجة والمقاييس يعملان، لا إن النماذج تنافس أنظمة LJSpeech.
السؤال
عندما تتشارك أربعة تصاميم لتحويل النص إلى كلام البيانات نفسها والمدرّب نفسه والمقاييس نفسها، أي أجزاء من كل منها تتعلم فعلاً، وماذا تكشف المقاييس الموضوعية مما تخفيه خسارة التدريب؟
أهم الميزات
- أربعة نماذج تركيب خلف راية (flag) واحدة: Tacotron 2 (انتباه حساس للموقع، ورمز توقف، وpostnet)، وTransformer-TTS (انتباه موجَّه)، وFastSpeech 2 (متنبئات المدة وطبقة الصوت والطاقة)، وVITS (VAE شرطي، وتدفق مُطبِّع، وGAN).
- مشفّران صوتيان لنماذج mel: إعادة بناء الطور بـ Griffin-Lim، وHiFi-GAN بمميِّزات متعددة الدورات ومتعددة المقاييس ومطابقة السمات.
- محاذٍ مدمج بخسارة forward-sum وبحث المحاذاة الرتيب، فلا يحتاج FastSpeech 2 إلى محاذٍ قسري خارجي.
- تضمين متحدث متعلَّم في كل نموذج لبيانات متعددة المتحدثين.
- مقاييس على التركيب الحر: MCD على طول مسار DTW، وجذر متوسط مربع خطأ لوغاريتم F0 بأنصاف النغمات، وخطأ الجهر والمدة، وقطرية الانتباه، وWER عبر Whisper وUTMOS اختيارياً.
- مجموعات بيانات مدمجة (اللغة التجريبية، وFSDD، وYESNO، وLJSpeech) ودفتر Kaggle/Colab مولَّد من مصدر الحزمة، تعمل نقاط حفظه مع واجهات سطر الأوامر.
- 34 اختباراً بنماذج مصغّرة على بيانات تجريبية في نحو 25 ثانية.
كيف يعمل
من النص إلى الرموز
يُطبَّع النص ويُجزَّأ إلى معرّفات رموز؛ وفي الجانب الصوتي مخطط طيفي log-mel محسوب بالإعدادات نفسها في كل مكان.
التنبؤ بـ mel أو بشكل موجي
يفك Tacotron 2 وTransformer-TTS الترميز إطاراً إطاراً بالانتباه والتلقين القسري (teacher forcing)؛ ويمدّد FastSpeech 2 كل رمز وفق مدته المتنبَّأ بها ويضيف طبقة الصوت والطاقة؛ ويحوّل VITS النص إلى كمون ويفك ترميز الشكل الموجي مباشرة.
تعلّم المحاذاة
تتعلمها نماذج الانتباه من البيانات بمساعدة خسارة انتباه موجَّه؛ ويحصل عليها FastSpeech 2 وVITS ببحث المحاذاة الرتيب على مصفوفة التشابه للمحاذي أو لمشفّر التوزيع البعدي (posterior encoder).
الترميز الصوتي
يتحول mel إلى صوت عبر Griffin-Lim أو عبر مولّد HiFi-GAN المدرَّب بخسائر تنافسية ومطابقة سمات وmel.
التقييم
يركّب tts-eval جمل التحقق، ويحاذي كلاً منها مع تسجيلها بـ DTW، ويبلّغ عن مقاييس MCD وF0 والجهر والمدة والمحاذاة، إلى جانب نقطتي مرجع إعادة التركيب بالنسخ والمتحدث نفسه.
أمثلة
المدخل
tts-eval --checkpoint checkpoints/fs2/best.pt --data-dir data/synthetic --n 15
المخرج
MCD 12.3 dB, log-F0 RMSE 3.0 st, voicing error 0.04, duration error 0.05, alignment diagonality 0.97 (Griffin-Lim; copy-synthesis floor 10.5 dB)
التقنيات المستخدمة
كل النماذج والمشفّرات الصوتية والخسائر والمحاذي والمدرّب
توليد اللغة التجريبية الاصطناعية ومساعدات المقاييس
منحنيات التدريب وشبكات المحاذاة
نصوص Whisper المفرَّغة لمقياس WER (إضافة اختيارية)
34 اختباراً بنماذج مصغّرة على بيانات تجريبية
دفتر مولَّد للتدريب الحقيقي على GPU مجاني
ما تعلمته
- خسارة التلقين القسري لا تخبرك أبداً بما إذا كان نموذج TTS القائم على الانتباه قادراً على التركيب؛ وحدها مقاييس التوليد الحر ومخطط المحاذاة تفعل ذلك
- مشفّر صوتي GAN غير متقارب يضيف نحو 2 dB إلى MCD ويدمّر طبقة الصوت؛ وعلى نطاق CPU يبقى Griffin-Lim هو المشفّر الصوتي الأمين
الحدود
- كل الأرقام تدريبات قصيرة على CPU ببيانات تجريبية وبيانات FSDD بتردد 8 kHz؛ ولم تُنشر نتائج على LJSpeech ولا أوزان مدرّبة مسبقاً
- مشفّرا HiFi-GAN الصوتيان (540 و1,200 خطوة) ناقصا التدريب، وTacotron 2 لم يتحاذَ قط على 285 جملة تجريبية
الكلمات المفتاحية
تحويل النص إلى كلام · TTS · تركيب الكلام · Tacotron 2 · Transformer-TTS · FastSpeech 2 · VITS · HiFi-GAN · Griffin-Lim · مشفّر صوتي عصبي · بحث المحاذاة الرتيب · MAS · انتباه حساس للموقع · مخطط طيفي mel · تشوه mel-cepstral · MCD · F0 · UTMOS · MOS · PyTorch · FSDD · LJSpeech