Text2Image
اثنتا عشرة معمارية لتوليد الصور من النص جنباً إلى جنب
الطرق الرئيسية لتوليد الصور من النص اليوم، منفَّذة بالبيانات نفسها ومشفّر النص نفسه والحلقة نفسها والمقيِّم نفسه، بحيث لا يتغير سوى المعمارية.
- مقارنة 13 نموذجًا
- U-Net: دقة 100% في السمات
- توليد بخطوة واحدة في 9 ms
التقنيات PyTorchCustom Transformers
 NumPy
 pytest
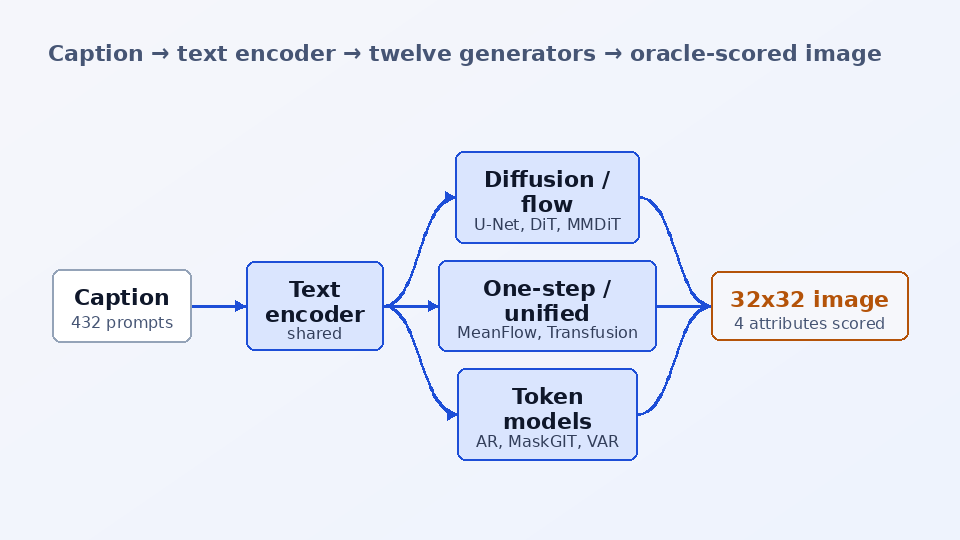
نظرة عامة
تُبنى أنظمة توليد الصور من النص على حفنة من عائلات المعماريات، من U-Net الخاص بـ Stable Diffusion إلى MMDiT على طريقة FLUX، وMeanFlow أحادي الخطوة، والنماذج الموحَّدة على طريقة Transfusion، وتنبؤ VAR بالمقياس التالي، والانحدار الذاتي (autoregression) بالرموز المتصلة في MAR، وتصفها الأوراق البحثية على نطاق لا يمكن معه مقارنة شيء على حاسوب محمول. نفّذت اثنتي عشرة منها جنباً إلى جنب في PyTorch، كل منها صغيرة بما يكفي للتدريب على CPU، خلف الواجهة نفسها: model.loss(images, tokens) وmodel.generate(tokens, cfg_scale).
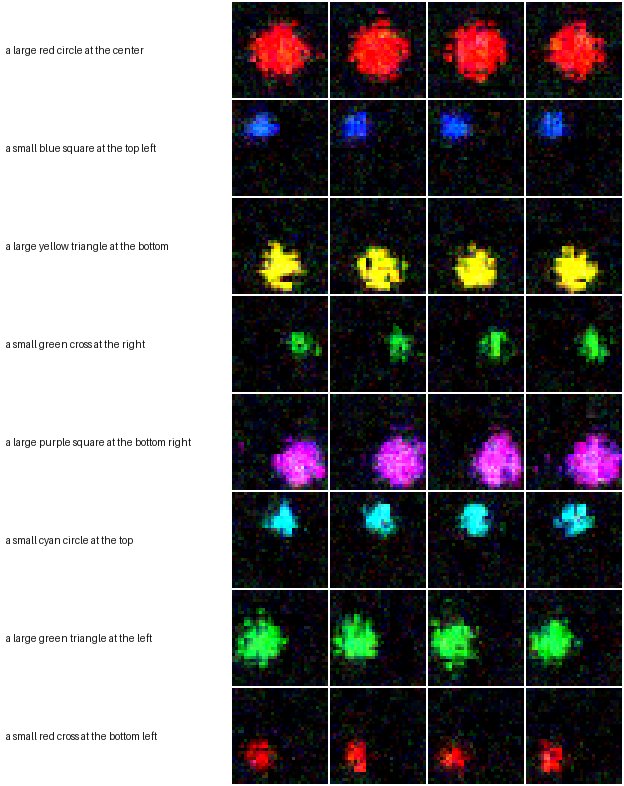
يتشارك كل نموذج البيانات نفسها ومجزّئ النص (tokenizer) ومشفّره نفسيهما وحلقة التدريب نفسها (AdamW، وإحماء ثم جدولة جيب التمام، وأوزان EMA، وقصّ التدرج) والتوجيه الخالي من المصنِّف (classifier-free guidance) نفسه، فلا يتغير بين التشغيلات سوى المعمارية. المعيار مهمة إجرائية لأشكال موصوفة بتعليقات: شكل ملوّن واحد على خلفية داكنة بحجم 32x32، موصوف بـ432 موجّهاً (prompt) عبر أربع خصائص مستقلة (الحجم واللون والشكل والموضع). شبكة CNN مرجعية (oracle) صغيرة تقرأ تلك الخصائص من الصورة بدقة تقارب 100% وتقيّم الصور المولَّدة لكل خاصية وللخصائص الأربع معاً، وهي نسخة مصغّرة من GenEval.
بعد 2,000 خطوة بدفعة 32، يصيب U-Net بتنبؤ v كل الخصائص (100%)، وتتبعه نماذج الرموز (MaskGIT بنسبة 77%، وMAR بنسبة 72%، وVAR بنسبة 65%)، أما محوّلات التدفق في فضاء البكسل فتصيب التخطيط لكنها تطمس الأشكال (DiT بنسبة 25%، وMMDiT بنسبة 34%). تبيّن أن هدف التنبؤ حاسم: نفس U-Net بتنبؤ ε يسجل 3%، وتنبؤ JiT بالصورة النظيفة يضاعف نتيجة DiT. ويعادل MeanFlow نتيجة DiT بتقييم واحد للشبكة بدلاً من 30.
السؤال
عندما تُثبَّت البيانات ومشفّر النص وحلقة التدريب والتقييم، كيف تتقارن المعماريات الرئيسية لتوليد الصور من النص في ربط كل كلمة من التعليق بالخاصية البصرية الصحيحة؟
أهم الميزات
- ستة نماذج بكسلية متصلة: U-Net + DDPM بتنبؤ v أو ε، وDiT بانتباه متقاطع (PixArt-α)، وJiT (تنبؤ x)، وMMDiT (التدفق المزدوج في SD3 / FLUX)، وDiT أحادي التدفق (الكتل المفردة في FLUX، وZ-Image)، وSANA بانتباه خطي وMix-FFN وبلا تضمين موضعي.
- MeanFlow، الذي يتعلم السرعة المتوسطة بهدف JVP بالنمط الأمامي ويولّد بتقييم واحد للشبكة، مع دمج التوجيه في التدريب.
- Transfusion: محوّل واحد يقرأ [التعليق؛ الرقع المشوشة] بقناع سببي على النص وانتباه ثنائي الاتجاه على الصورة، مدرَّب كنموذج لغوي للتعليقات ومزيل ضجيج للصور في آن واحد.
- أربعة نماذج رموز فوق VQ-VAE: الانحدار الذاتي بالرمز التالي، وفك الترميز المتوازي القائم على الثقة في MaskGIT، وتنبؤ VAR بالمقياس التالي فوق مكمِّم متبقٍّ متعدد المقاييس، ورموز MAR المتصلة برأس تدفق لكل رمز.
- مجزّئ كلمات مشترك ومشفّر نص محوّل صغير (بديل لـ CLIP / T5)، وحلقة تدريب واحدة وتوجيه خالٍ من المصنِّف لكل العائلات.
- تقييم آلي بشبكة CNN مرجعية: الدقة لكل خاصية ونسبة الصور التي أصابت الخصائص الأربع كلها، إضافة إلى سكربت بأمر واحد يدرّب الشبكة المرجعية والمجزّئات والنماذج الـ13 كلها ويبني مجلد النتائج.
- 44 اختباراً على الأشكال والتدرجات والعيّنة والمجزّئات وJVP وأقنعة الانتباه وفرط التخصيص، ومسح للأدبيات يربط كل نظام إنتاجي من 2025-2026 بالملف الذي ينفذ فكرته.
كيف يعمل
الرسم والتعليق
كل صورة تدريب شكل واحد مرسوم إجرائياً بحجم 32x32 من موجّه مثل «a small blue square at the top left»، مع اهتزاز عشوائي في الموضع والمقياس؛ وبنك مرسوم مسبقاً يبقي حلقة CPU سريعة.
تشفير النص
مجزّئ كلمات ومحوّل صغير ينتجان متتالية رموز للانتباه المتقاطع أو المشترك ومتجهاً مجمَّعاً لتعديل adaLN. تُستبدل 10% من الموجّهات بالموجّه الفارغ ليعمل التوجيه عند أخذ العينات.
التدريب بخسارة واحدة لكل عائلة
نماذج الانتشار والتدفق تنحدر على ε أو v أو x0 أو سرعة فوق بكسلات مشوشة؛ وMeanFlow ينحدر على السرعة المتوسطة عبر متطابقة MeanFlow؛ ونماذج الرموز تتنبأ برموز VQ (الرمز التالي أو الرموز المقنَّعة أو المقياس التالي) أو تشغّل رأس تدفق لكل رمز متصل.
التوليد بالتوجيه
كل generate() يجمع المخرجات الشرطية وغير الشرطية (ضجيج أو سرعة أو logits أو سرعة رأس التدفق) بمقياس 3.0؛ MeanFlow يأخذ العينات في خطوة واحدة، وMaskGIT في نحو 12، ونماذج الانتشار في 30.
التقييم بالشبكة المرجعية
شبكة CNN مدرَّبة على صور حقيقية تقرأ اللون والشكل والموضع والحجم من كل صورة مولَّدة لـ128 موجّهاً عشوائياً؛ ولا يسجّل النموذج في «الأربعة كلها صحيحة» إلا إذا ربط كل كلمة بالخاصية الصحيحة.
أمثلة
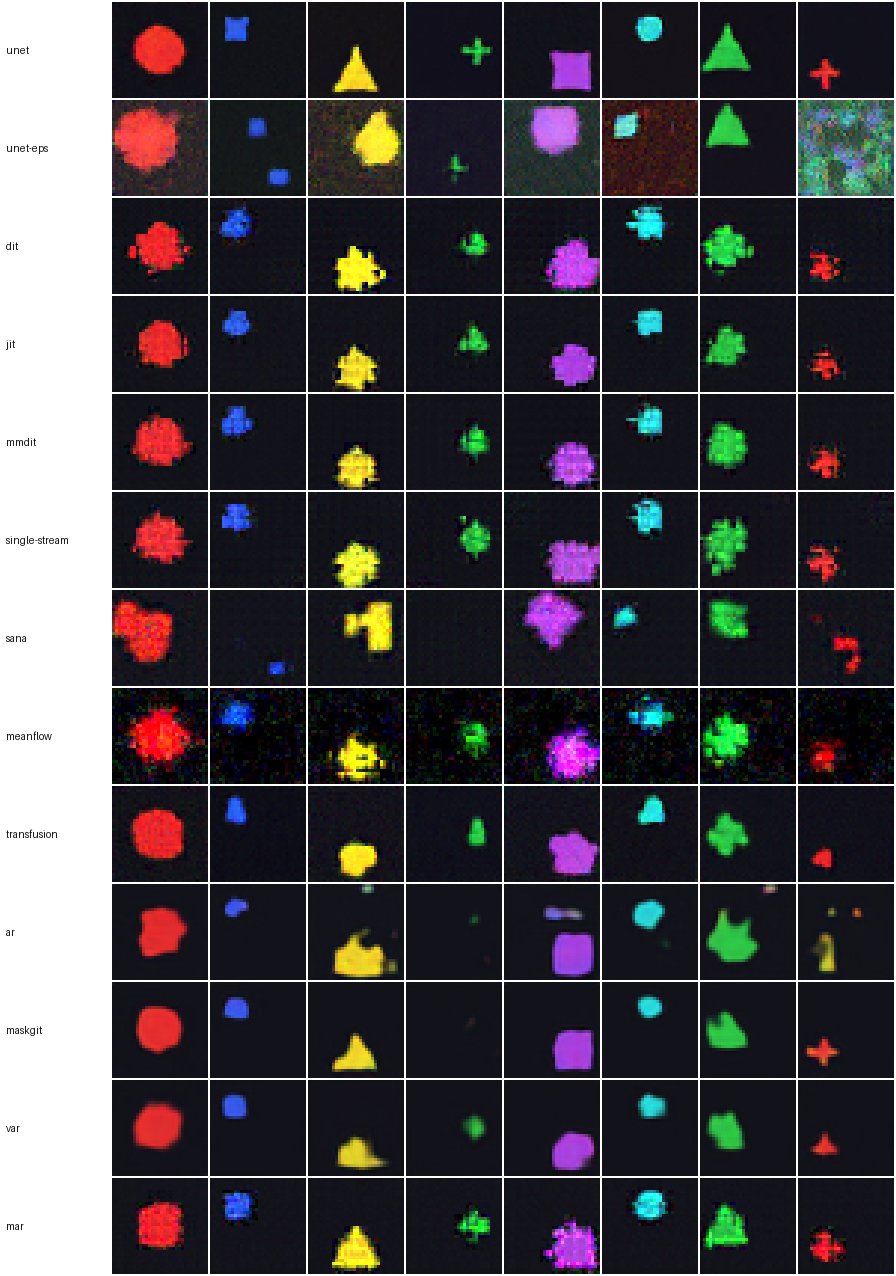
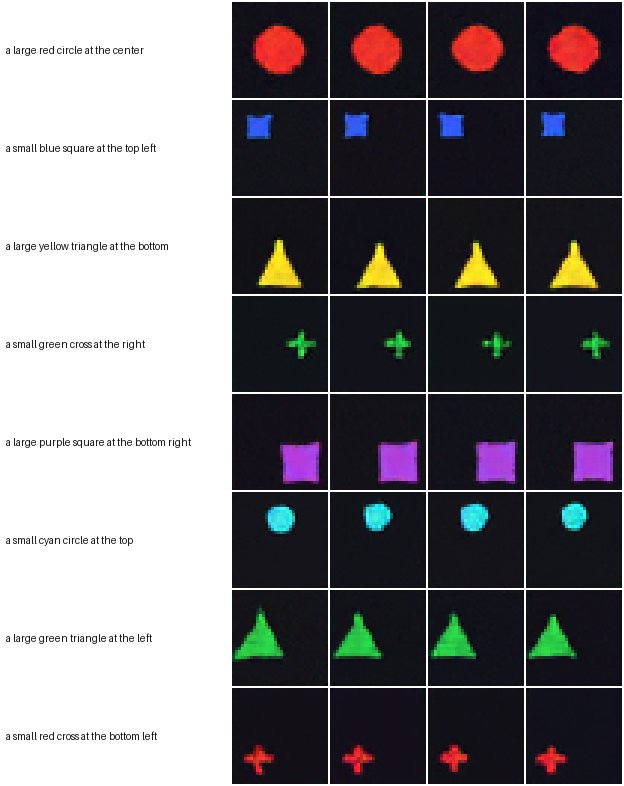
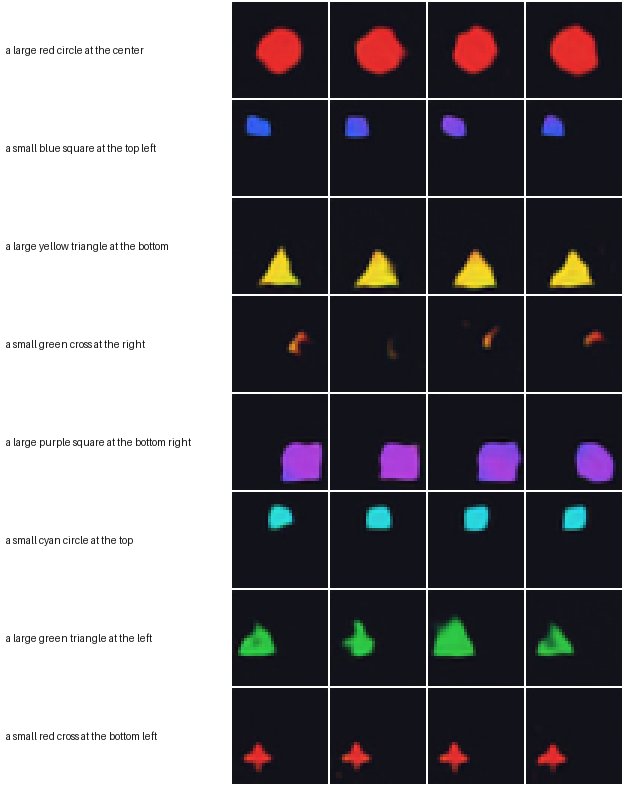
المدخل
transfusion.complete_caption("a small blue")
المخرج
"a small blue square at the top right"
المدخل
text2image-eval --ckpt runs/unet/model.pt --oracle runs/oracle/model.pt --n 128
المخرج
color 100% shape 100% position 100% size 100% all 4 correct 100%
التقنيات المستخدمة
ما تعلمته
- لا تزال الالتفافات (convolutions) تملك الانحياز الاستقرائي المناسب للأشكال الصغيرة الدقيقة على مستوى البكسل؛ أما المحوّلات (transformers) فتستبدله بقابلية توسّع لا تؤتي ثمارها إلا بعيداً جداً عن هذه المهمة
- نماذج الرموز (tokens) ذات مفكّك VQ هي أقوى المحوّلات عند تساوي الخطوات، لأن المحوّل لا يحتاج إلا إلى اختيار 64 رمزاً
- تصميم SANA بلا تضمين موضعي يحتاج إلى عمق: بـ4 كتل على شبكة 8x8 يبقى الموضع عند مستوى الصدفة
الحدود
- نطاق تجريبي صغير: فضاء بكسل 32x32، ونحو 1 M معلمة، و2,000 خطوة على CPU، ونتائج على 128 موجّهاً بخطأ معياري يقارب ±4%، ومعظم النماذج لم تتقارب بعد؛ والترتيب على نطاق الإنتاج (مليارات المعلمات وكمونات VAE) يختلف
الكلمات المفتاحية
توليد الصور من النص · Stable Diffusion · U-Net · DiT · MMDiT · FLUX · SANA · JiT · MeanFlow · Transfusion · توليد الصور الانحداري الذاتي · MaskGIT · VAR · MAR · VQ-VAE · flow matching · rectified flow · classifier-free guidance · v-prediction · GenEval · PyTorch