Text2Image
Douze architectures texte-vers-image côte à côte
Les principales façons de générer des images à partir de texte aujourd’hui, implémentées avec les mêmes données, encodeur de texte, boucle et évaluateur, pour que seule l’architecture change.
- 13 modèles comparés
- U-Net : 100 % des attributs corrects
- Échantillonnage en une étape, 9 ms
Construit avec PyTorchCustom Transformers
 NumPy
 pytest
Présentation
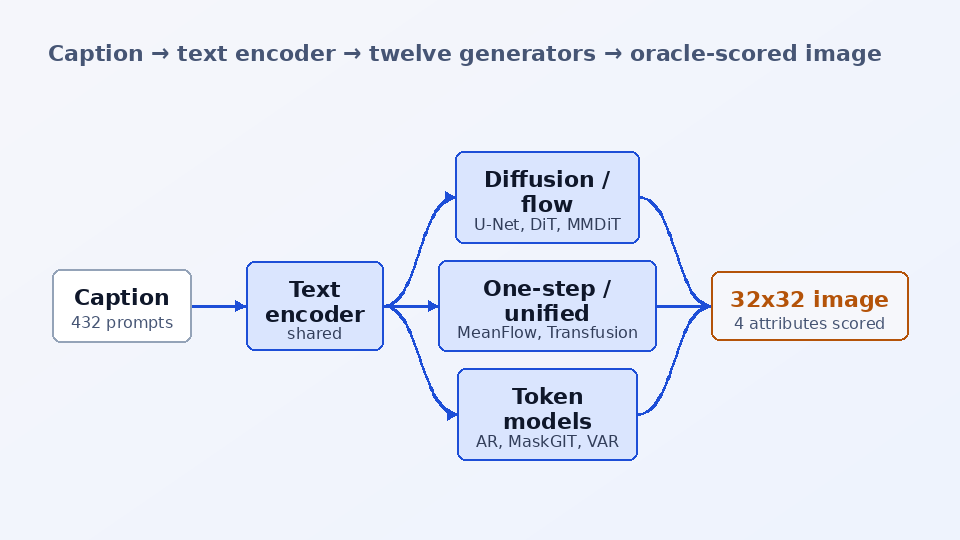
Les systèmes texte-vers-image reposent sur une poignée de familles d’architectures, du U-Net de Stable Diffusion au MMDiT à la FLUX, en passant par MeanFlow en une étape, les modèles unifiés à la Transfusion, la prédiction à l’échelle suivante de VAR et l’autorégression à tokens continus de MAR, et les articles les décrivent à une échelle où rien ne peut être comparé sur un ordinateur portable. J’en ai implémenté douze côte à côte en PyTorch, chacune assez petite pour s’entraîner sur CPU, derrière la même interface : model.loss(images, tokens) et model.generate(tokens, cfg_scale).
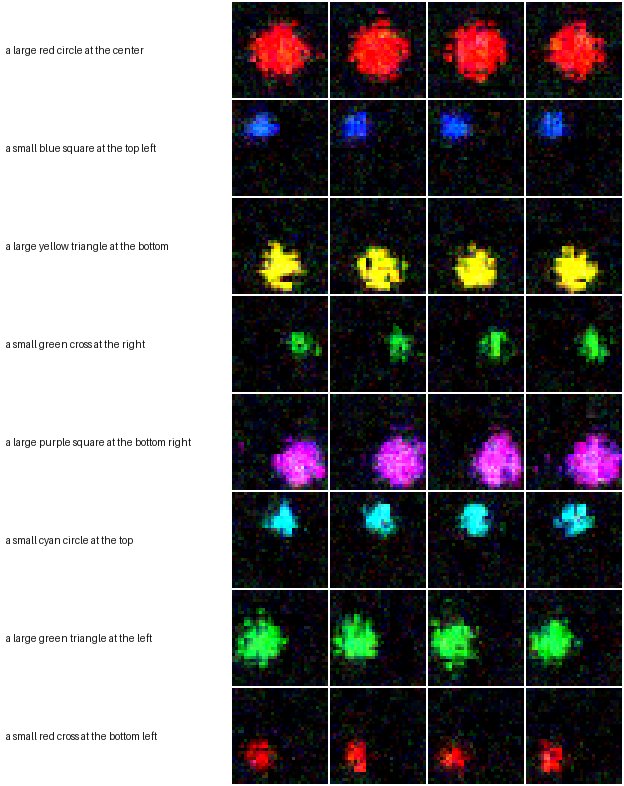
Chaque modèle partage les mêmes données, le même tokenizer et encodeur de texte, la même boucle d’entraînement (AdamW, warm-up puis planification cosinus, poids EMA, écrêtage du gradient) et le même classifier-free guidance, de sorte que la seule chose qui change entre les runs est l’architecture. Le benchmark est une tâche procédurale de formes légendées : une forme colorée sur fond sombre en 32x32, décrite par 432 prompts sur quatre attributs indépendants (taille, couleur, forme, position). Un petit oracle CNN lit ces attributs dans une image avec une précision d’environ 100 % et note les images générées par attribut et sur les quatre à la fois, une version jouet de GenEval.
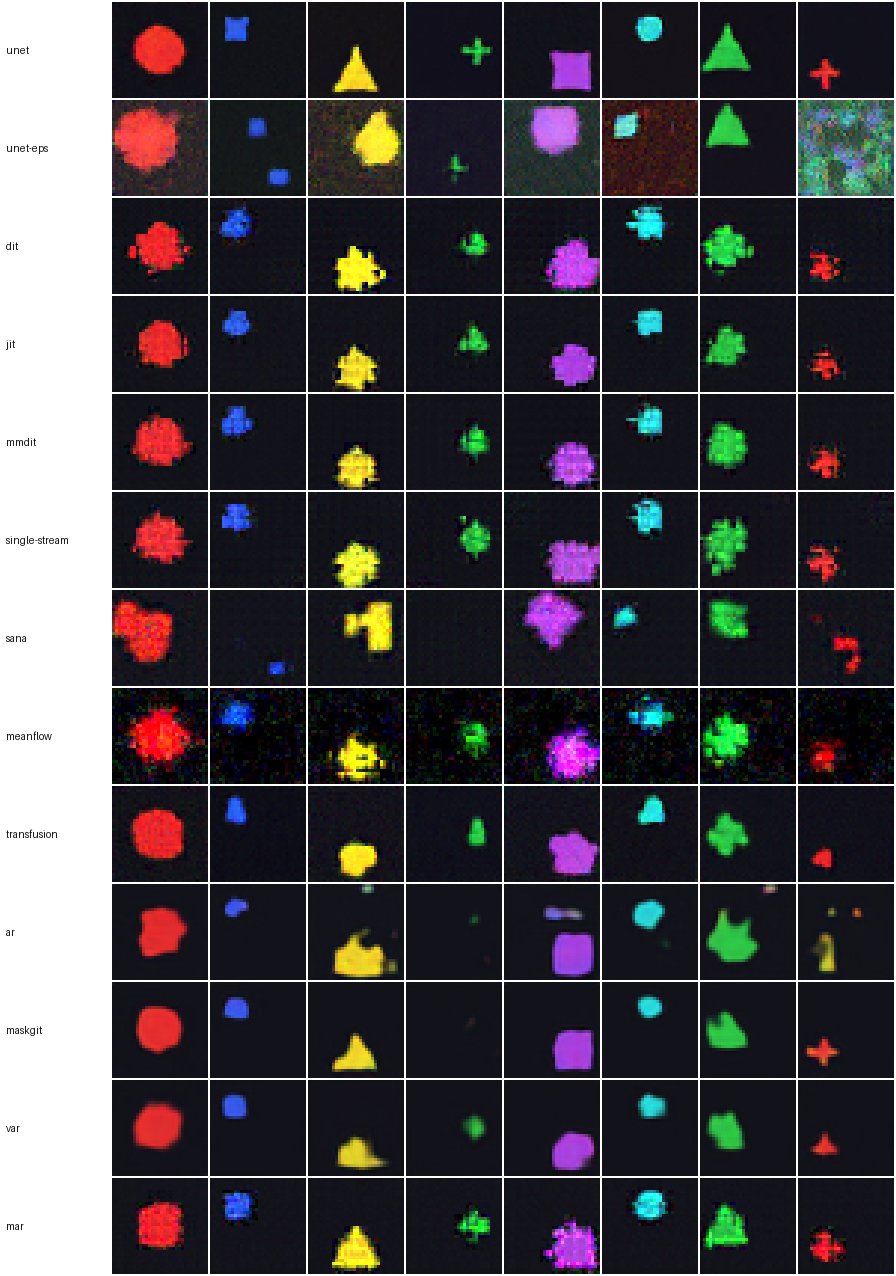
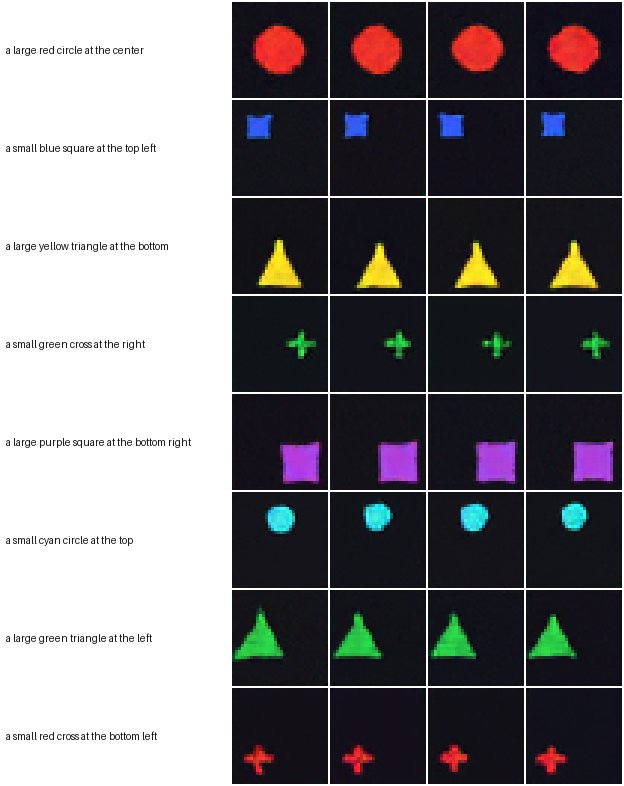
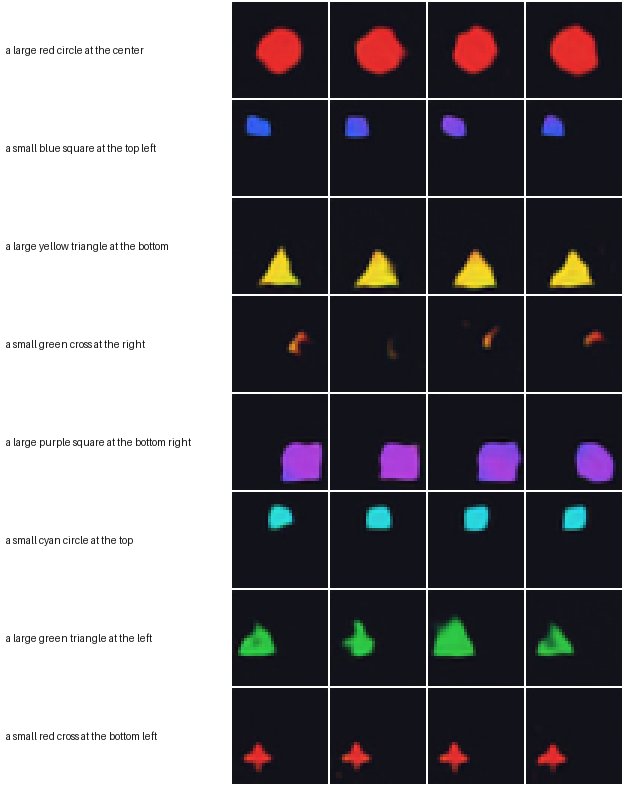
Après 2 000 pas avec un batch de 32, le U-Net en v-prediction réussit tous les attributs (100 %), les modèles à tokens suivent (MaskGIT 77 %, MAR 72 %, VAR 65 %) et les transformers de flux en espace pixel placent correctement mais floutent les formes (DiT 25 %, MMDiT 34 %). La cible de prédiction s’est révélée décisive : le même U-Net en ε-prediction obtient 3 %, et la prédiction d’image propre de JiT double le score de DiT. MeanFlow égale DiT avec une seule évaluation du réseau au lieu de 30.
La question
Quand les données, l’encodeur de texte, la boucle d’entraînement et l’évaluation sont fixés, comment les principales architectures texte-vers-image se comparent-elles pour associer chaque mot d’une légende à la bonne propriété visuelle ?
Fonctionnalités clés
- Six modèles en pixels continus : U-Net + DDPM avec prédiction v ou ε, DiT à attention croisée (PixArt-α), JiT (prédiction x), MMDiT (double flux SD3 / FLUX), un DiT à flux unique (blocs simples de FLUX, Z-Image) et SANA avec attention linéaire, Mix-FFN et sans embedding positionnel.
- MeanFlow, qui apprend la vitesse moyenne avec une cible JVP en mode direct et génère en une seule évaluation du réseau, avec le guidage intégré à l’entraînement.
- Transfusion : un seul transformer qui lit [légende ; patches bruités] avec un masque causal sur le texte et une attention bidirectionnelle sur l’image, entraîné à la fois comme modèle de langage sur les légendes et comme débruiteur d’images.
- Quatre modèles à tokens sur un VQ-VAE : autorégression token par token, décodage parallèle par confiance de MaskGIT, prédiction à l’échelle suivante de VAR sur un quantificateur résiduel multi-échelle, et tokens continus de MAR avec une tête de flux par token.
- Un tokenizer de mots partagé et un petit encodeur de texte transformer (un substitut de CLIP / T5), une seule boucle d’entraînement et un classifier-free guidance pour toutes les familles.
- Évaluation automatique avec un oracle CNN : précision par attribut et fraction d’images avec les quatre attributs corrects, plus un script en une commande qui entraîne l’oracle, les tokenizers et les 13 modèles et construit le dossier de résultats.
- 44 tests sur les formes, les gradients, l’échantillonnage, les tokenizers, le JVP, les masques d’attention et le surapprentissage, et une revue de littérature qui relie chaque système de production 2025-2026 au fichier qui implémente son idée.
Comment ça marche
Dessiner et légender
Chaque image d’entraînement est une forme dessinée procéduralement en 32x32 à partir d’un prompt tel que « a small blue square at the top left », avec un jitter aléatoire de position et d’échelle ; une banque pré-rendue garde la boucle CPU rapide.
Encoder le texte
Un tokenizer de mots et un petit transformer produisent une séquence de tokens pour l’attention croisée ou jointe et un vecteur agrégé pour la modulation adaLN. 10 % des prompts sont remplacés par le prompt nul pour que le guidage fonctionne à l’échantillonnage.
Entraîner avec une perte par famille
Les modèles de diffusion et de flux régressent ε, v, x0 ou une vitesse sur des pixels bruités ; MeanFlow régresse la vitesse moyenne via l’identité MeanFlow ; les modèles à tokens prédisent des codes VQ (token suivant, tokens masqués ou échelle suivante) ou font tourner une tête de flux par token continu.
Générer avec guidage
Chaque generate() combine les sorties conditionnelle et inconditionnelle (bruit, vitesse, logits ou vitesse de la tête de flux) à l’échelle 3,0 ; MeanFlow échantillonne en un pas, MaskGIT en environ 12, les modèles de diffusion en 30.
Noter avec l’oracle
Un CNN entraîné sur des images réelles lit la couleur, la forme, la position et la taille de chaque image générée pour 128 prompts aléatoires ; un modèle ne marque sur « les 4 corrects » que s’il associe chaque mot à la bonne propriété.
Exemples
Entrée
transfusion.complete_caption("a small blue")
Sortie
"a small blue square at the top right"
Entrée
text2image-eval --ckpt runs/unet/model.pt --oracle runs/oracle/model.pt --n 128
Sortie
color 100% shape 100% position 100% size 100% all 4 correct 100%
Stack technique
Les douze architectures, le VQ-VAE, l’encodeur de texte et la boucle d’entraînement
Custom Transformers
DiT, MMDiT, flux unique, SANA, Transfusion et les modèles à tokens, écrits à la main
Rendu procédural du jeu de données de formes légendées
44 tests, dont le JVP de MeanFlow et les masques d’attention de Transfusion et VAR
Ce que j’ai appris
- Les convolutions gardent le bon biais inductif pour de petites formes exactes au pixel ; les transformers l’échangent contre une scalabilité qui ne paie que bien au-delà de cette tâche
- Les modèles à tokens avec un décodeur VQ sont les transformers les plus forts à nombre de pas égal, parce que le transformer n’a qu’à choisir 64 codes
- Le choix de SANA de se passer d’embedding positionnel exige de la profondeur : avec 4 blocs sur une grille 8x8, la position reste au niveau du hasard
Limites
- Échelle jouet : espace pixel 32x32, environ 1 M de paramètres, 2 000 pas sur CPU, scores sur 128 prompts avec environ ±4 % d’erreur standard, et la plupart des modèles n’ont pas convergé ; les classements à l’échelle de production (milliards de paramètres, latents de VAE) diffèrent
Mots-clés
texte-vers-image · Stable Diffusion · U-Net · DiT · MMDiT · FLUX · SANA · JiT · MeanFlow · Transfusion · génération d’images autorégressive · MaskGIT · VAR · MAR · VQ-VAE · flow matching · rectified flow · classifier-free guidance · v-prediction · GenEval · PyTorch