TTS Workbench
Approches de synthèse vocale en PyTorch
Quatre modèles de synthèse vocale et un vocodeur neuronal, assez petits pour s’entraîner sur un ordinateur portable et se comparer sur les mêmes métriques.
- FastSpeech 2 : 12,3 dB de MCD
- 4 modèles TTS
Construit avec PyTorch
 NumPyMatplotlib
 Hugging Face Transformers
 pytest
 Kaggle
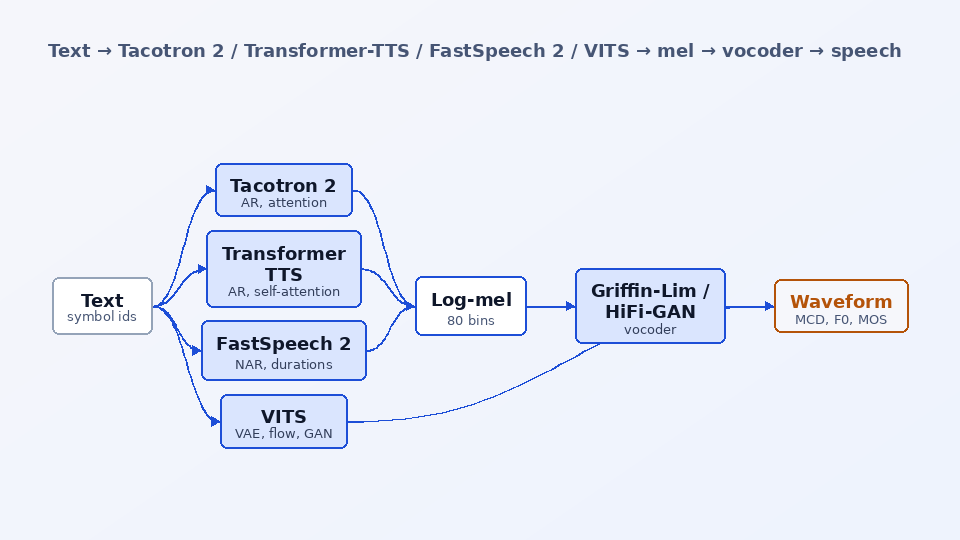
Présentation
La synthèse vocale a traversé plusieurs conceptions en quelques années : modèles autorégressifs à attention, modèles non autorégressifs à durées explicites, et modèles variationnels de bout en bout à entraînement adversarial. J’ai construit chacun d’eux dans une seule petite base de code PyTorch, d’environ un million de paramètres chacun, pour qu’un run sur CPU montre ce que fait chaque méthode et que chaque ligne puisse être lue.
Les modèles sont Tacotron 2, Transformer-TTS, FastSpeech 2 et VITS, avec Griffin-Lim et un vocodeur HiFi-GAN, un aligneur intégré avec recherche d’alignement monotone pour les durées enseignantes, et un module d’évaluation qui mesure la MCD le long d’un chemin DTW, la RMSE log-F0, les erreurs de voisement et de durée et la diagonalité de l’attention, avec en option le WER via Whisper et un MOS prédit avec UTMOS. Tous partagent l’organisation des données, l’entraîneur, le format de checkpoint et l’évaluation.
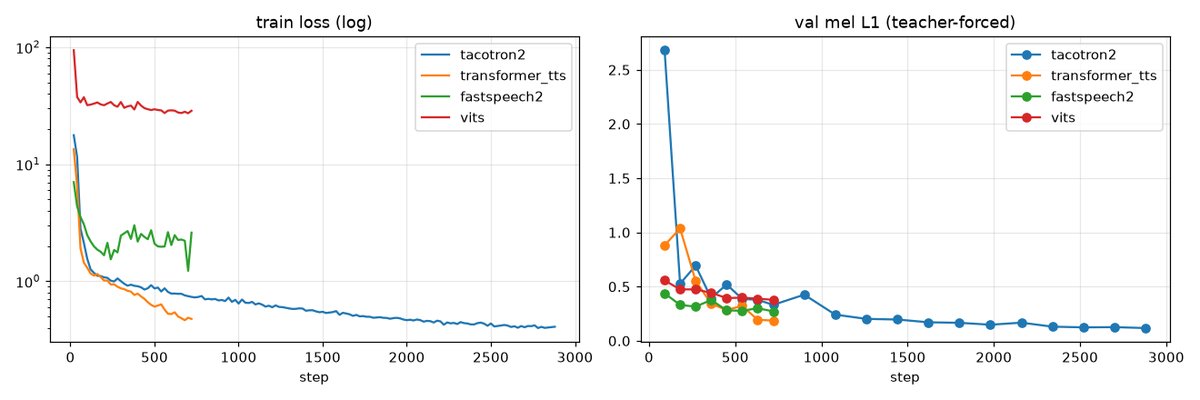
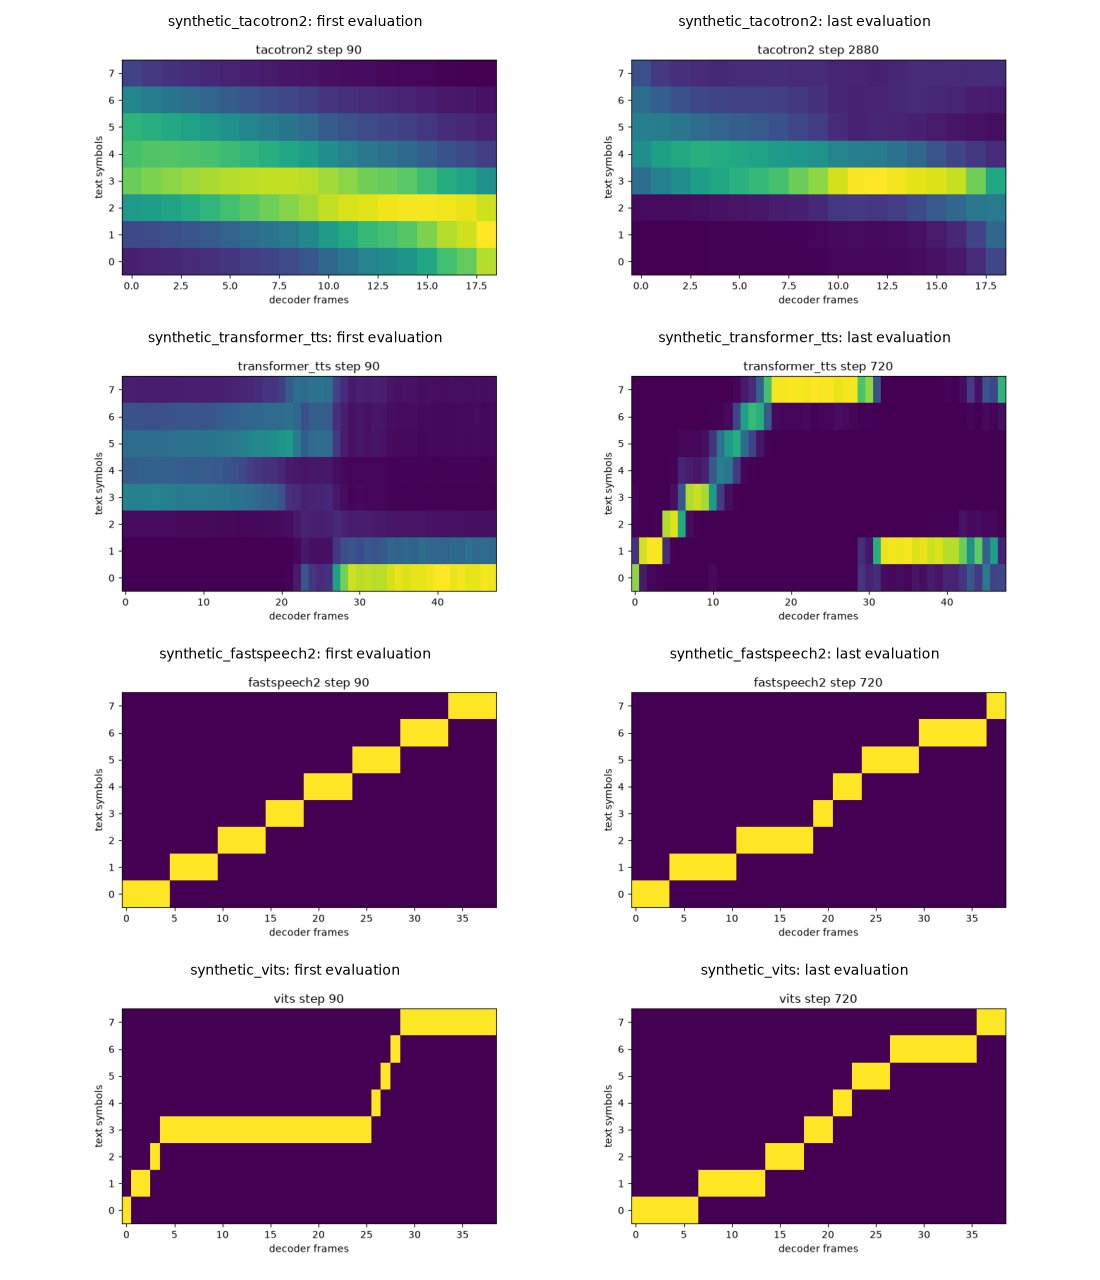
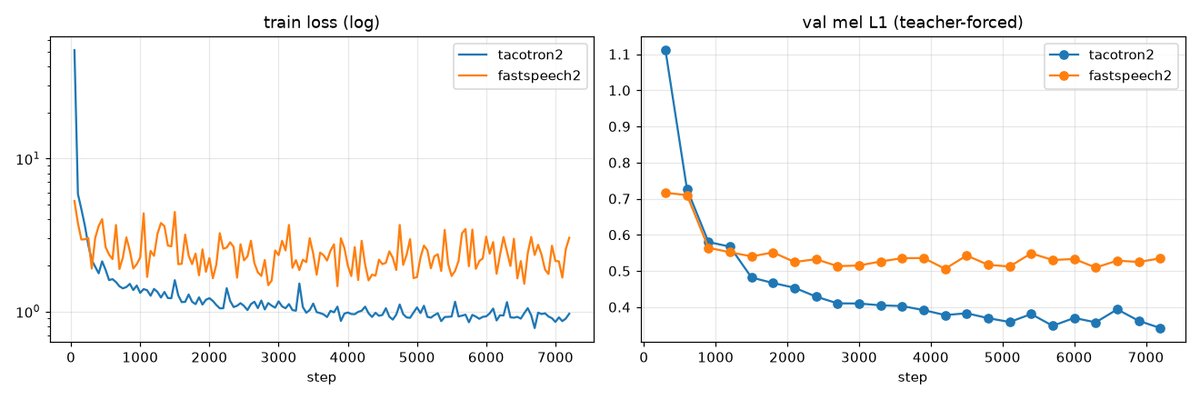
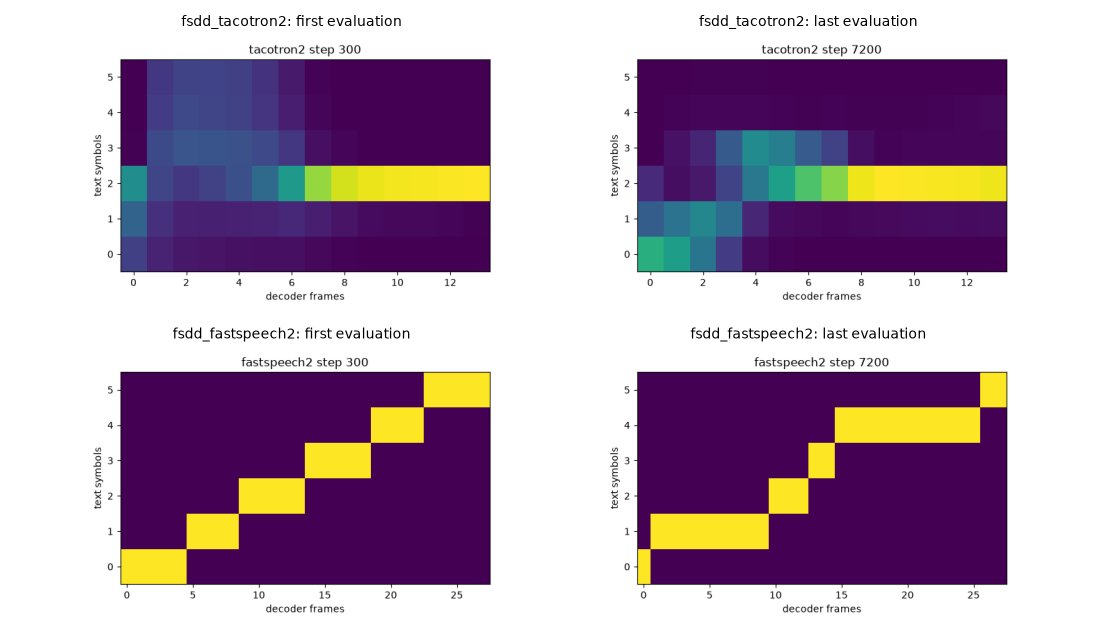
J’ai tout testé sur des données simples à 8 kHz en courts runs CPU : une langue jouet synthétique et les chiffres parlés FSDD. Sur la langue jouet, Transformer-TTS, FastSpeech 2 et VITS atteignent 12 à 13 dB de MCD contre un plancher de 10,5 dB en copie-synthèse, avec des alignements quasi diagonaux ; Tacotron 2 montre l’échec classique de l’attention, et le vocodeur HiFi-GAN est clairement sous-entraîné à ce budget. Les chiffres disent que le pipeline et les métriques fonctionnent, pas que les modèles rivalisent avec les systèmes LJSpeech.
La question
Quand quatre conceptions de TTS partagent les mêmes données, le même entraîneur et les mêmes métriques, quelles parties de chacune apprennent réellement, et que révèlent les métriques objectives que la perte d’entraînement cache ?
Fonctionnalités clés
- Quatre modèles de synthèse derrière un seul drapeau : Tacotron 2 (attention sensible à la position, stop token, postnet), Transformer-TTS (attention guidée), FastSpeech 2 (prédicteurs de durée, de hauteur et d’énergie) et VITS (VAE conditionnel, flux normalisant, GAN).
- Deux vocodeurs pour les modèles mel : reconstruction de phase Griffin-Lim et un HiFi-GAN avec discriminateurs multi-période et multi-échelle et feature matching.
- Un aligneur intégré avec la perte forward-sum et la recherche d’alignement monotone, pour que FastSpeech 2 n’ait besoin d’aucun aligneur forcé externe.
- Un embedding de locuteur appris dans chaque modèle pour les données multi-locuteurs.
- Métriques en synthèse libre : MCD le long d’un chemin DTW, RMSE log-F0 en demi-tons, erreurs de voisement et de durée, diagonalité de l’attention, et en option WER Whisper et UTMOS.
- Jeux de données intégrés (langue jouet, FSDD, YESNO, LJSpeech) et un notebook Kaggle/Colab généré depuis le source du package, dont les checkpoints fonctionnent avec les CLI.
- 34 tests avec des micro-modèles sur des données jouet en environ 25 secondes.
Comment ça marche
Du texte aux symboles
Le texte est normalisé et tokenisé en identifiants de symboles ; côté audio, un spectrogramme log-mel calculé partout avec les mêmes réglages.
Prédire un mel, ou une forme d’onde
Tacotron 2 et Transformer-TTS décodent trame par trame avec attention et teacher forcing ; FastSpeech 2 étire chaque symbole selon sa durée prédite et ajoute hauteur et énergie ; VITS projette le texte dans un latent et décode directement la forme d’onde.
Apprendre l’alignement
Les modèles à attention l’apprennent des données, aidés par une perte d’attention guidée ; FastSpeech 2 et VITS l’obtiennent par recherche d’alignement monotone sur la matrice de similarité de l’aligneur ou de l’encodeur a posteriori.
Vocoder
Un mel devient de l’audio via Griffin-Lim ou via le générateur HiFi-GAN, entraîné avec des pertes adversariale, de feature matching et mel.
Évaluer
tts-eval synthétise des phrases de validation, aligne chacune avec son enregistrement par DTW et rapporte les métriques MCD, F0, voisement, durée et alignement, à côté des points de référence copie-synthèse et même locuteur.
Exemples
Entrée
tts-eval --checkpoint checkpoints/fs2/best.pt --data-dir data/synthetic --n 15
Sortie
MCD 12.3 dB, log-F0 RMSE 3.0 st, voicing error 0.04, duration error 0.05, alignment diagonality 0.97 (Griffin-Lim; copy-synthesis floor 10.5 dB)
Stack technique
Tous les modèles, les vocodeurs, les pertes, l’aligneur et l’entraîneur
Génération de la langue jouet synthétique et utilitaires de métriques
Courbes d’entraînement et grilles d’alignement
Transcriptions Whisper pour la métrique WER (extra optionnel)
34 tests avec des micro-modèles sur des données jouet
Notebook généré pour l’entraînement réel sur un GPU gratuit
Ce que j’ai appris
- La perte en teacher forcing ne dit jamais si un modèle TTS à attention sait synthétiser ; seules les métriques en génération libre et le tracé d’alignement le disent
- Un vocodeur GAN non convergé ajoute environ 2 dB de MCD et détruit la hauteur ; à l’échelle d’un CPU, Griffin-Lim est le vocodeur honnête
Limites
- Tous les chiffres sont de courts entraînements sur CPU avec des données jouet et FSDD à 8 kHz ; aucun résultat LJSpeech ni poids pré-entraîné n’est publié
- Les vocodeurs HiFi-GAN (540 et 1 200 pas) sont sous-entraînés, et Tacotron 2 ne s’est jamais aligné sur 285 phrases jouet
Mots-clés
synthèse vocale · TTS · synthèse de la parole · Tacotron 2 · Transformer-TTS · FastSpeech 2 · VITS · HiFi-GAN · Griffin-Lim · vocodeur neuronal · recherche d’alignement monotone · MAS · attention sensible à la position · spectrogramme mel · distorsion mel-cepstrale · MCD · F0 · UTMOS · MOS · PyTorch · FSDD · LJSpeech