U-Net Image Segmentation
Six variantes de segmentation mesurées sur les mêmes données
Quels choix de conception du U-Net comptent vraiment : skip connections, pooling, profondeur des blocs et résidus, chacun réduit à un drapeau et à un chiffre.
- Pet : IoU 0,679 / Dice 0,809
- Skips : IoU 0,489 → 0,560
Construit avec PyTorchtorchvision
 pytestMatplotlib
 NumPy
 Kaggle
 Google Colab
Présentation
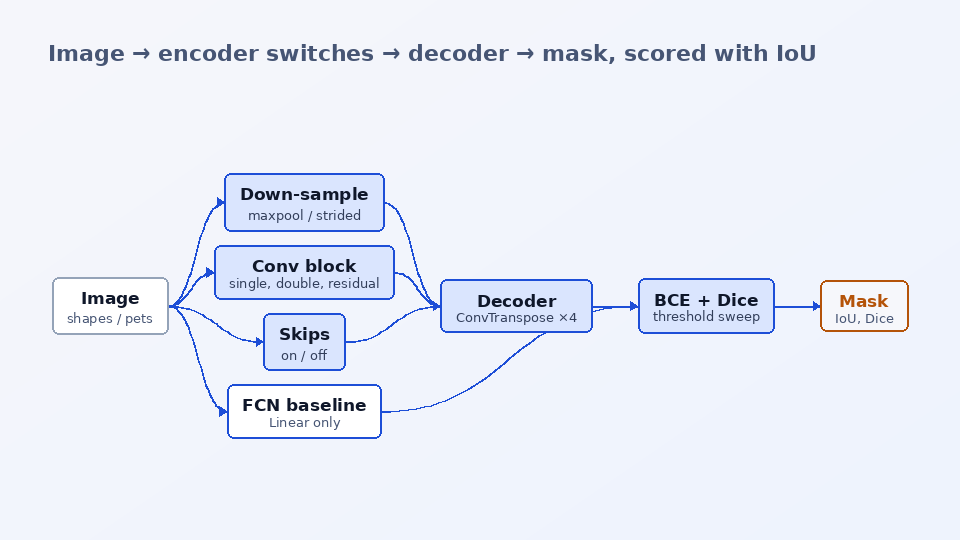
Tout a commencé par un notebook de cours de vision par ordinateur qui posait quatre questions sur le U-Net : le max-pooling bat-il une convolution à pas, qu’apportent les skip connections, comment un encodeur-décodeur se compare-t-il à un réseau entièrement connecté, et comment choisir le seuil d’inférence. Je l’ai reconstruit en un package où chaque question est un drapeau, les modèles sont petits (1 à 2M de paramètres, quelques minutes par run sur CPU) et chaque réponse est remesurée avec l’IoU et le Dice plutôt que la précision par pixel.
Six presets partagent une seule classe EncoderDecoder : le U-Net simple, une version à convolutions à pas, une version à convolution simple, une version résiduelle, un modèle de type SegNet sans skip connections, et une baseline entièrement connectée faite uniquement de couches Linear. Tous s’entraînent sur les mêmes formes synthétiques et sur un sous-ensemble d’Oxford-IIIT Pet, avec une perte BCE + Dice, et sont notés à partir d’une seule matrice de confusion. Un balayage de seuil sur la partition de validation choisit le seuil, jamais la partition de test.
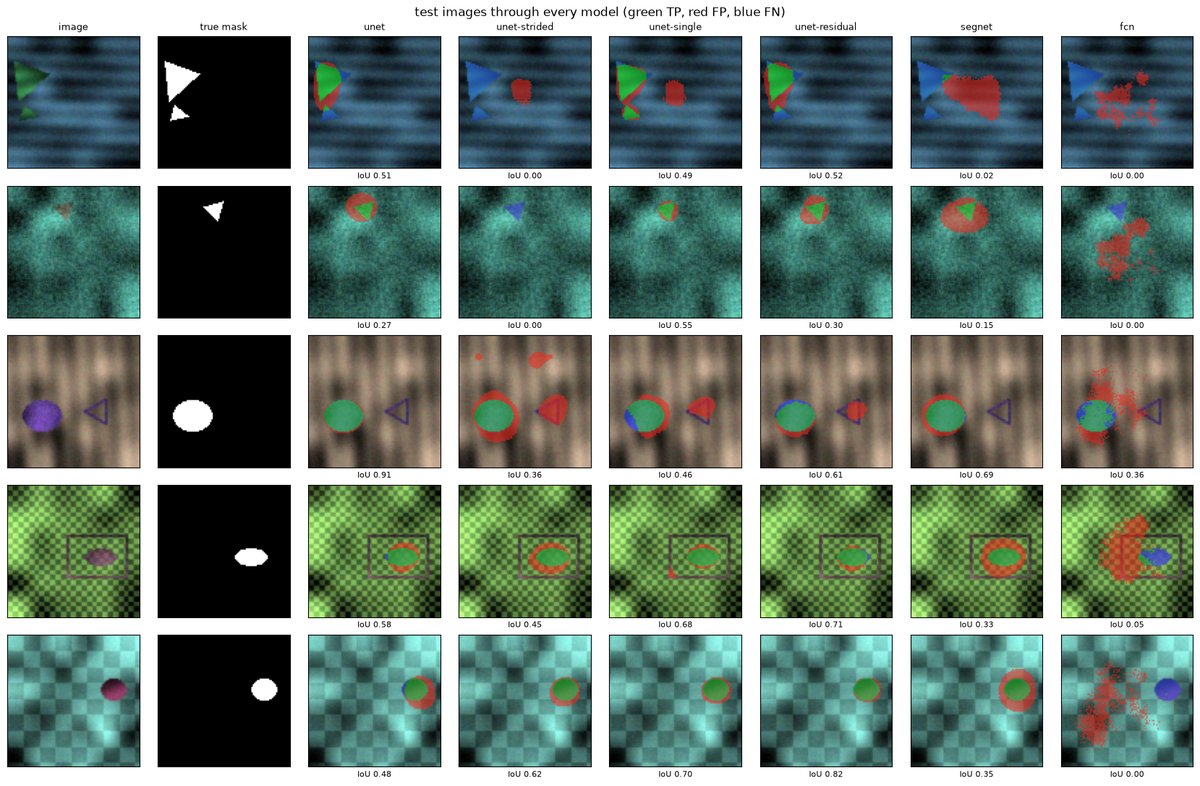
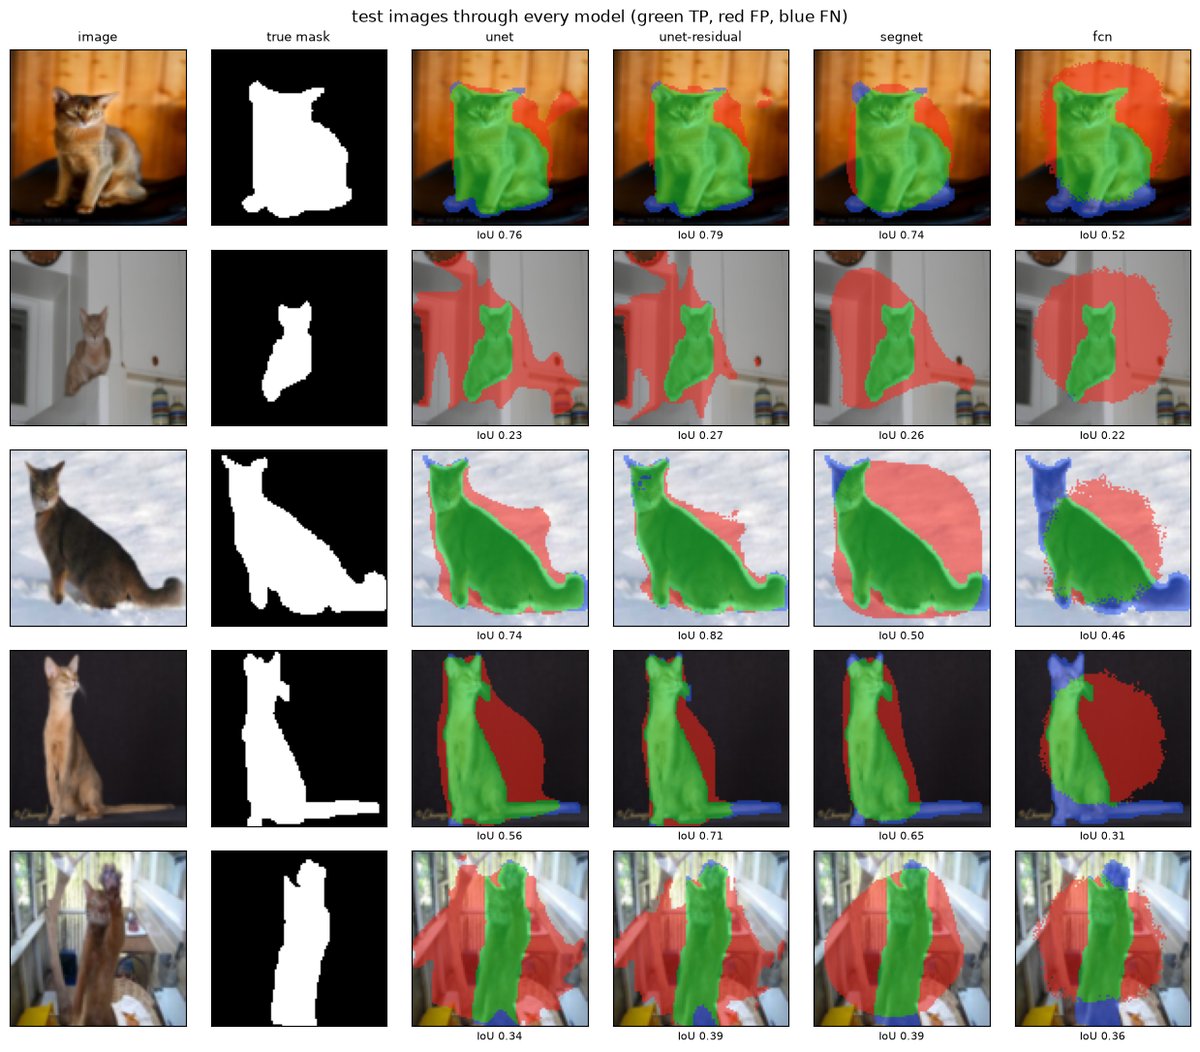
Sur les formes, le U-Net simple atteint 0,560 d’IoU test contre 0,422 pour les convolutions à pas et 0,489 sans skips ; le modèle entièrement connecté obtient 0,102 avec dix fois plus de paramètres. Sur les photos d’animaux, le U-Net résiduel mène à 0,679, puis le U-Net 0,641, sans skips 0,630 et entièrement connecté 0,524. Le portage du notebook a aussi révélé que ses jeux de validation et de test étaient augmentés, que son balayage de seuil allait de 40 à 80 au lieu de 0,40 à 0,80, et que son modèle entièrement connecté se terminait par un ReLU qui interdisait les logits négatifs.
La question
Qu’apportent chacun les skip connections, le max-pooling, les doubles convolutions et les blocs résiduels à un réseau de segmentation, quand chaque variante est entraînée sur les mêmes données et notée avec la même métrique ?
Fonctionnalités clés
- Six presets à partir d’une seule classe de modèle : unet, unet-strided, unet-single, unet-residual, segnet (sans skips) et fcn, plus des interrupteurs pour les combiner librement.
- La perte comme drapeau : BCE par pixel, Dice souple, ou les deux (par défaut), pour mesurer l’effet d’une perte de recouvrement sur les probabilités.
- Des métriques issues d’une seule matrice de confusion : IoU, Dice, précision par pixel, précision, rappel et IoU moyen par image ; les checkpoints sont sélectionnés sur l’IoU de validation.
- Un balayage de seuil de 0,1 à 0,9 sur la partition de validation, avec le score de test rapporté à 0,5 et au seuil choisi.
- Deux jeux de données via une seule commande : un générateur hors ligne de formes synthétiques (800 / 100 / 100 images en 4 secondes) et un sous-ensemble aléatoire d’Oxford-IIIT Pet avec masques binaires.
- Des scripts de comparaison et d’avant/après qui entraînent chaque variante sur les mêmes données, écrivent le tableau de résultats et enregistrent les prédictions après chaque époque en figures et en GIF.
- 29 vérifications pytest, dont un test que le U-Net surapprend un batch et que la tête entièrement connectée peut produire des logits négatifs, plus un notebook Kaggle / Colab qui explique chaque variante entre les cellules.
Comment ça marche
Sous-échantillonner quatre fois
Un ConvBlock d’entrée suivi de quatre étapes de descente divise la résolution par deux à chaque fois, par un max-pool 2 × 2 fixe ou une convolution 3 × 3 apprise de pas 2, avec une ou deux convolutions par bloc et un chemin résiduel optionnel.
Sur-échantillonner et concaténer
Quatre étapes ConvTranspose 2 × 2 ramènent le goulot d’étranglement à la taille d’origine ; avec les skips, chaque étape concatène la carte de l’encodeur de même taille, et sans skips le décodeur ne voit que le goulot d’étranglement.
Ou se passer des convolutions
La baseline entièrement connectée aplatit l’image, la fait passer par une pile de couches Linear et remet la sortie en forme, si bien qu’elle n’a ni localité ni hiérarchie.
Entraîner avec BCE + Dice
AdamW avec warm-up et décroissance cosinus, batch de 16, images de 96 px ; la BCE note chaque pixel et le Dice souple note le recouvrement, ce qui pousse les probabilités vers 0 ou 1.
Noter et choisir le seuil
Les probabilités au-dessus d’un seuil deviennent le masque ; IoU, Dice, précision et rappel se lisent sur une seule matrice de confusion, et le seuil est balayé sur la partition de validation avant de noter la partition de test.
Exemples
Entrée
unetseg-data shapes && python scripts/compare_all.py --data data/shapes --epochs 6 --max-train 600 --threads 1 --out runs/shapes
Sortie
test IoU: unet-single 0.660, unet-residual 0.633, unet 0.560, segnet 0.489, unet-strided 0.422, fcn 0.102 (Dice 0.796, 0.775, 0.718, 0.657, 0.593, 0.184); pixel accuracy above 0.83 for every model, including fcn.
Stack technique
Les variantes du modèle, les pertes, les métriques et la boucle d’entraînement
Téléchargement d’Oxford-IIIT Pet et augmentations jointes par défaut
29 vérifications sur les modèles, les partitions de données, les métriques et le surapprentissage d’un batch
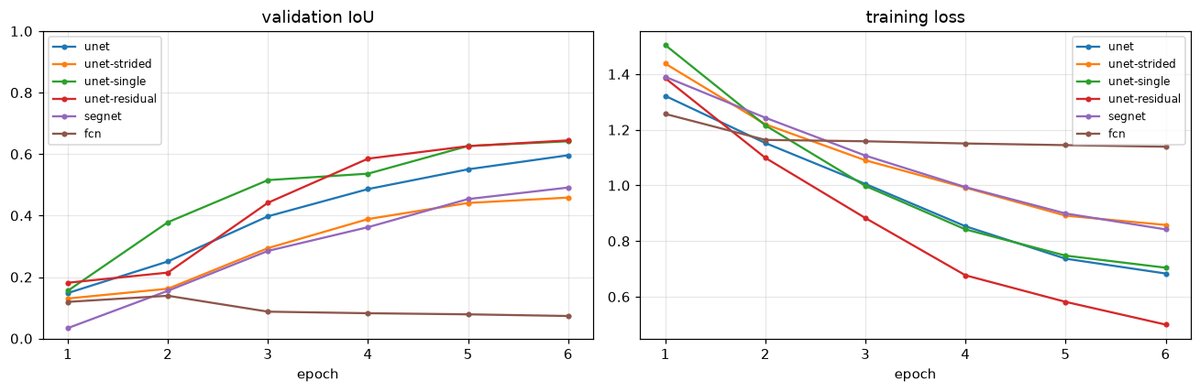
Courbes, grilles de prédictions, superpositions TP / FP / FN, tracés de seuil et de confusion
Générateur de formes et métriques de matrice de confusion
Notebook GPU qui entraîne un U-Net plus large sur les 7 390 photos de Pet
Le même notebook
Ce que j’ai appris
- La précision par pixel cache tout : chaque modèle sur les formes, y compris l’entièrement connecté, dépasse 0,83, donc l’IoU est le chiffre sur lequel sélectionner les checkpoints
- Les entraînements de six époques sont bruités : le même U-Net a atteint 0,47 ou 0,56 d’IoU test selon le seul nombre de threads, donc des écarts inférieurs à 0,1 entre lignes du tableau des formes sont du bruit
Limites
- Les chiffres sont de courts entraînements sur CPU (600 images d’entraînement, 96 px, 6 époques) destinés à comparer des variantes, pas des benchmarks ; l’entraînement GPU sur le jeu complet dans le notebook n’a pas de chiffres rapportés
- Les U-Net à convolution simple et résiduel devancent le U-Net simple après 6 époques parce qu’ils apprennent plus vite ; ce dernier progressait encore, donc l’ordre final est inconnu
Mots-clés
U-Net · segmentation d’images · segmentation binaire · skip connections · max-pooling vs convolution à pas · blocs résiduels · SegNet · réseau entièrement convolutif · perte Dice · IoU · balayage de seuil · Oxford-IIIT Pet · PyTorch · vision par ordinateur · apprentissage profond