PairVC
Conversion de voix en temps réel apprise sur des paires
Votre voix vers une voix cible, en direct : un petit réseau causal entraîné sur les paires d’un gros enseignant.
- MCD 6,53 → 2,70 dB
- Blocs de 20 ms, un cœur CPU
- Tourne dans le navigateur
Construit avec PyTorch
 ONNX
 Streamlit
 JavaScript
 Kaggle
Présentation
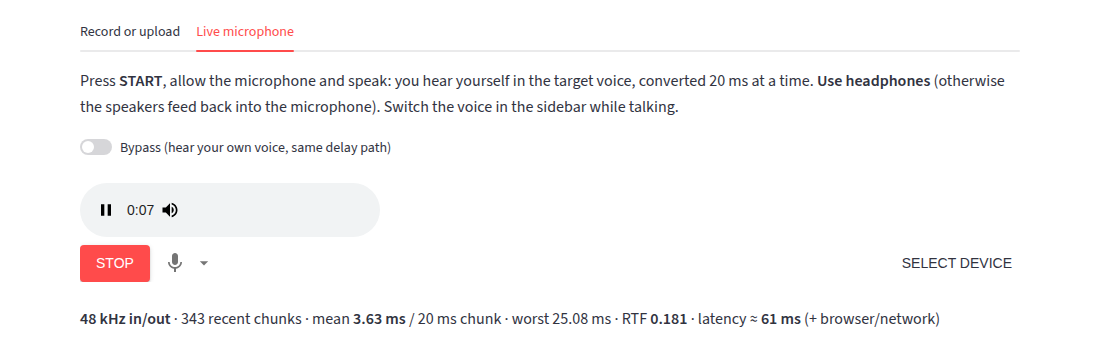
PairVC transforme votre voix en l’une de plusieurs voix cibles pendant que vous parlez. C’est un réseau entièrement causal, de forme d’onde à forme d’onde, qui convertit l’audio 20 ms à la fois sur un seul cœur de CPU.
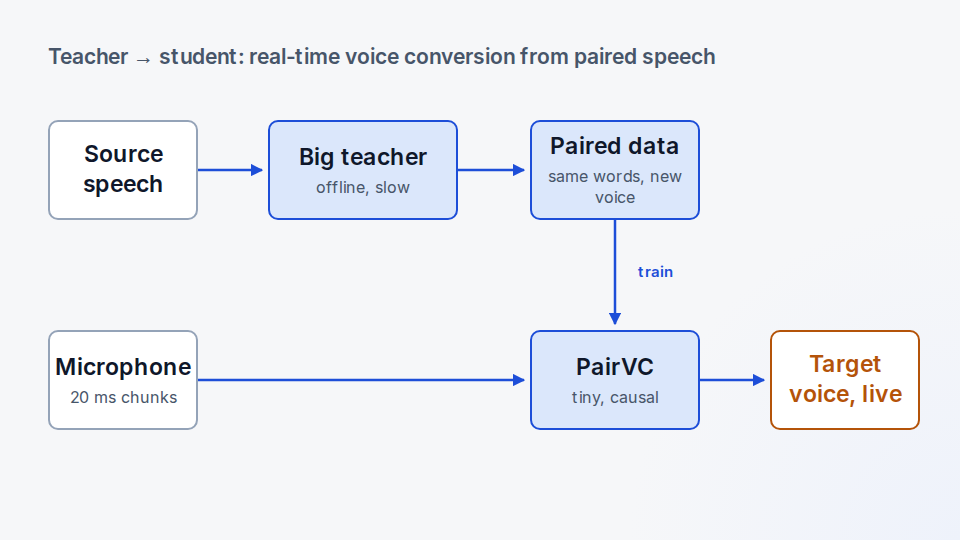
Il est entraîné sur des paires : chaque extrait source est accompagné de la même parole déjà convertie dans chaque voix cible par un gros enseignant lent, hors ligne. PairVC apprend à reproduire la sortie de l’enseignant et obtient ainsi ses voix pour une fraction du coût.
Il prolonge le travail de conversion de voix en temps réel commencé pendant mon mémoire de master (NatVC).
La question
Un petit réseau en streaming peut-il apprendre les voix d’un gros convertisseur lent assez bien pour tourner en direct sur un CPU ?
Fonctionnalités clés
- Entièrement causal : blocs de 20 ms, 60 ms de latence, un seul cœur de CPU
- Distillation enseignant → élève sur des paroles parallèles synthétiques
- Entraînement GAN : perte mel multi-échelle et discriminateurs de type HiFi-GAN
- Export ONNX, démo en direct dans le navigateur et application Streamlit avec micro en direct
- Métriques : MCD, erreur de F0, voisement, DNSMOS
Comment ça marche
Des paires produites par un enseignant
Un gros convertisseur hors ligne transforme chaque extrait source dans chaque voix cible ; ces paires forment le jeu d’entraînement.
Un petit réseau causal
Un encodeur convolutif causal compresse l’audio 320 fois en trames de 64 dimensions (une toutes les 20 ms), et un décodeur symétrique reconstruit la forme d’onde dans la voix cible, conditionné par FiLM.
Conversion en direct
Exporté en ONNX, le modèle traite le micro par blocs de 20 ms, en Python ou directement dans le navigateur.
Exemples
Stack technique
Le modèle, les pertes GAN et l’entraînement distribué
Export et inférence en temps réel, en Python et dans le navigateur
Application de démonstration avec micro en direct
Démo dans le navigateur avec ONNX Runtime Web et un AudioWorklet
Notebook d’entraînement sur GPU
Ce que j’ai appris
- Un échauffement uniquement sur la perte mel, avant les pertes GAN, a permis au petit modèle de dépasser le stade où il n’apprenait aucune harmonique.
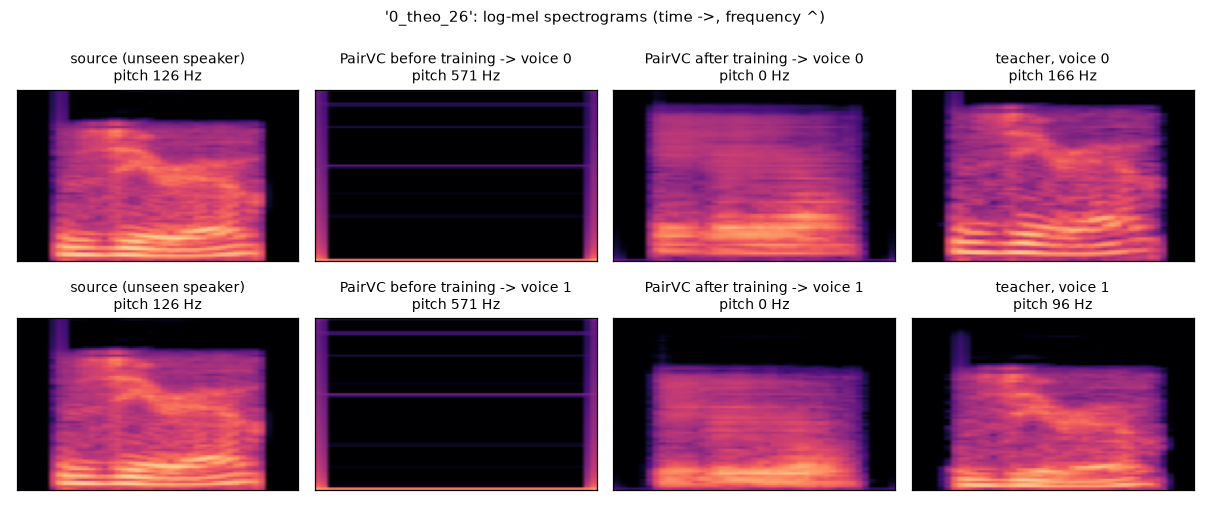
- Les métriques objectives (MCD, erreur de F0, voisement, DNSMOS) en disent plus que la perte : le timbre a été appris avant la hauteur.
Limites
- Le petit modèle entraîné sur CPU n’a pas encore appris la hauteur cible : la voix reste soufflée, et le modèle complet sur GPU est la prochaine étape.
- Aucun convertisseur pré-entraîné n’est publié, seulement le petit modèle de démonstration.
Projets liés
JointVC — Conversion de voix démêlée, entraînée en une seule passe
Privé pour l’instant : j’explore encore cette recherche, le code n’est donc pas encore publié.
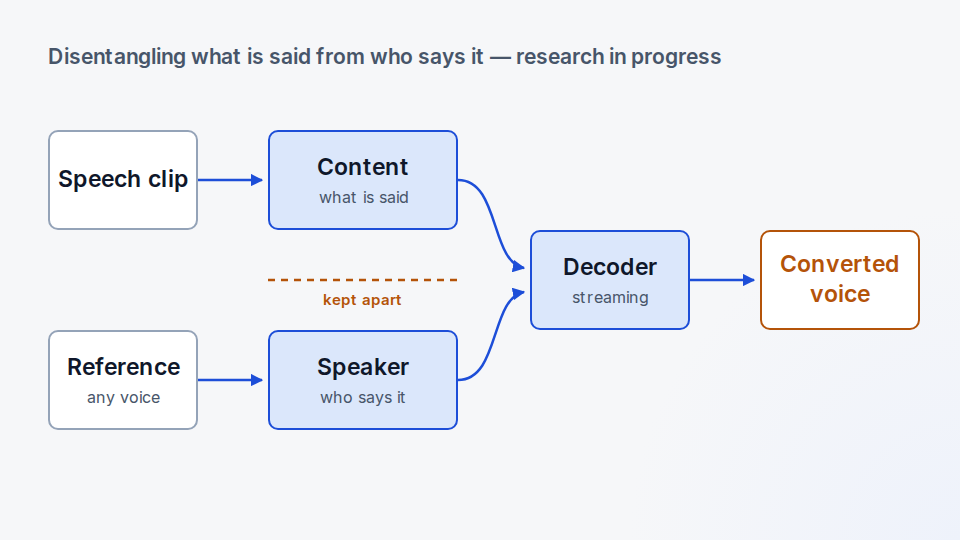
Recherche en cours : un petit convertisseur de voix en temps réel dont l’encodeur de contenu, l’encodeur de locuteur et le décodeur apprennent ensemble, et la question ouverte au cœur du projet, le démêlage (disentanglement) : garder qui parle hors de ce qui est dit.
Construit avec:
PyTorchONNX Hugging Face Transformerstorchaudio
NatVC — Conversion vocale neuronale en temps réel
Code privé (travail en entreprise / pour un client)
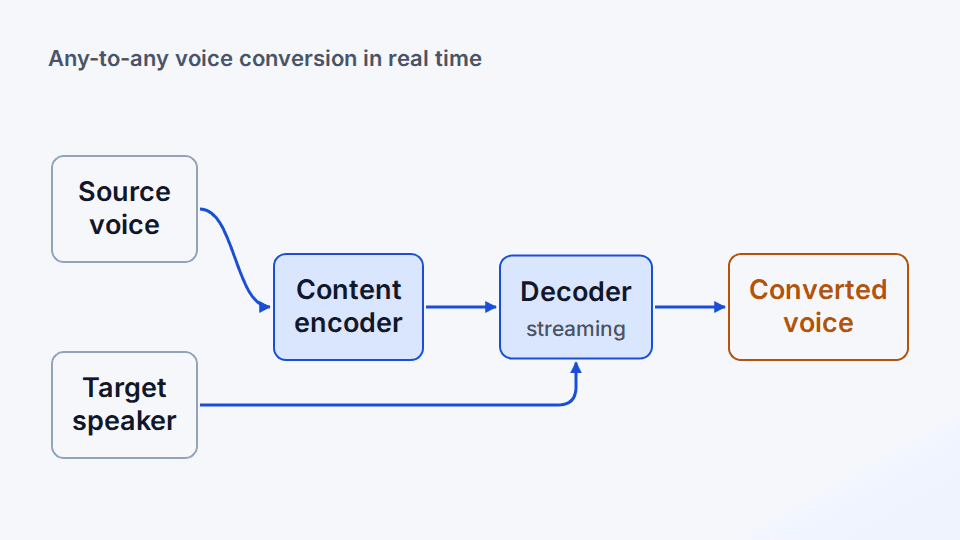
Conversion vocale any-to-any qui tourne en temps réel sous le budget de latence d'une application live — mon mémoire de master à Centrale Lyon, réalisé pendant mon stage chez SteelSeries.
Construit avec:
PyTorchAccelerate (multi-GPU)StreamVCLLVC TensorBoard

