JointVC
Conversion de voix démêlée, entraînée en une seule passe
Apprendre à un réseau ce qui est dit et à un autre qui le dit, en même temps, sans les laisser se mélanger.
- Recherche en cours
- Entraîné en une seule passe
- Sans audio cible
Construit avec PyTorch
 ONNX
 Hugging Face Transformerstorchaudio
Privé pour l’instant : j’explore encore cette recherche, le code n’est donc pas encore publié.
Présentation
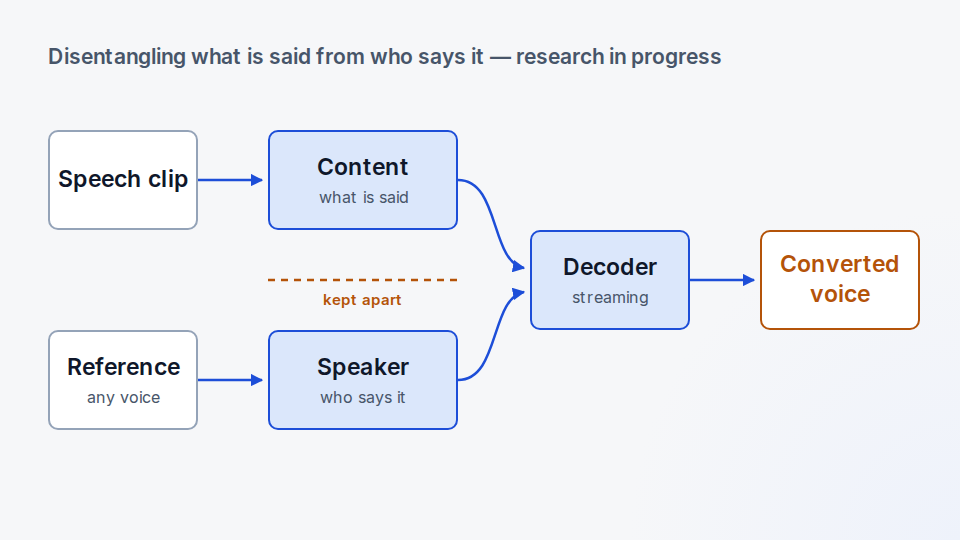
JointVC est la recherche sur laquelle je travaille en ce moment, et je suis encore en train de la découvrir. C’est un petit convertisseur de voix en streaming, de n’importe quelle voix vers n’importe quelle voix, de la famille StreamVC : un encodeur de contenu entend ce qui est dit, un encodeur de locuteur entend qui le dit, et un décodeur reconstruit la parole dans n’importe quelle voix, 20 ms à la fois.
Le concept au cœur du projet est le démêlage (disentanglement) : le contenu doit porter les mots mais aucune trace du locuteur, et l’empreinte du locuteur doit porter la voix mais pas les mots. StreamVC y parvient en entraînant par étapes. Mon idée est d’entraîner les trois réseaux ensemble, en une seule passe, sans audio cible, de les garder séparés avec des défenses explicites contre les fuites, et de mesurer la fuite au lieu d’affirmer qu’elle a disparu.
Ce projet reste privé pour l’instant : je continue à l’explorer et j’y vois du potentiel, le code reste donc fermé jusqu’à ce que les questions ouvertes soient résolues.
La question
Un convertisseur de voix peut-il apprendre ce qui est dit et qui le dit en un seul entraînement conjoint, sans audio cible, tout en gardant les deux séparés ?
Fonctionnalités clés
- Contenu, locuteur et décodeur entraînés ensemble dès la première étape, sans audio cible
- Défenses contre les fuites : inversion de gradient, effaceur LEACE, projection du gradient de fuite et goulot d’étranglement d’unités
- Une branche harmonique (DDSP) dans le décodeur, avec la hauteur et l’intensité prises de la référence
- Des sondes indépendantes qui tentent de retrouver le locuteur à partir du contenu, à chaque validation
- Évaluation MOS, WER, PESQ et STOI
Stack technique
Les trois réseaux, les défenses contre les fuites et la boucle d’entraînement
Export pour le streaming
Modèles de parole pré-entraînés utilisés comme juges et comme cibles de contenu optionnelles
Chargement de l’audio et caractéristiques
Ce que j’ai appris
- Le démêlage doit se mesurer avec des attaques indépendantes, jamais se supposer : des statistiques qui indiquent « indépendant » peuvent encore être contredites par une simple sonde.
Limites
- Recherche en cours : les défenses qui fonctionnent sur les données jouets ne se transfèrent pas encore à la vraie parole, et le timbre de la voix convertie n’est pas encore juste.
Projets liés
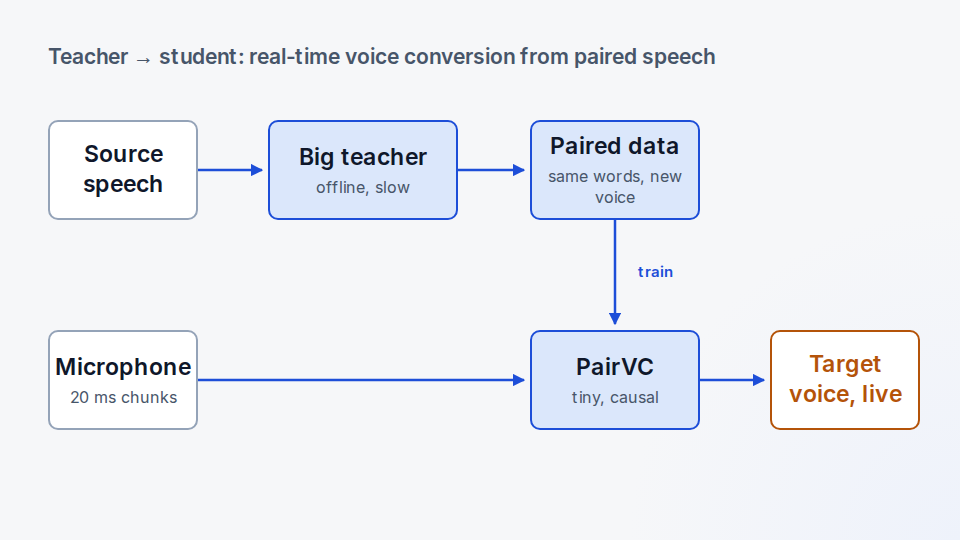
PairVC — Conversion de voix en temps réel apprise sur des paires
GitHub: PairVCDémo en ligne: PairVC
Un petit convertisseur de voix causal qui transforme votre voix en une voix cible en direct, 20 ms à la fois sur un seul cœur de CPU. Il apprend d’un gros modèle enseignant hors ligne, sur des paires de paroles.
Construit avec:
PyTorchONNX Streamlit
 JavaScript
 Kaggle
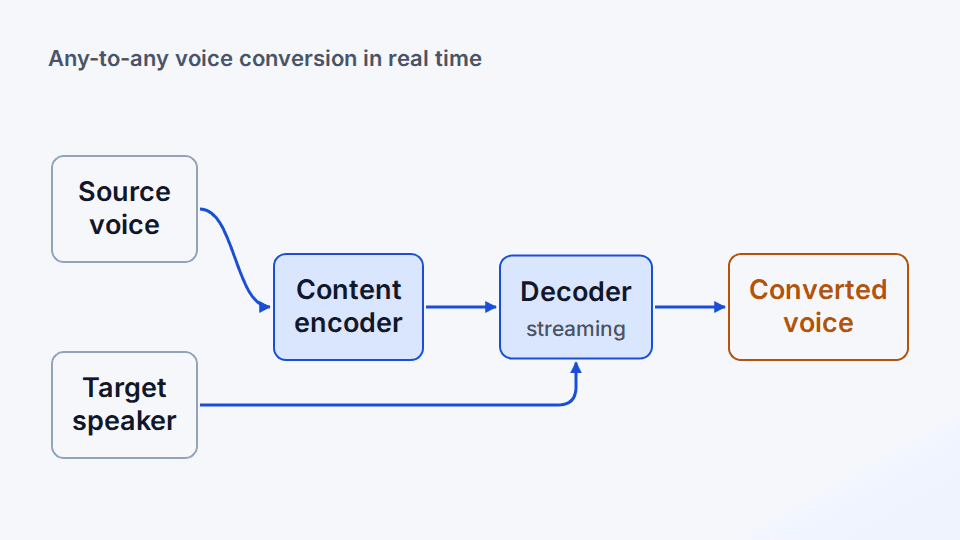
NatVC — Conversion vocale neuronale en temps réel
Code privé (travail en entreprise / pour un client)
Conversion vocale any-to-any qui tourne en temps réel sous le budget de latence d'une application live — mon mémoire de master à Centrale Lyon, réalisé pendant mon stage chez SteelSeries.
Construit avec:
PyTorchAccelerate (multi-GPU)StreamVCLLVC TensorBoard

