NatVC
Conversion vocale neuronale en temps réel
Transformer la voix d'une personne en celle d'une autre, en direct, sans délai perceptible
- +0,3 MOS par rapport à StreamVC
- Entraînement multi-GPU
Construit avec PyTorch
 Accelerate (multi-GPU)StreamVCLLVC
 TensorBoard
 ONNX
Code privé (travail en entreprise / pour un client)
Présentation
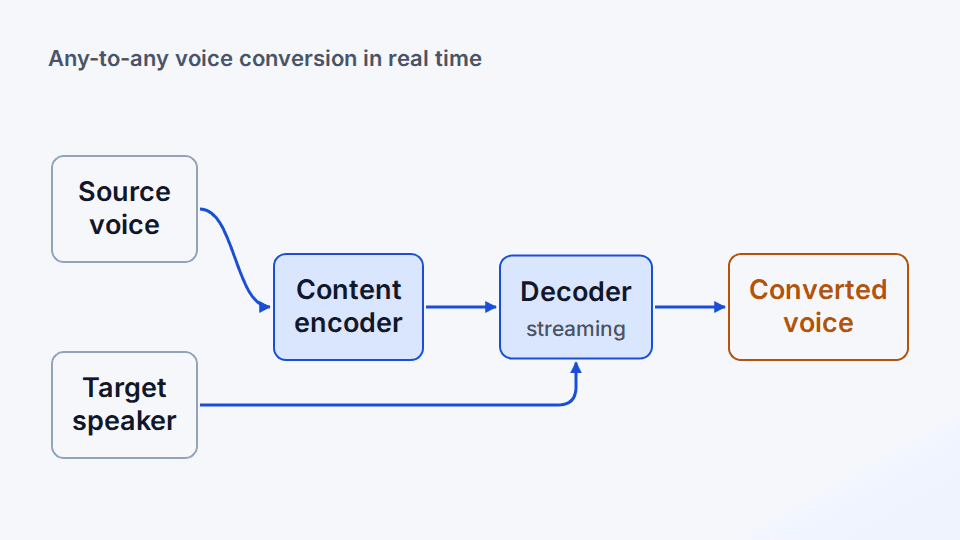
La conversion vocale fait sonner un locuteur comme un autre tout en conservant ce qu'il dit. Le faire en direct est difficile : chaque milliseconde de traitement ajoute un délai que l'auditeur peut entendre. Mon mémoire de master à Centrale Lyon, réalisé pendant mon stage chez SteelSeries, posait la question suivante : un modèle fondé sur StreamVC peut-il convertir n'importe quelle voix en n'importe quelle autre en temps réel, dans le budget de latence d'une application live, sans perdre en naturel ?
J'ai construit un système de conversion vocale en PyTorch et ONNX avec une latence de bout en bout inférieure à 80 ms, je l'ai entraîné sur plusieurs GPU avec Accelerate et une perte mel multi-échelle, et j'ai ajouté un mélange multi-voix en temps réel fondé sur l'architecture LLVC.
Grâce à un fine-tuning ciblé et à un post-traitement de la forme d'onde, le système a amélioré le MOS (mean opinion score, une note de naturel attribuée par des auditeurs) de 0.3 point par rapport à la baseline StreamVC. Il s'agit d'un travail industriel : la description reste à haut niveau et le code est propriétaire.
La question
Un modèle fondé sur StreamVC peut-il effectuer une conversion vocale any-to-any en temps réel, dans le budget de latence d'une application live, sans sacrifier le naturel de la voix ?
Fonctionnalités clés
- Convertit n'importe quelle voix d'entrée en une voix cible en temps réel.
- Fonctionne avec une latence de bout en bout inférieure à 80 ms.
- Mélange plusieurs voix cibles en temps réel, en s'appuyant sur l'architecture LLVC.
- Exporte le modèle en ONNX pour l'inférence en temps réel.
- S'entraîne sur plusieurs GPU avec Accelerate, avec un suivi dans TensorBoard.
Comment ça marche
Partir de StreamVC
Une architecture de conversion vocale en streaming a servi de baseline, choisie parce qu'elle traite l'audio au fil de son arrivée.
Entraîner à grande échelle
Entraînement distribué multi-GPU avec Accelerate, avec une perte mel multi-échelle pour comparer l'audio généré et l'audio cible à plusieurs résolutions.
Mélanger les voix
Mélange multi-voix en temps réel fondé sur l'architecture LLVC.
Affiner la qualité
Un fine-tuning ciblé et un post-traitement de la forme d'onde ont relevé le MOS de 0.3 point par rapport à la baseline StreamVC.
Déployer en temps réel
Un système PyTorch et ONNX qui maintient la latence de bout en bout sous 80 ms.
Stack technique
Développement et entraînement du modèle
Entraînement distribué sur plusieurs GPU
StreamVC
Architecture de référence pour la conversion vocale en streaming
LLVC
Base du mélange multi-voix en temps réel
Suivi des runs d'entraînement
Export pour l'inférence en temps réel
Ce que j’ai appris
- La latence est une contrainte de conception de premier ordre qui remodèle toute l'architecture
- C'est la conception de la fonction de perte qui détermine le naturel perçu, pas seulement la taille du modèle
Limites
- Travail industriel — implémentation décrite à haut niveau, code propriétaire
Projets liés
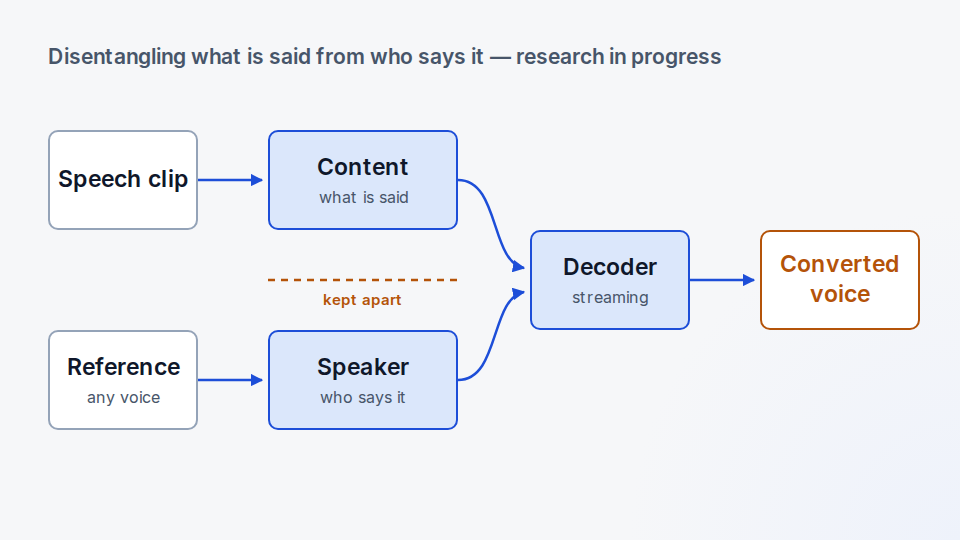
JointVC — Conversion de voix démêlée, entraînée en une seule passe
Privé pour l’instant : j’explore encore cette recherche, le code n’est donc pas encore publié.
Recherche en cours : un petit convertisseur de voix en temps réel dont l’encodeur de contenu, l’encodeur de locuteur et le décodeur apprennent ensemble, et la question ouverte au cœur du projet, le démêlage (disentanglement) : garder qui parle hors de ce qui est dit.
Construit avec:
PyTorchONNXHugging Face Transformerstorchaudio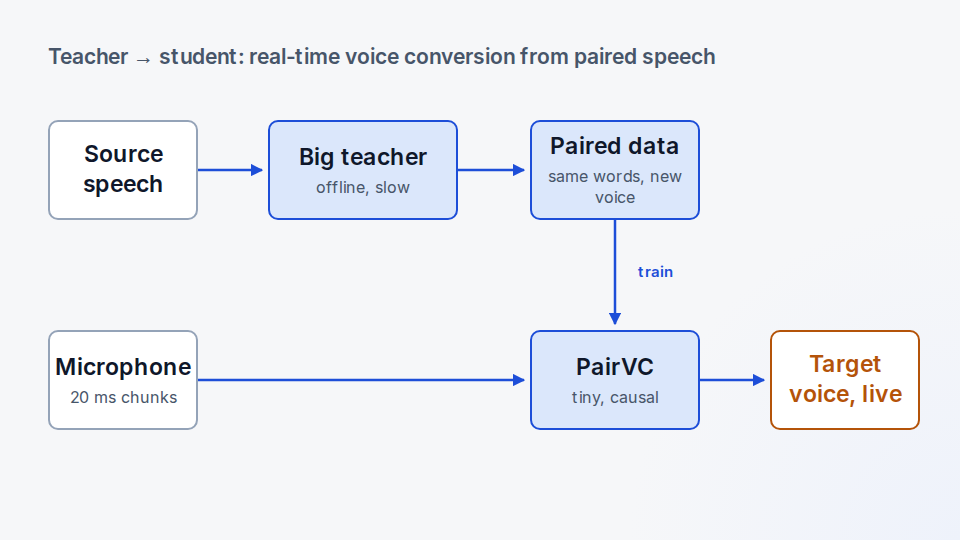
PairVC — Conversion de voix en temps réel apprise sur des paires
GitHub: PairVCDémo en ligne: PairVC
Un petit convertisseur de voix causal qui transforme votre voix en une voix cible en direct, 20 ms à la fois sur un seul cœur de CPU. Il apprend d’un gros modèle enseignant hors ligne, sur des paires de paroles.
Construit avec:
PyTorchONNX Streamlit
 JavaScript
 Kaggle

