NatVC
تحويل الصوت العصبي في الزمن الحقيقي
تحويل صوت شخص إلى صوت شخص آخر، مباشرة، دون تأخير ملحوظ
- +0.3 MOS مقارنةً بـ StreamVC
- تدريب على عدة GPU
التقنيات PyTorch
 Accelerate (multi-GPU)StreamVCLLVC
 TensorBoard
 ONNX
الكود خاص (عمل لشركة أو لعميل)
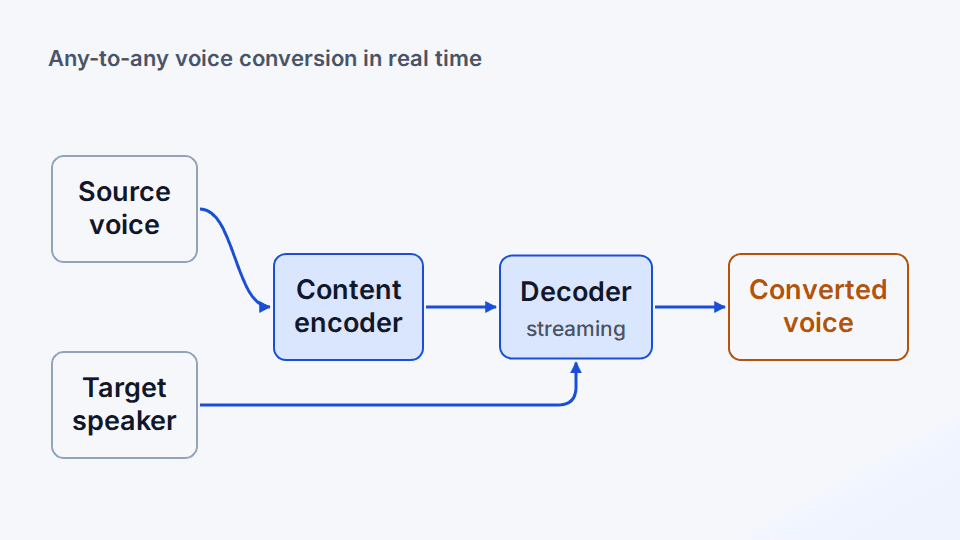
نظرة عامة
تحويل الصوت (Voice Conversion) يجعل متحدثًا يبدو كمتحدث آخر مع الحفاظ على ما يقوله. القيام بذلك مباشرة أمر صعب: كل ميلي ثانية من المعالجة تضيف تأخيرًا يمكن للمستمع سماعه. أطروحة الماجستير الخاصة بي في Centrale Lyon، التي أنجزتها خلال تدريبي في SteelSeries، طرحت سؤالًا: هل يستطيع نموذج مبني على StreamVC تحويل أي صوت إلى أي صوت آخر في الزمن الحقيقي، ضمن ميزانية الكمون (latency) لتطبيق مباشر، دون فقدان الطبيعية؟
بنيت نظام تحويل صوت بـ PyTorch وONNX بكمون من طرف إلى طرف أقل من 80 ms، ودرّبته على عدة وحدات GPU باستخدام Accelerate ودالة خسارة mel متعددة المقاييس، وأضفت مزجًا لأصوات متعددة في الزمن الحقيقي مبنيًا على بنية LLVC.
من خلال ضبط دقيق موجّه ومعالجة لاحقة للموجة الصوتية، حسّن النظام مقياس MOS (متوسط درجة الرأي، وهو تقييم المستمعين لطبيعية الصوت) بمقدار 0.3 نقطة مقارنة بخط الأساس StreamVC. هذا عمل صناعي، لذا يبقى الوصف على مستوى عام والكود ملكية خاصة.
السؤال
هل يستطيع نموذج مبني على StreamVC إجراء تحويل صوت من أي متحدث إلى أي آخر في الزمن الحقيقي، ضمن ميزانية الكمون لتطبيق مباشر، دون التضحية بطبيعية الصوت؟
أهم الميزات
- يحوّل أي صوت مُدخل إلى صوت مستهدف في الزمن الحقيقي.
- يعمل بكمون من طرف إلى طرف أقل من 80 ms.
- يمزج عدة أصوات مستهدفة في الزمن الحقيقي، بالبناء على بنية LLVC.
- يصدّر النموذج إلى ONNX للاستدلال في الزمن الحقيقي.
- يتدرّب على عدة وحدات GPU باستخدام Accelerate، مع متابعة في TensorBoard.
كيف يعمل
الانطلاق من StreamVC
بنية تحويل صوت متدفقة (streaming) شكّلت خط الأساس، واختيرت لأنها تعالج الصوت فور وصوله.
التدريب على نطاق واسع
تدريب موزّع على عدة وحدات GPU باستخدام Accelerate، مع دالة خسارة mel متعددة المقاييس لمقارنة الصوت المولَّد بالصوت المستهدف على عدة مستويات دقة.
مزج الأصوات
مزج أصوات متعددة في الزمن الحقيقي مبني على بنية LLVC.
تحسين الجودة
ضبط دقيق موجّه ومعالجة لاحقة للموجة الصوتية رفعا MOS بمقدار 0.3 نقطة مقارنة بخط الأساس StreamVC.
النشر للزمن الحقيقي
نظام بـ PyTorch وONNX يحافظ على كمون من طرف إلى طرف أقل من 80 ms.
التقنيات المستخدمة
تطوير النموذج وتدريبه
تدريب موزّع على عدة وحدات GPU
StreamVC
بنية خط الأساس لتحويل الصوت المتدفق
LLVC
أساس مزج الأصوات المتعددة في الزمن الحقيقي
متابعة جولات التدريب
تصدير للاستدلال في الزمن الحقيقي
ما تعلمته
- الكمون قيد تصميمي من الدرجة الأولى يعيد تشكيل البنية بأكملها
- تصميم دالة الخسارة هو ما يحدد الطبيعية المُدرَكة، لا حجم النموذج وحده
الحدود
- عمل صناعي — الوصف يبقى على مستوى عام، والكود ملكية خاصة
مشاريع ذات صلة
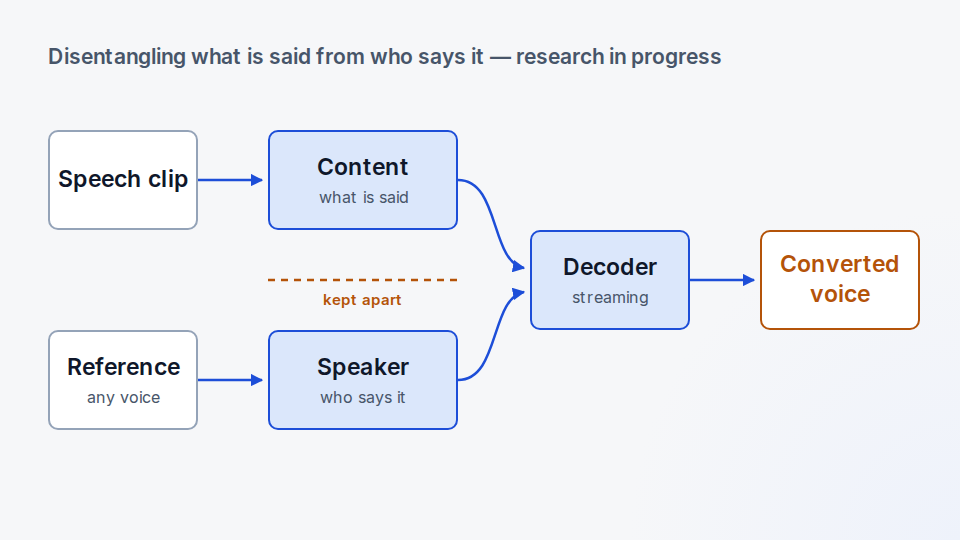
JointVC — تحويل صوت مفكَّك التشابك، مدرَّب في جولة واحدة
خاص في الوقت الحالي: ما زلت أستكشف هذا البحث، لذلك لم تُنشر الشيفرة بعد.
بحث قيد التطوير: محوّل صوت صغير يعمل في الزمن الحقيقي، يتعلّم فيه مُرمِّز المحتوى ومُرمِّز المتحدث والمُفكِّك معًا، والسؤال المفتوح في صميمه هو فكّ التشابك (disentanglement): إبقاء هوية المتحدث خارج ما يُقال.
التقنيات:
PyTorchONNXHugging Face Transformerstorchaudio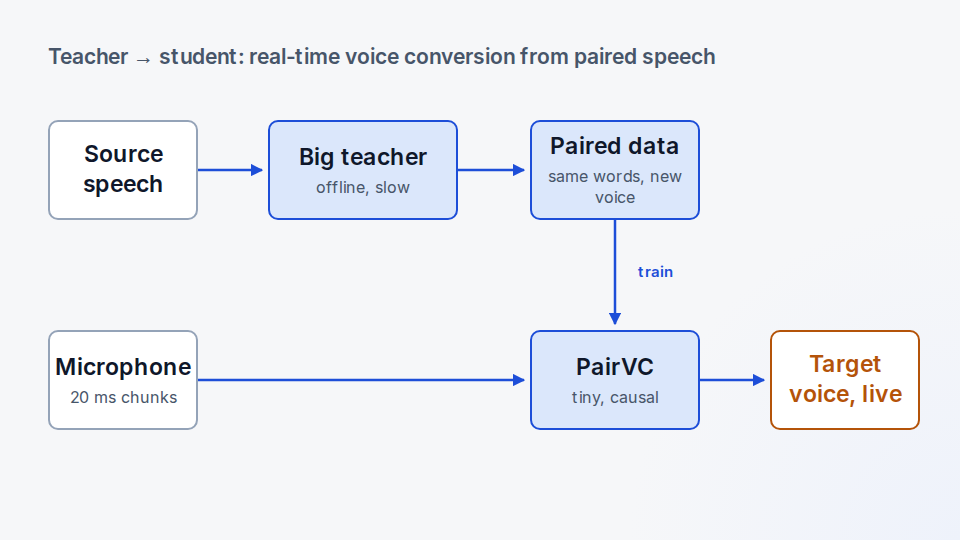
PairVC — تحويل الصوت في الزمن الحقيقي انطلاقًا من أزواج كلام
GitHub: PairVCعرض مباشر: PairVC
محوّل صوت صغير وسببي يحوّل صوتك إلى صوت مستهدف مباشرةً، 20 ملّي ثانية في كل مرة على نواة معالج واحدة. يتعلّم من نموذج مُعلِّم كبير يعمل دون اتصال، على أزواج من الكلام.
التقنيات:
PyTorchONNX Streamlit
 JavaScript
 Kaggle

