PairVC
تحويل الصوت في الزمن الحقيقي انطلاقًا من أزواج كلام
صوتك إلى صوت مستهدف، مباشرةً: شبكة صغيرة سببية مدرَّبة على أزواج مُعلِّم كبير.
- MCD من 6.53 إلى 2.70 dB
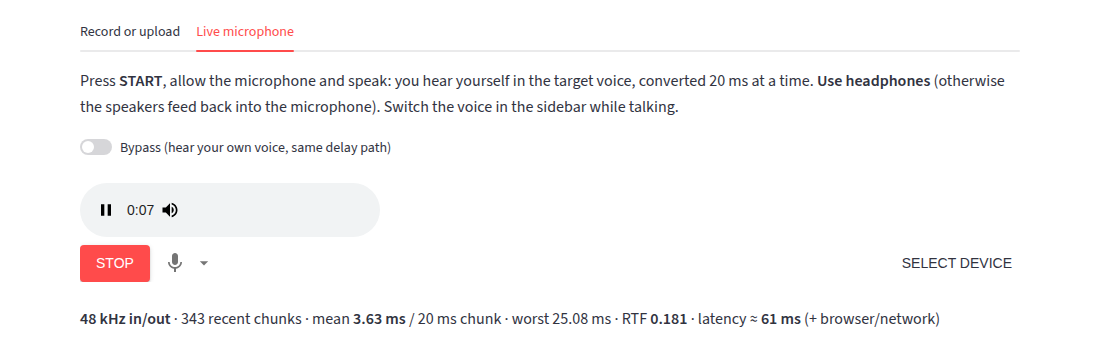
- مقاطع 20 ms على نواة واحدة
- يعمل في المتصفح
التقنيات PyTorch
 ONNX
 Streamlit
 JavaScript
 Kaggle
نظرة عامة
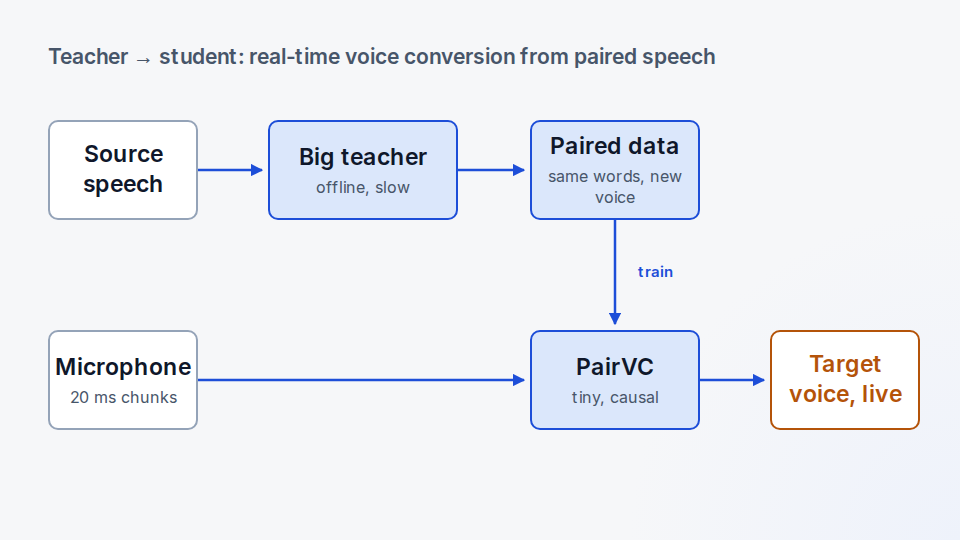
يحوّل PairVC صوتك إلى واحد من عدة أصوات مستهدفة أثناء حديثك. إنه شبكة سببية بالكامل، من موجة صوتية إلى موجة صوتية، تحوّل الصوت 20 ملّي ثانية في كل مرة على نواة معالج واحدة.
يُدرَّب على أزواج: كل مقطع مصدر يرافقه الكلام نفسه وقد حُوِّل مسبقًا إلى كل صوت مستهدف بواسطة مُعلِّم كبير وبطيء يعمل دون اتصال. يتعلّم PairVC إعادة إنتاج مخرجات المُعلِّم، فيحصل على أصواته بجزء بسيط من الكلفة.
وهو امتداد لعمل تحويل الصوت في الزمن الحقيقي الذي بدأته في رسالة الماستر (NatVC).
السؤال
هل يمكن لشبكة صغيرة تعمل بالتدفق أن تتعلّم أصوات محوّل كبير وبطيء بما يكفي لتعمل مباشرةً على معالج عادي؟
أهم الميزات
- سببي بالكامل: مقاطع 20 ms، وزمن تأخير 60 ms، ونواة معالج واحدة
- تقطير من مُعلِّم إلى تلميذ على كلام متوازٍ اصطناعي
- تدريب GAN: خسارة mel متعددة المقاييس ومميِّزات على نمط HiFi-GAN
- تصدير ONNX، وعرض مباشر في المتصفح، وتطبيق Streamlit مع ميكروفون مباشر
- المقاييس: MCD، وخطأ F0، والتصويت، وDNSMOS
كيف يعمل
أزواج يُنتجها مُعلِّم
يحوّل محوّل كبير يعمل دون اتصال كل مقطع مصدر إلى كل صوت مستهدف؛ وتشكّل هذه الأزواج مجموعة التدريب.
شبكة صغيرة سببية
يضغط مُرمِّز التفافي سببي الصوت 320 مرة إلى إطارات من 64 بُعدًا (إطار كل 20 ms)، ويعيد مُفكِّك مماثل بناء الموجة بالصوت المستهدف، مشروطًا عبر FiLM.
تحويل مباشر
بعد تصديره إلى ONNX، يعالج النموذج الميكروفون على مقاطع من 20 ms، في بايثون أو مباشرةً في المتصفح.
أمثلة
التقنيات المستخدمة
النموذج وخسائر GAN والتدريب الموزّع
التصدير والاستدلال في الزمن الحقيقي، في بايثون وفي المتصفح
تطبيق تجريبي مع ميكروفون مباشر
عرض في المتصفح عبر ONNX Runtime Web وAudioWorklet
دفتر تدريب على GPU
ما تعلمته
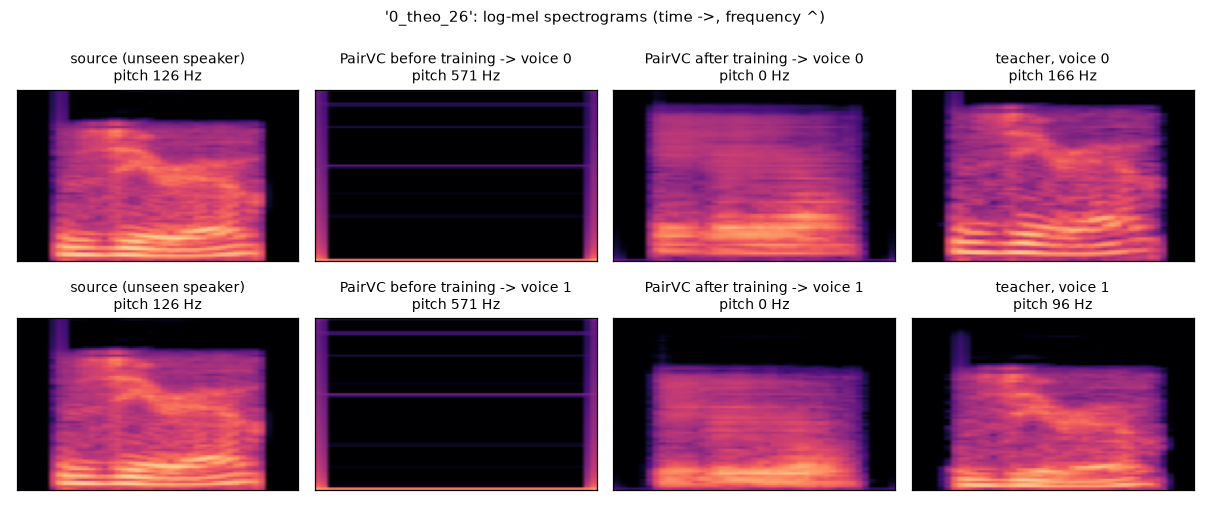
- سمح تسخين أولي بخسارة mel وحدها، قبل خسائر GAN، للنموذج الصغير بتجاوز المرحلة التي لم يكن يتعلّم فيها أي توافقيات.
- المقاييس الموضوعية (MCD وخطأ F0 والتصويت وDNSMOS) تكشف أكثر من الخسارة: تعلّم النموذج النبرة قبل طبقة الصوت.
الحدود
- لم يتعلّم النموذج الصغير المدرَّب على المعالج طبقة الصوت المستهدفة بعد: ما زال الصوت هامسًا، والخطوة التالية هي النموذج الكامل على GPU.
- لا يُنشر أي محوّل مدرَّب مسبقًا، فقط نموذج العرض الصغير.
مشاريع ذات صلة
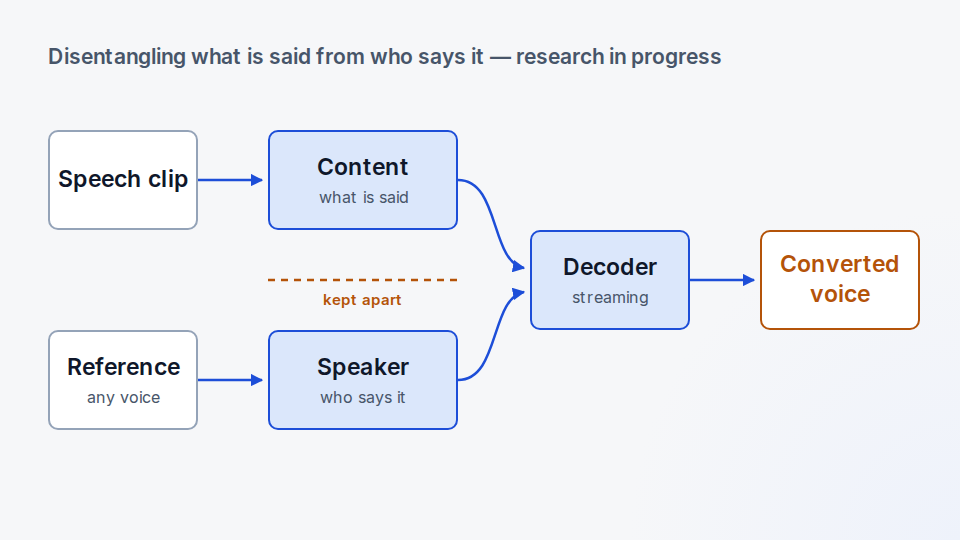
JointVC — تحويل صوت مفكَّك التشابك، مدرَّب في جولة واحدة
خاص في الوقت الحالي: ما زلت أستكشف هذا البحث، لذلك لم تُنشر الشيفرة بعد.
بحث قيد التطوير: محوّل صوت صغير يعمل في الزمن الحقيقي، يتعلّم فيه مُرمِّز المحتوى ومُرمِّز المتحدث والمُفكِّك معًا، والسؤال المفتوح في صميمه هو فكّ التشابك (disentanglement): إبقاء هوية المتحدث خارج ما يُقال.
التقنيات:
PyTorchONNX Hugging Face Transformerstorchaudio
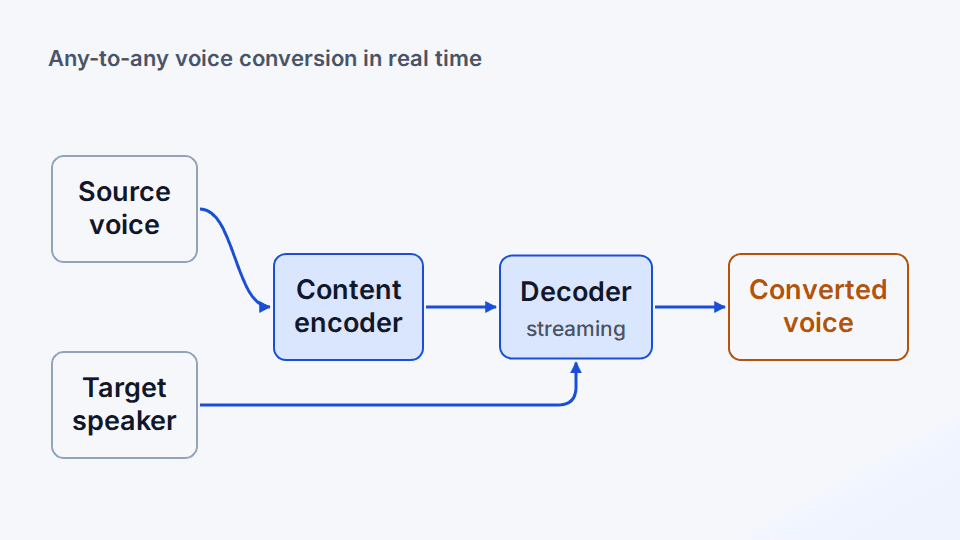
NatVC — تحويل الصوت العصبي في الزمن الحقيقي
الكود خاص (عمل لشركة أو لعميل)
تحويل صوت من أي متحدث إلى أي متحدث آخر يعمل في الزمن الحقيقي ضمن ميزانية الكمون (latency) لتطبيق مباشر — أطروحة الماجستير الخاصة بي في Centrale Lyon، أنجزتها خلال تدريبي في SteelSeries.
التقنيات:
PyTorchAccelerate (multi-GPU)StreamVCLLVC TensorBoard

