JointVC
تحويل صوت مفكَّك التشابك، مدرَّب في جولة واحدة
تعليم شبكة ما يُقال وأخرى من يقوله، في الوقت نفسه، دون أن يختلطا.
- بحث قيد التطوير
- مدرَّب في جولة واحدة
- دون صوت مستهدف
التقنيات PyTorch
 ONNX
 Hugging Face Transformerstorchaudio
خاص في الوقت الحالي: ما زلت أستكشف هذا البحث، لذلك لم تُنشر الشيفرة بعد.
نظرة عامة
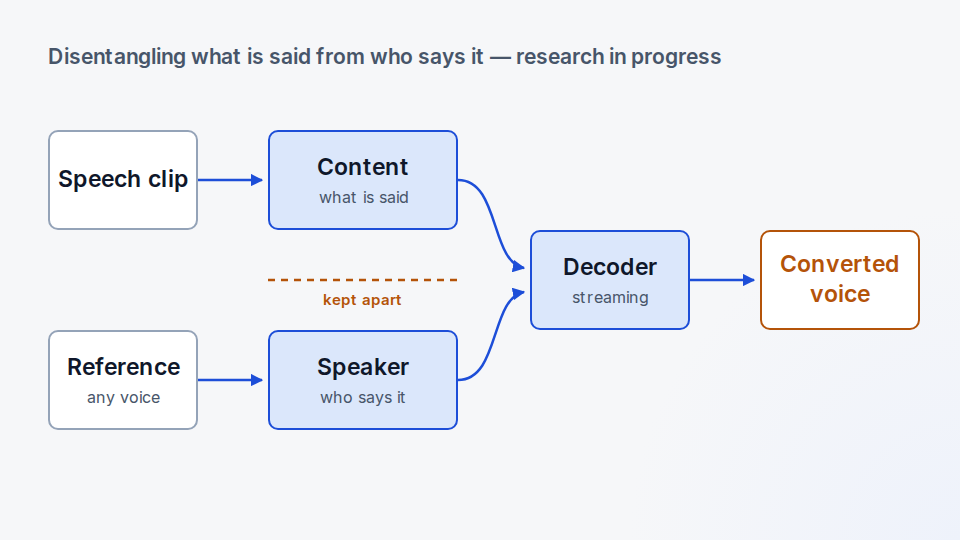
JointVC هو البحث الذي أعمل عليه حاليًا، وما زلت أكتشفه. إنه محوّل صوت صغير يعمل بالتدفق، من أي صوت إلى أي صوت، من عائلة StreamVC: مُرمِّز المحتوى يسمع ما يُقال، ومُرمِّز المتحدث يسمع من يقوله، ومُفكِّك يعيد بناء الكلام بأي صوت، 20 ملّي ثانية في كل مرة.
المفهوم في صميم المشروع هو فكّ التشابك (disentanglement): يجب أن يحمل المحتوى الكلمات دون أي أثر للمتحدث، وأن تحمل بصمة المتحدث الصوت دون الكلمات. يصل StreamVC إلى ذلك بالتدريب على مراحل. فكرتي هي تدريب الشبكات الثلاث معًا، في جولة واحدة، دون صوت مستهدف، وإبقاؤها منفصلة بدفاعات صريحة ضد التسرّب، ثم قياس التسرّب بدل الادّعاء بأنه اختفى.
هذا المشروع خاص في الوقت الحالي: ما زلت أستكشفه وأرى فيه إمكانات واعدة، لذلك تبقى الشيفرة مغلقة إلى أن تُحلّ الأسئلة المفتوحة.
السؤال
هل يستطيع محوّل صوت أن يتعلّم ما يُقال ومن يقوله في تدريب مشترك واحد، دون صوت مستهدف، مع إبقاء الاثنين منفصلين؟
أهم الميزات
- المحتوى والمتحدث والمُفكِّك مدرَّبة معًا منذ الخطوة الأولى، دون صوت مستهدف
- دفاعات ضد التسرّب: عكس التدرّج، وممحاة LEACE، وإسقاط تدرّج التسرّب، وعنق زجاجة من الوحدات
- فرع توافقي (DDSP) في المُفكِّك، مع طبقة الصوت والشدّة مأخوذتين من المرجع
- مسابير مستقلة تحاول استعادة المتحدث من المحتوى، عند كل تحقق
- تقييم MOS وWER وPESQ وSTOI
التقنيات المستخدمة
الشبكات الثلاث، ودفاعات التسرّب، وحلقة التدريب
تصدير للتدفق
نماذج كلام مدرَّبة مسبقًا تُستخدم كحَكَم وكأهداف اختيارية للمحتوى
تحميل الصوت واستخراج الخصائص
ما تعلمته
- يجب قياس فكّ التشابك بهجمات مستقلة، لا افتراضه: فإحصاءات تشير إلى «الاستقلال» قد يكسرها مسبار بسيط.
الحدود
- بحث قيد التطوير: الدفاعات التي تنجح على البيانات التجريبية لا تنتقل بعد إلى الكلام الحقيقي، ونبرة الصوت المحوَّل لم تصبح دقيقة بعد.
مشاريع ذات صلة
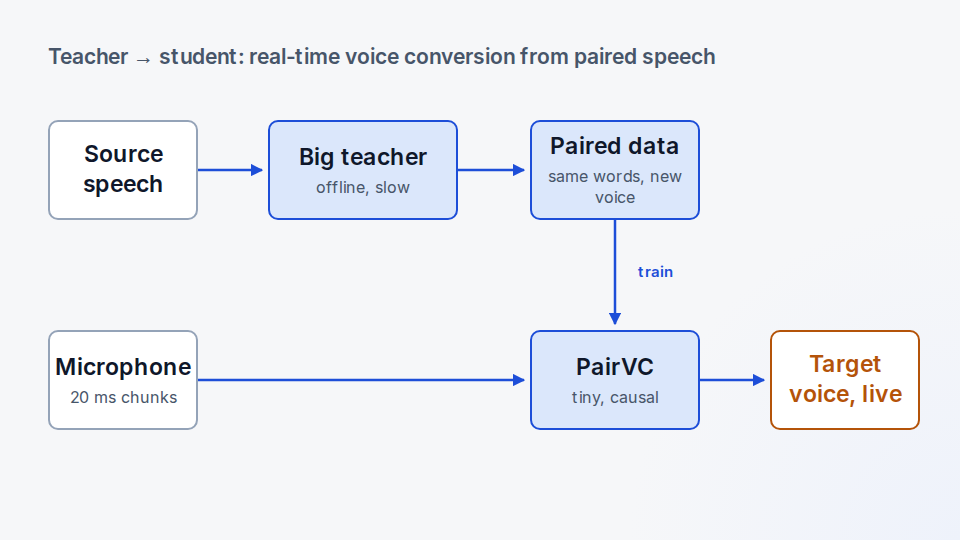
PairVC — تحويل الصوت في الزمن الحقيقي انطلاقًا من أزواج كلام
GitHub: PairVCعرض مباشر: PairVC
محوّل صوت صغير وسببي يحوّل صوتك إلى صوت مستهدف مباشرةً، 20 ملّي ثانية في كل مرة على نواة معالج واحدة. يتعلّم من نموذج مُعلِّم كبير يعمل دون اتصال، على أزواج من الكلام.
التقنيات:
PyTorchONNX Streamlit
 JavaScript
 Kaggle
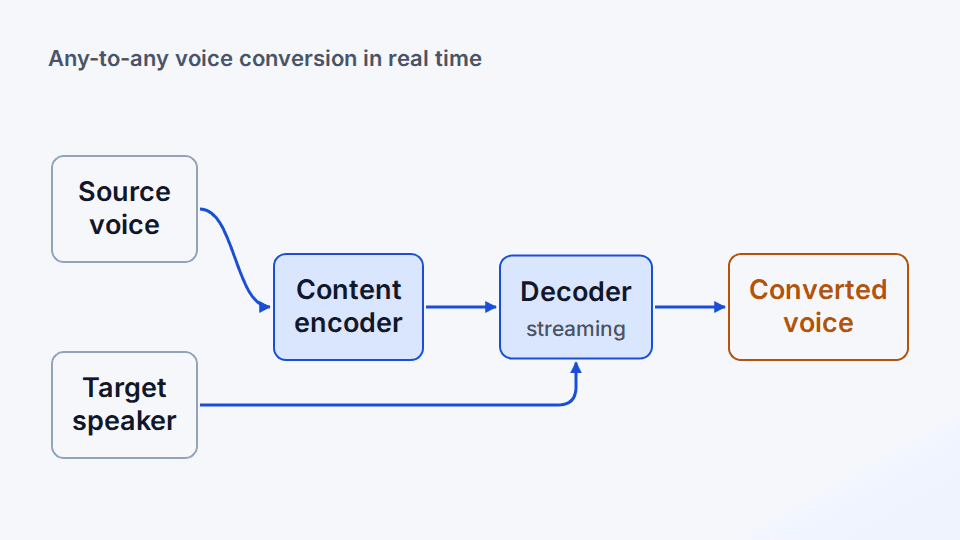
NatVC — تحويل الصوت العصبي في الزمن الحقيقي
الكود خاص (عمل لشركة أو لعميل)
تحويل صوت من أي متحدث إلى أي متحدث آخر يعمل في الزمن الحقيقي ضمن ميزانية الكمون (latency) لتطبيق مباشر — أطروحة الماجستير الخاصة بي في Centrale Lyon، أنجزتها خلال تدريبي في SteelSeries.
التقنيات:
PyTorchAccelerate (multi-GPU)StreamVCLLVC TensorBoard

