STT Workbench
Approches de reconnaissance vocale en PyTorch
Six façons de transformer la parole en texte, construites assez petites pour regarder chacune apprendre sur un CPU.
- CTC 2,4 % de WER (jouet)
- 15,1 % de WER sur FSDD avec LM
Construit avec PyTorchtorchaudioBeam search
 ONNX
 Hugging Face Transformers
 NumPy
 pytest
 Kaggle
Présentation
La reconnaissance automatique de la parole compte plusieurs familles de modèles qui résolvent différemment le même problème difficile : aligner une longue séquence de trames audio avec une courte séquence de caractères. Je voulais voir ces différences par moi-même plutôt que de les lire, j’ai donc écrit chaque approche dans une petite base de code PyTorch où elles partagent le front-end, les encodeurs, l’entraîneur et l’évaluation.
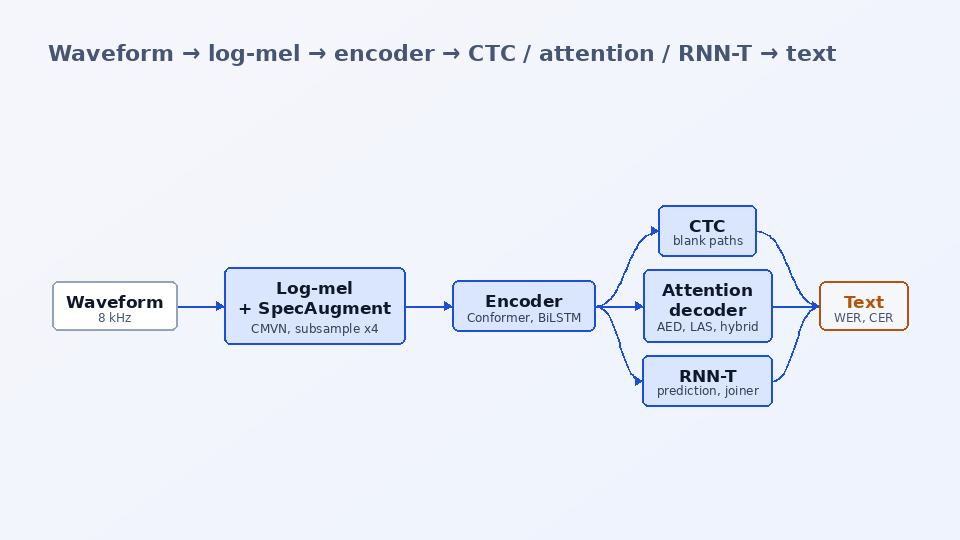
Les modèles sont CTC, un encodeur-décodeur à attention, Listen-Attend-Spell, l’hybride CTC/attention et un RNN-Transducer, sur des encodeurs BiLSTM, Transformer ou Conformer, avec en plus des wrappers pour le fine-tuning de wav2vec2 et Whisper dans le notebook. Tous les algorithmes de décodage sont présents : glouton, prefix beam search CTC avec un modèle de langage n-gramme, beam search à attention avec score de préfixe CTC, et décodage glouton et modified beam search pour RNN-T. Les modèles comptent de 1 à 1.3 M paramètres par défaut.
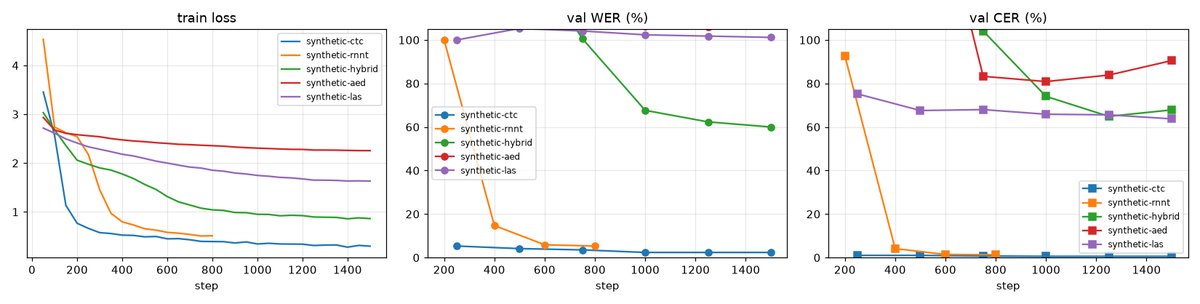
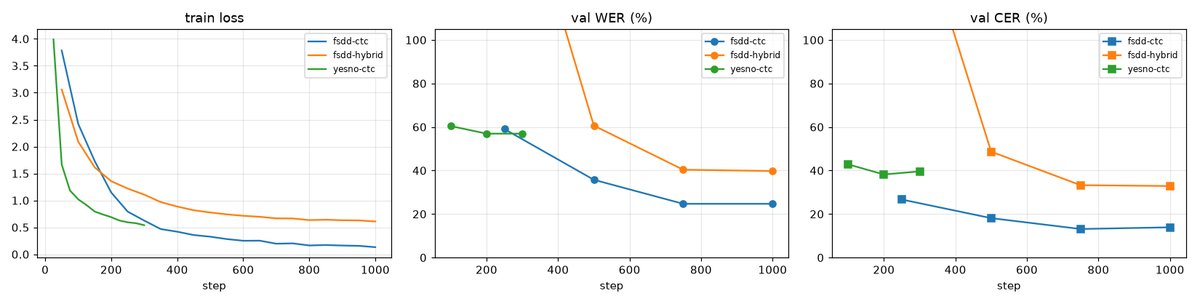
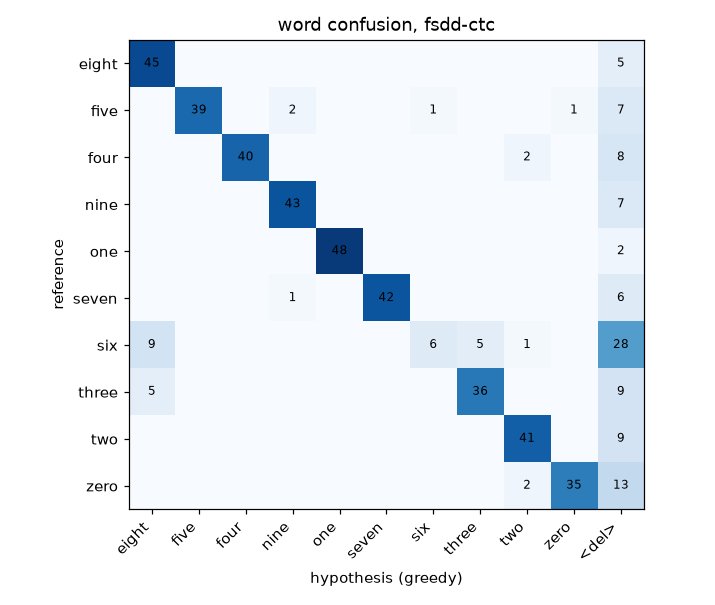
Je l’ai testé sur des données simples à 8 kHz qui s’entraînent en quelques minutes sur CPU : un langage jouet synthétique, le Free Spoken Digit Dataset et YESNO. CTC atteint 2.4 % de WER sur le langage jouet ; sur FSDD avec un locuteur mis de côté, le modèle CTC obtient 24.7 % de WER en glouton et 15.1 % avec beam search plus un modèle de langage 5-gramme sur les caractères. Ces runs montrent que chaque approche apprend et que les décodeurs fonctionnent ; ce ne sont pas des benchmarks, et le vrai entraînement se fait dans le notebook Kaggle/Colab.
La question
Si les modèles CTC, à attention et transducer partagent le même front-end, les mêmes encodeurs et le même entraîneur, de quoi chacun a-t-il réellement besoin pour apprendre l’alignement entre les trames audio et le texte ?
Fonctionnalités clés
- Cinq modèles entraînables derrière une seule option : CTC, encodeur-décodeur à attention, LAS avec attention sensible à la position, hybride CTC/attention et RNN-Transducer.
- Trois encodeurs utilisables par n’importe quel modèle, BiLSTM, Transformer et Conformer, après un front-end log-mel avec CMVN, SpecAugment et un sous-échantillonnage convolutif 4x.
- Tous les décodeurs : glouton, prefix beam search CTC avec un modèle de langage n-gramme interpolé, beam search à attention avec rescoring par préfixe CTC, et décodage glouton et modified beam search pour RNN-T.
- Des jeux de données intégrés, générés ou téléchargés en une commande (langage jouet synthétique, YESNO, FSDD, LibriSpeech, LJSpeech, Common Voice), avec des batchs regroupés par durée.
- Évaluation WER / CER avec alignement des pires énoncés, une matrice de confusion des mots et un script qui compare les décodeurs sur un même checkpoint.
- Export ONNX de l’encodeur et de la tête CTC, wrappers de fine-tuning pour wav2vec2 et Whisper, et un notebook Kaggle/Colab généré à partir du code source du package.
- 80 tests en environ 10 secondes sur CPU, dont un cas où le décodage CTC glouton se trompe et où le prefix beam search a raison.
Comment ça marche
Front-end
La forme d’onde devient un spectrogramme log-mel à 80 bandes, normalisé par énoncé (CMVN) et masqué en temps et en fréquence par SpecAugment pendant l’entraînement.
Encoder
Deux convolutions à pas sous-échantillonnent les trames d’un facteur quatre, puis une pile BiLSTM, Transformer ou Conformer construit des caractéristiques acoustiques contextuelles.
Aligner les trames et les tokens
CTC somme sur tous les chemins de trames qui se réduisent à la transcription ; les décodeurs à attention apprennent un alignement souple par cross-attention ; le RNN-T combine l’encodeur et un réseau de prédiction sur un treillis monotone.
Entraîner
Tokens caractères ou SentencePiece, Adam avec warm-up, batchs regroupés par durée, WER / CER de validation à chaque évaluation, et checkpoints qui permettent la reprise.
Décoder et évaluer
Glouton ou beam search, éventuellement fusionné avec un modèle de langage n-gramme ; stt-eval aligne les hypothèses avec les références et affiche le WER, le CER et les pires énoncés.
Exemples
Entrée
stt-train --data-dir data/synthetic --sample-rate 8000 --model ctc --encoder conformer --d-model 96 --n-layers 4 --max-steps 1500 --output-dir checkpoints/ctc && stt-eval data/synthetic/val.jsonl hyps.jsonl
Sortie
val WER 2.4%, CER 0.6% (1.04 M parameters, 20 min on one CPU with two threads)
Entrée
python scripts/compare_decoders.py # same CTC checkpoint, 166 FSDD validation clips
Sortie
greedy: 24.7% WER | beam 8: 24.1% | beam 8 + character 5-gram LM (weight 0.3): 15.1%
Stack technique
Tous les modèles, encodeurs, fonctions de perte et algorithmes de recherche
Perte RNN-T (dépendance optionnelle)
Beam search
Prefix beam search CTC, beam search à attention avec rescoring CTC, modified beam search RNN-T
Export de l’encodeur et de la tête CTC
Wrappers de fine-tuning pour wav2vec2 et Whisper (dépendance optionnelle)
Génération du langage jouet synthétique
80 tests, environ 10 secondes sur CPU
Notebook généré pour le vrai entraînement sur un GPU gratuit
Ce que j’ai appris
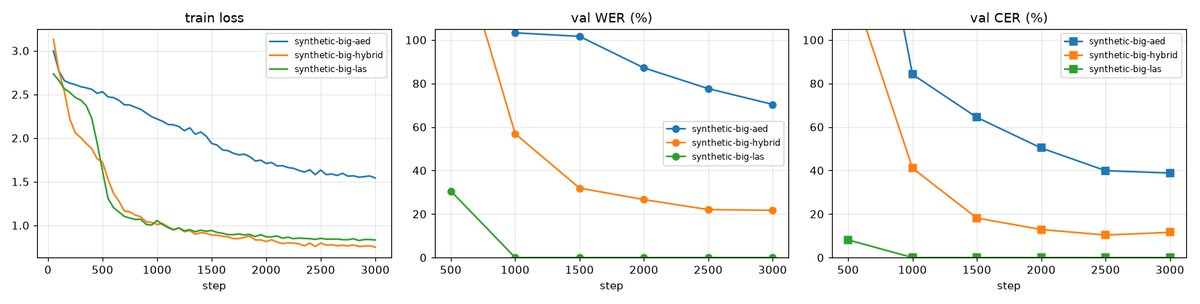
- CTC et RNN-T obtiennent gratuitement un alignement monotone, tandis que les décodeurs à attention doivent découvrir où regarder, ce qui coûte des données et des pas
- Un modèle de langage n’aide que si la langue a une structure : il a fait passer le WER sur FSDD de 24.7 % à 15.1 % et n’a rien changé sur des mots de lettres aléatoires
Limites
- Tous les résultats sont des runs CPU courts sur des données à 8 kHz (jouet, FSDD et YESNO), pas des benchmarks ; aucun chiffre LibriSpeech ni aucun poids pré-entraîné n’est publié
- Le run YESNO (42 extraits d’entraînement) reste à 56.9 % de WER ; il vérifie seulement que le pipeline tourne sur du vrai audio
Mots-clés
reconnaissance vocale · ASR · speech-to-text · CTC · RNN-Transducer · RNN-T · Listen Attend and Spell · encodeur-décodeur à attention · hybride CTC/attention · Conformer · BiLSTM · Transformer · prefix beam search · modèle de langage n-gramme · SpecAugment · spectrogramme log-mel · WER · CER · wav2vec2 · Whisper · PyTorch · ONNX · FSDD · LibriSpeech