Speech Emotion Recognition
8 classifieurs audio testés sur des locuteurs inconnus
Détecter l’émotion dans une voix, et découvrir quelle façon de présenter l’audio à un modèle résiste à un locuteur qu’il n’a jamais entendu.
- 82,5 % de précision (WavLM)
- 3× le pipeline d’origine
Construit avec PyTorch
 Hugging Face Transformerslibrosa
 scikit-learn
 NumPyMatplotlib
Présentation
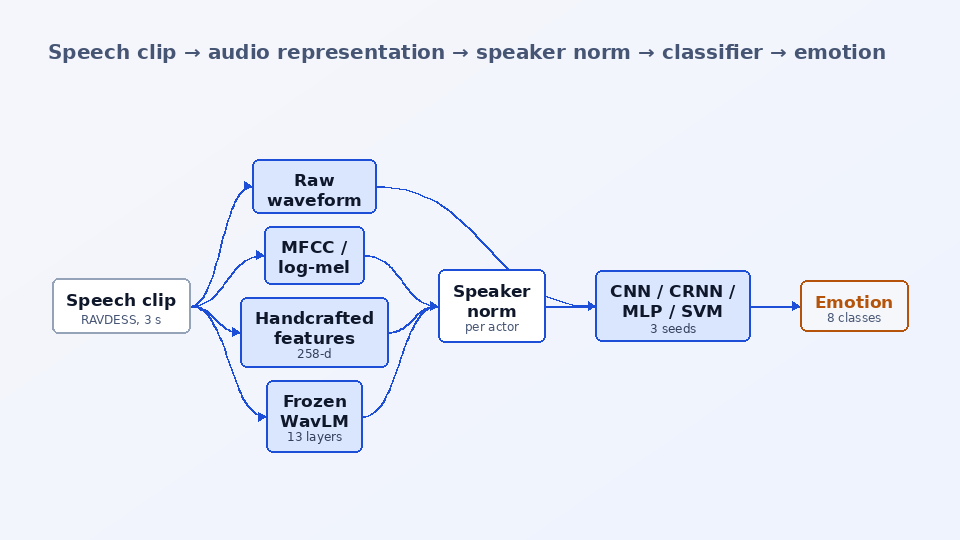
L’émotion dans la parole tient à la manière dont une phrase est dite, pas à ce qui est dit. RAVDESS le rend explicite : 24 acteurs prononcent la même phrase avec 8 émotions. Je voulais savoir quelle façon de présenter l’audio à un modèle fonctionne le mieux, j’ai donc entraîné un modèle par représentation sur les mêmes données et le même découpage : un CNN 1D sur la forme d’onde brute, un CNN 1D sur des séquences MFCC, un CNN 2D et un modèle CNN + BiGRU + attention sur des spectrogrammes log-mel, un MLP et un SVM sur 258 caractéristiques manuelles, un WavLM gelé avec une petite tête, et le réseau feed-forward du notebook Colab d’origine conservé comme baseline.
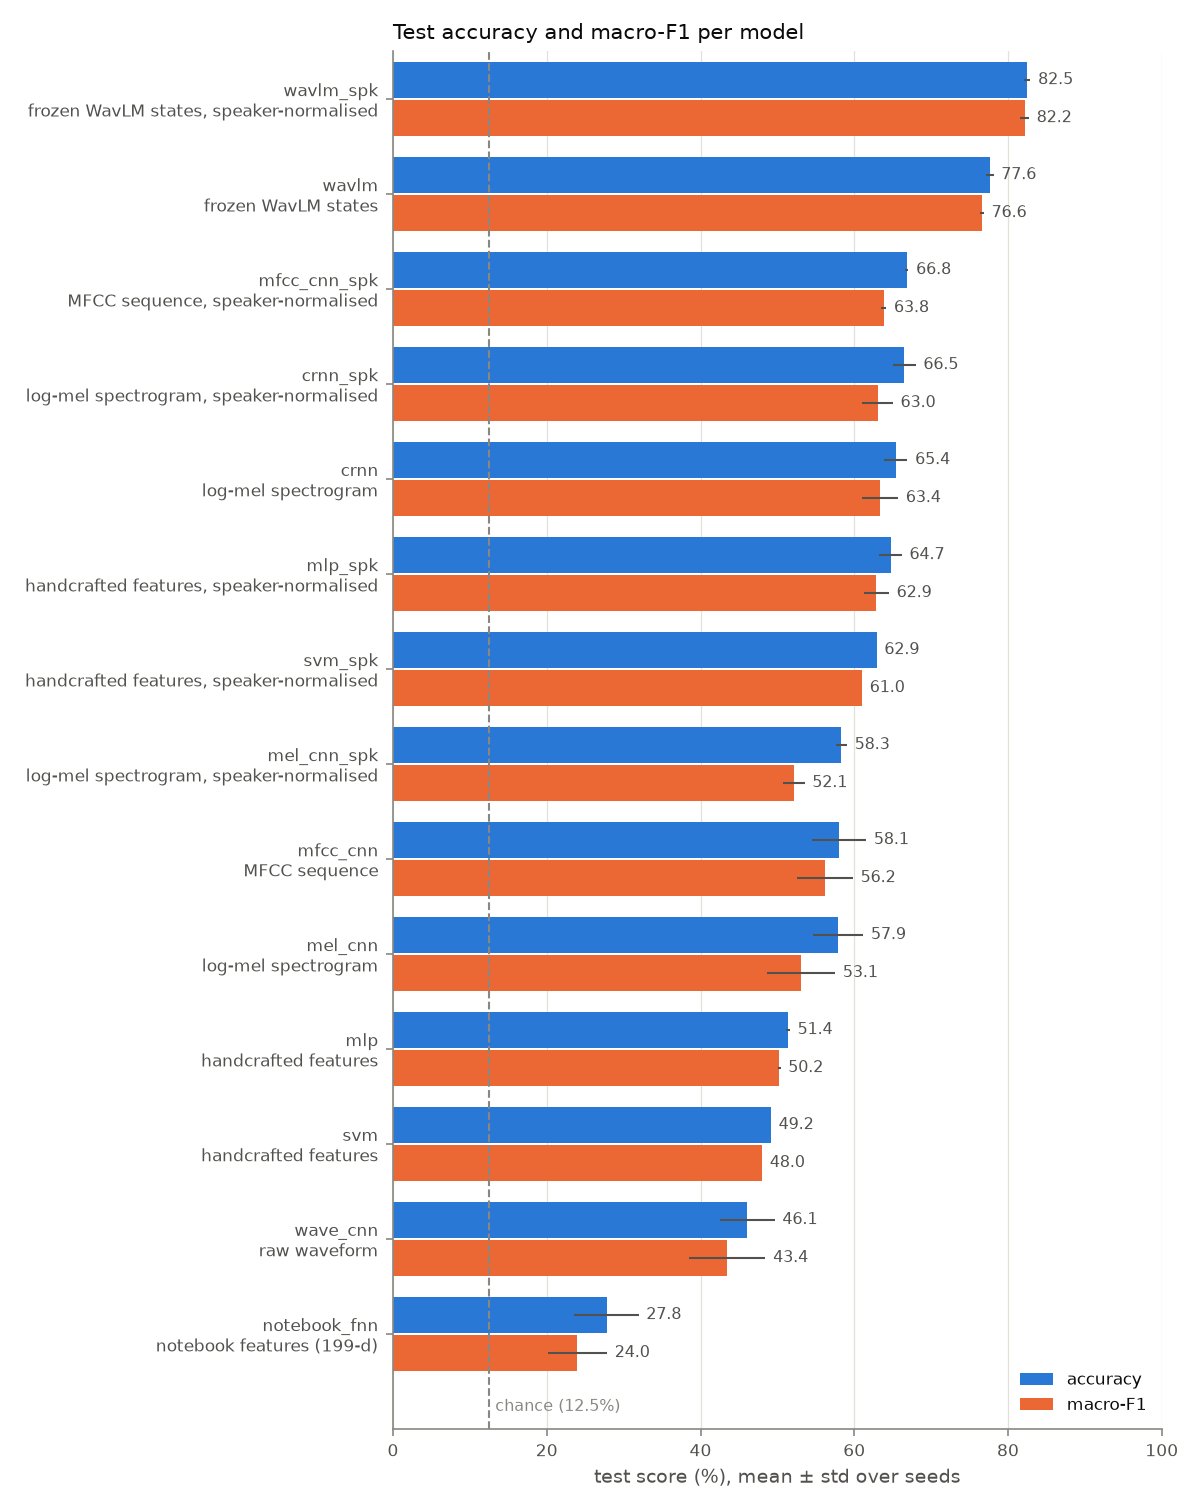
Le découpage se fait par acteur : 18 pour l’entraînement, 2 pour la validation, 4 pour le test, si bien qu’aucune voix de test n’est entendue pendant l’entraînement. C’est plus difficile que les découpages aléatoires derrière beaucoup de chiffres RAVDESS publiés. Chaque modèle est lancé avec 3 graines. Le WavLM gelé l’emporte largement avec 77.6 % de précision en test ; le CRNN atteint 65.4 %, les CNN sur spectrogramme et MFCC environ 58 %, le MLP 51.4 %, le SVM 49.2 %, le CNN sur forme d’onde brute 46.1 % et le pipeline du notebook 27.8 %.
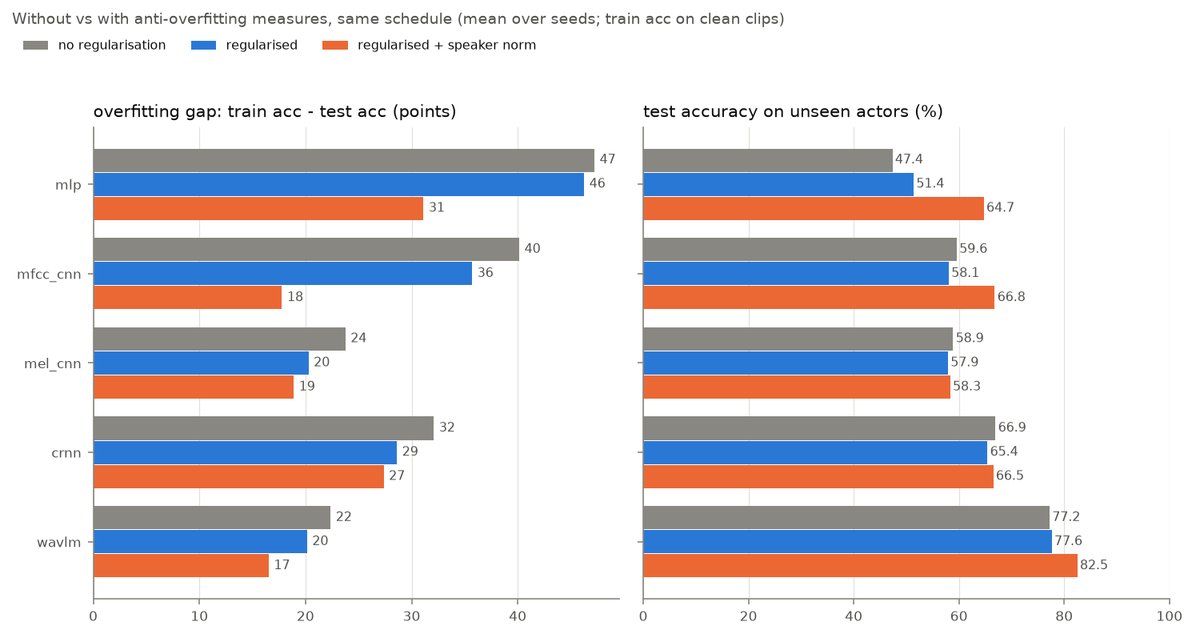
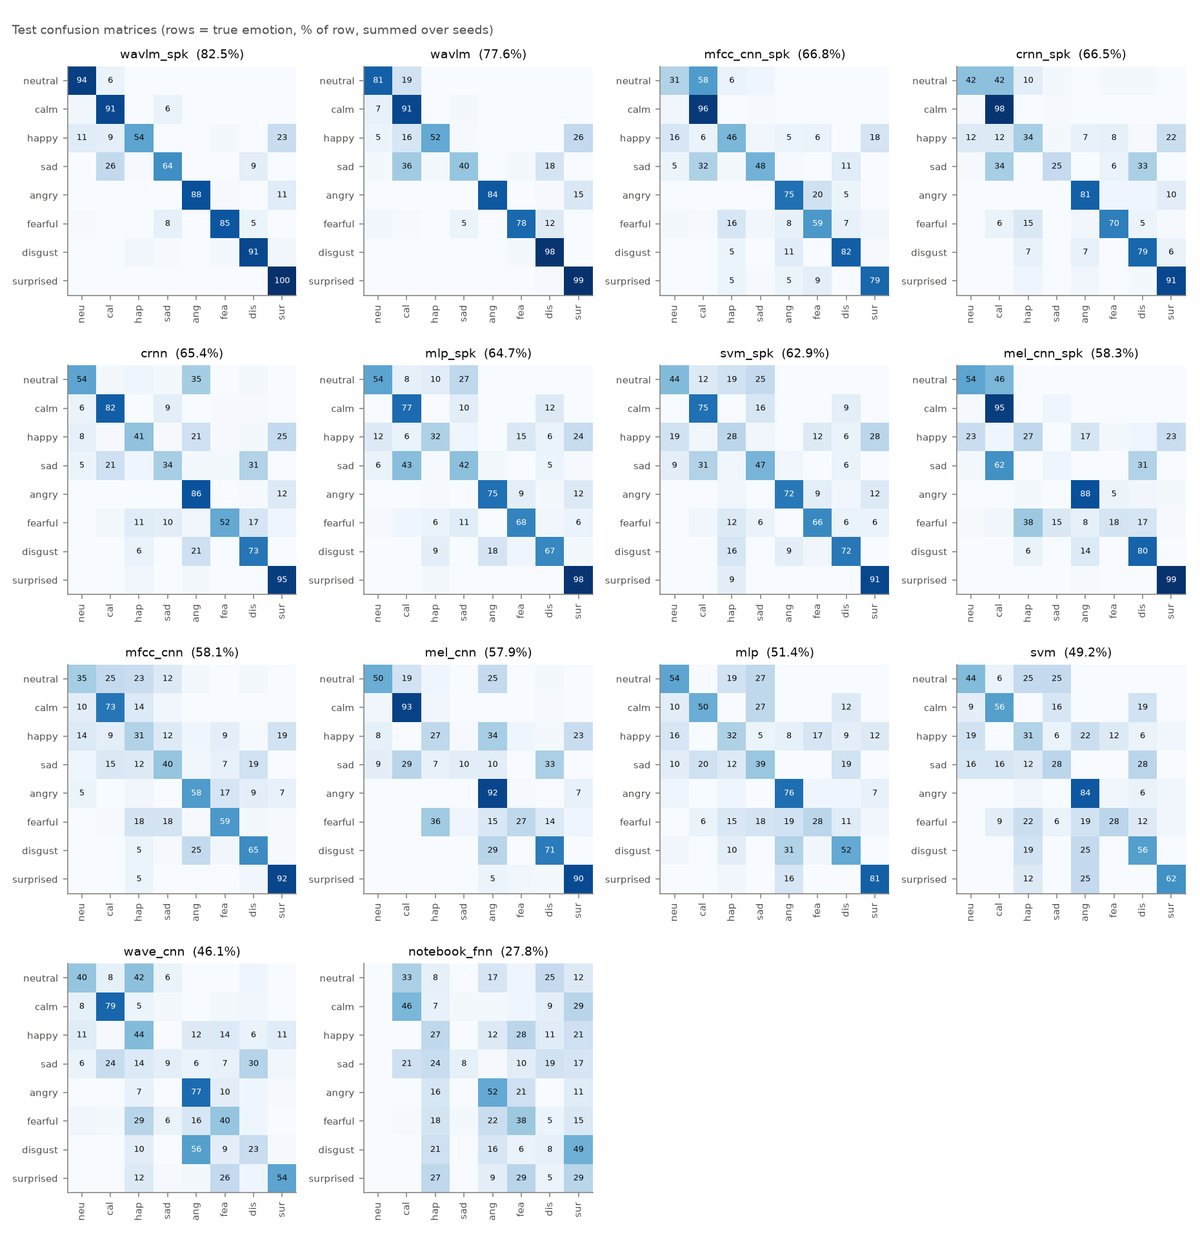
La première version mesurait la précision d’entraînement sur des extraits augmentés, ce qui masquait l’ampleur de la mémorisation. Mesuré honnêtement, chaque modèle atteint 78 à 100 % sur son jeu d’entraînement et perd 22 à 47 points sur de nouveaux locuteurs. Le weight decay, le mixup, la perturbation de vitesse et la moyenne des poids ne réduisent cet écart que de quelques points. Ce qui fonctionne, c’est de standardiser chaque caractéristique par locuteur : cela fait gagner 17 points au MLP, 7 au CNN MFCC et 5 à WavLM, qui atteint 82.5 %. Le dépôt fournit aussi huit extraits de test, un par émotion, chacun rendu sous forme de courte vidéo avec le spectrogramme, une tête de lecture et les probabilités du modèle ; WavLM en reconnaît 6 sur 8, entendant neutre comme calme et joyeux comme surpris.
La question
Quelle représentation audio fonctionne le mieux pour la reconnaissance des émotions quand les locuteurs de test sont nouveaux, et pourquoi les modèles entraînés from scratch surapprennent-ils autant les voix qu’ils ont entendues ?
Fonctionnalités clés
- Huit classifieurs sur un même pipeline de données : CNN sur forme d’onde brute, CNN MFCC, CNN log-mel, CRNN avec pooling par attention, MLP, SVM RBF, un WavLM base+ gelé avec une somme pondérée apprise de ses 13 couches, et le réseau du notebook d’origine comme baseline fidèle.
- Protocole indépendant du locuteur : découpage par acteur (1,080 / 120 / 240 extraits), audio 16 kHz avec silences supprimés, recadré ou complété à 3 s, précision et macro-F1 rapportés en moyenne ± écart-type sur 3 graines.
- Mesure honnête du surapprentissage : précision d’entraînement sur 240 extraits propres en mode évaluation à chaque époque, avec une option --baseline qui désactive toutes les mesures anti-surapprentissage pour le tableau avant/après.
- Régularisation par modèle : weight decay AdamW de 0.05, dropout en entrée, mixup, bruit gaussien sur les caractéristiques, perturbation de vitesse et de hauteur, SpecAugment et moyenne des poids EMA, chacun conservé seulement s’il aidait en validation.
- Normalisation par locuteur pour chaque famille de caractéristiques, y compris le front-end log-mel des CNN, avec predict.py --speaker-ref qui prend quelques extraits non étiquetés d’un nouveau locuteur.
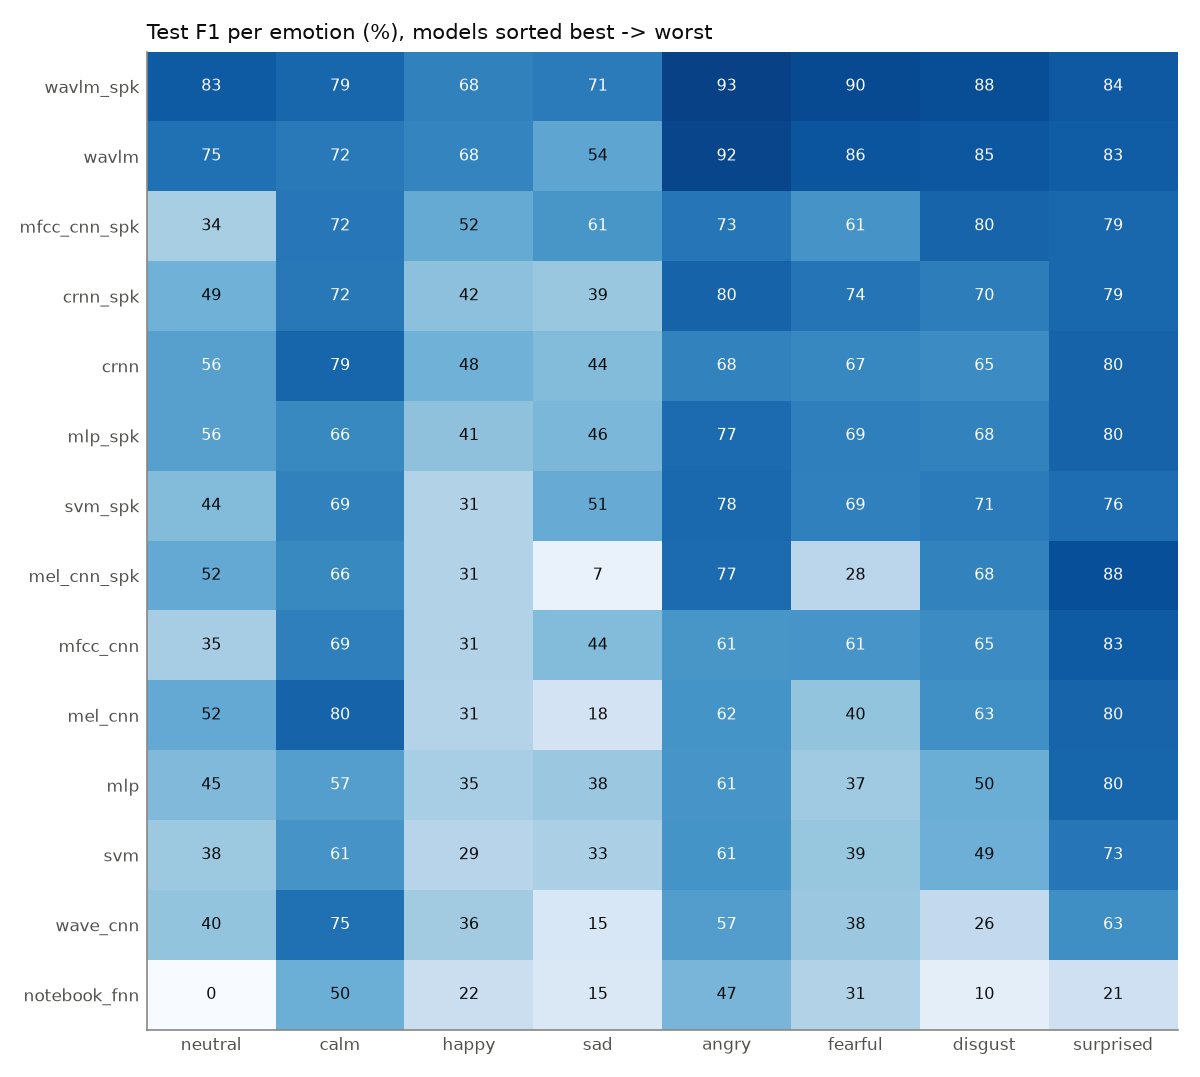
- Un compare.py reprenable qui lance chaque modèle et chaque graine, puis report.py reconstruit le tableau de résultats, les courbes d’entraînement, les matrices de confusion, le F1 par émotion et la figure de surapprentissage à partir des logs JSON.
- Six scripts d’exemple, du résultat réel le plus rapide (un SVM en 3 secondes) à la classification des extraits d’exemple et à leur rendu en vidéos avec le son.
Comment ça marche
Charger et découper par acteur
prepare_ravdess.py télécharge les 1,440 extraits de parole et place les acteurs 1-18 en entraînement, 19-20 en validation et 21-24 en test ; les labels et les identifiants de locuteur viennent des noms de fichiers.
Transformer l’audio en chaque représentation
Les extraits sont rééchantillonnés à 16 kHz, débarrassés des silences et fixés à 3 s, puis deviennent une forme d’onde de 48,000 échantillons, une séquence MFCC 40 × 151, un spectrogramme log-mel 64 × 151, 258 caractéristiques manuelles agrégées, ou les états cachés d’un WavLM gelé, mis en cache après le premier run.
Entraîner un modèle par représentation
Chaque modèle neuronal utilise AdamW avec un calendrier one-cycle, un label smoothing de 0.1 et des batchs de 32 ; ses propres augmentations et régularisations sont appliquées, et le checkpoint au meilleur macro-F1 de validation est conservé.
Normaliser par locuteur
Les variantes _spk standardisent chaque caractéristique avec la moyenne et la variance propres au locuteur plutôt qu’avec celles du jeu d’entraînement, ce qui supprime l’essentiel de ce qui distingue une voix d’une autre.
Rapporter sur des acteurs inconnus
Chaque run écrit un JSON avec son historique et ses métriques de test ; report.py agrège les graines dans le tableau de résultats, les matrices de confusion, le F1 par classe et la figure de l’écart entraînement-test.
Exemples
Entrée
python predict.py samples/05_angry_actor21.wav --model wavlm
Sortie
angry 76% (true: angry)
Stack technique
Les sept modèles neuronaux, les front-ends, les augmentations et la boucle d’entraînement
Backbone WavLM base+ gelé (tout checkpoint wav2vec2 / HuBERT / WavLM peut le remplacer)
Rééchantillonnage, suppression des silences, caractéristiques MFCC, chroma, mel, contraste et tonnetz
Baseline SVM RBF et métriques de classification
Agrégation des caractéristiques, standardisation par locuteur et mise en cache
Figures de résultats : barres de précision, courbes, matrices de confusion, F1 par classe
Ce que j’ai appris
- Les modèles surapprennent l’identité du locuteur, pas seulement les extraits : la régularisation classique ne change pas la précision de test plus que le bruit dû à la graine, alors que normaliser les caractéristiques par locuteur comble une grande partie de l’écart
- Beaucoup de scores RAVDESS publiés utilisent des découpages aléatoires où les mêmes acteurs apparaissent en entraînement et en test ; ils ne sont donc pas comparables à un test indépendant du locuteur
Limites
- Les variantes normalisées par locuteur ont besoin de quelques extraits non étiquetés de chaque locuteur de test ; elles suivent donc un protocole légèrement différent des lignes qui n’utilisent rien des locuteurs de test
- Avec 18 voix d’entraînement, un écart entraînement-test subsiste pour chaque modèle ; un corpus plus grand comme CREMA-D ou MSP-Podcast est la prochaine étape
Mots-clés
reconnaissance des émotions dans la parole · classification audio · RAVDESS · WavLM · wav2vec2 · parole auto-supervisée · spectrogramme mel · MFCC · CRNN · CNN sur forme d’onde brute · SVM · normalisation par locuteur · évaluation indépendante du locuteur · surapprentissage · PyTorch