Pong RL
Pong à partir des pixels avec sept méthodes de deep RL
Sept méthodes de deep RL apprennent Pong uniquement à partir des pixels, côte à côte, sur les mêmes images et avec le même score.
- DQN +4,60, 100 % de victoires
- 3,6 min sur un seul thread CPU
- 34 tests
Construit avec PyTorch
 NumPyGymnasiumMatplotlib
 pytest
Présentation
Pong à partir des pixels est le problème qui a rendu célèbre l’apprentissage par renforcement profond, et « Pong from Pixels » de Karpathy a été mon point de départ : un notebook de cours avec son gradient de politique en numpy et une réécriture en PyTorch. En faire un package a demandé de corriger onze problèmes dans ce notebook, le principal étant une fonction de perte qui donnait un gradient nul à chaque action DOWN.
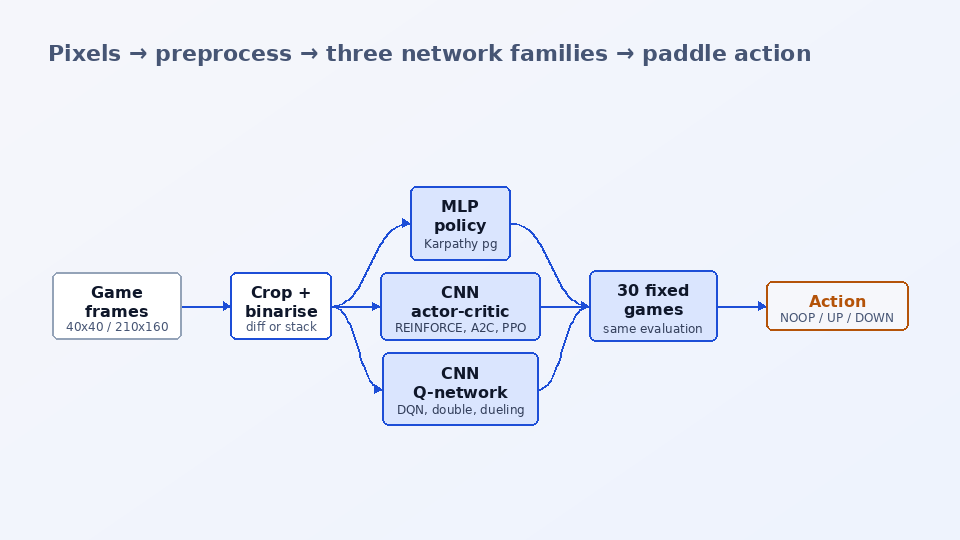
J’ai ensuite implémenté chaque méthode principale sur les mêmes images prétraitées : le gradient de politique de Karpathy (un MLP sur des différences d’images), REINFORCE avec une baseline apprise, A2C avec 16 parties en parallèle, PPO avec GAE et ratio clippé, et DQN avec têtes double et dueling, replay priorisé et retours n-step. Chaque règle d’apprentissage tient dans un fichier de 60 à 120 lignes ; le jeu, le CNN, l’évaluation et la journalisation sont partagés.
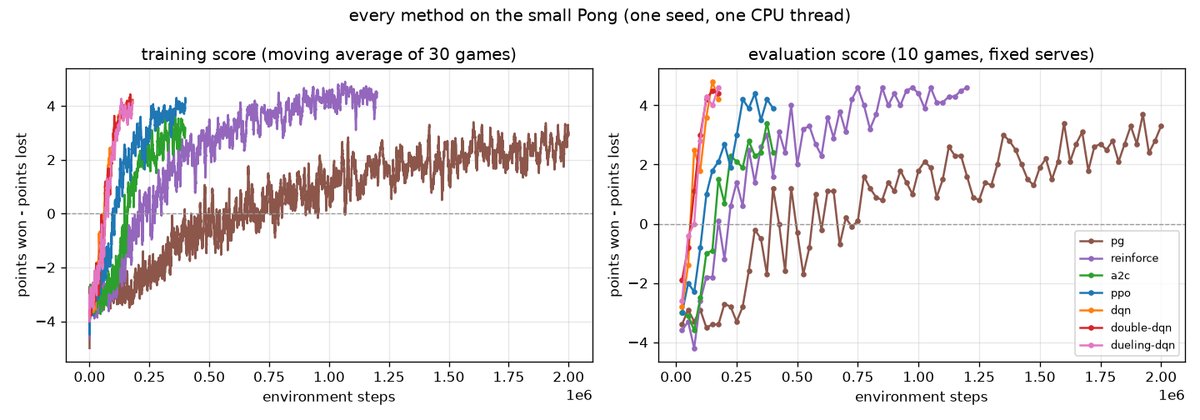
Comme un agent sur pixels a besoin de millions d’images Atari pour gagner, j’ai écrit un Pong numpy 40x40 avec les trois mêmes actions, le frame skip et un adversaire scripté, prétraité en images binaires 20x20. Chaque méthode l’apprend en 2 à 6 minutes sur un seul thread CPU, ce qui rend les différences visibles : la famille DQN bat l’adversaire après 75k-100k pas, PPO après 125k, et les méthodes Monte Carlo ont besoin de 175k à 400k. Le même code s’entraîne sur ALE/Pong-v5 dans le notebook Kaggle / Colab.
La question
Lorsque sept méthodes de deep RL voient les mêmes images prétraitées et sont notées par la même évaluation, dans quelle mesure une baseline apprise, le bootstrapping et l’experience replay changent-ils le nombre d’échantillons nécessaires pour gagner à Pong ?
Fonctionnalités clés
- Sept méthodes derrière une même interface : pg (Karpathy), reinforce, a2c, ppo, dqn, double-dqn et dueling-dqn, avec --per et --n-step comme options pour la famille DQN.
- Deux jeux, une interface : le petit Pong intégré (images binaires 20x20, premier à 5 points) et ALE/Pong-v5 (prétraitement 80x80 de Karpathy, frame skip 4, sticky actions, ROM incluses, sans affichage).
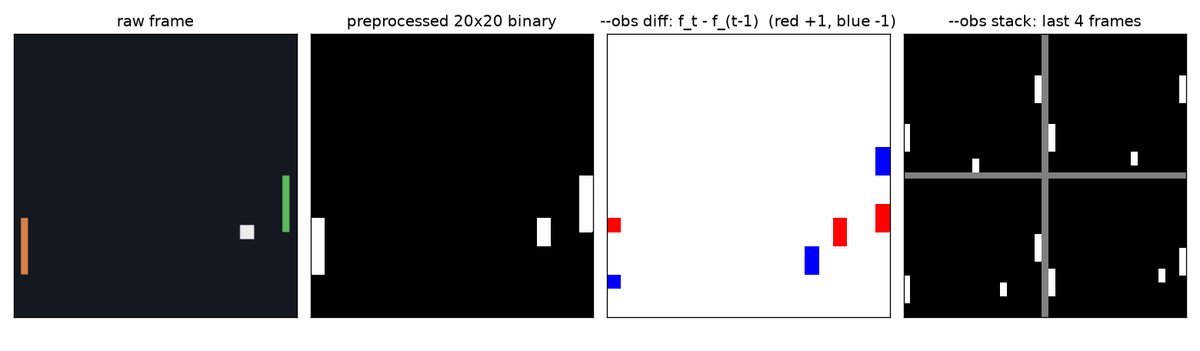
- Deux façons de percevoir le mouvement : --obs diff (différence d’images, un canal) ou --obs stack (4 images), acceptées par toutes les méthodes.
- Deux encodeurs CNN choisis automatiquement : un petit qui conserve une carte spatiale 4x4 sur les images 20x20 et le Nature CNN pour le 80x80, avec initialisation orthogonale.
- Un environnement vectorisé qui fait avancer n parties dans un seul processus, se réinitialise automatiquement et renvoie la dernière image pour que DQN puisse bootstrapper à travers une coupure par limite de temps.
- Une même évaluation pour tous : score moyen sur 30 parties avec services fixes, taux de victoire et une option --greedy ; courbes en fonction des pas et du temps réel.
- Quatre CLI (pong-train, -eval, -play, -compare), six exemples numérotés, 34 tests, et un dossier legacy qui documente ce que faisait le notebook d’origine et comment chaque bug a été corrigé.
Comment ça marche
Prétraiter l’image
Les images ALE sont recadrées, sous-échantillonnées d’un facteur 2 et binarisées exactement comme dans le prepro de Karpathy (80x80). Le petit jeu est sous-échantillonné de 40x40 à 20x20 avec un max sur des blocs 2x2, pour que la balle 2x2 ne puisse jamais disparaître.
Encoder le mouvement
Une seule image montre où se trouve la balle, pas où elle va. diff soustrait l’image précédente, si bien qu’un objet en mouvement devient une tache +1 à côté d’une tache -1 ; stack conserve les 4 dernières images et laisse le réseau les comparer.
Apprendre, de trois façons
pg et reinforce attendent la fin des parties et utilisent des retours Monte Carlo (réinitialisés à chaque point), avec ou sans V(s) appris. a2c et ppo bootstrappent après 5 ou 64 pas avec un critique, PPO réutilisant chaque batch pendant 4 époques avec un clip du ratio à 10 %. La famille DQN régresse Q vers un réseau cible à partir d’un replay buffer avec une perte de Huber et une action epsilon-greedy.
Évaluer sur des services fixes
La copie i du jeu est réinitialisée avec la graine 10000 + i : chaque méthode affronte les mêmes services et le même bruit de l’adversaire ; les agents à gradient de politique échantillonnent leurs actions, la famille DQN joue argmax Q.
Comparer
scripts/compare_all.py entraîne les sept méthodes l’une après l’autre et construit le tableau de résultats, les courbes en fonction des pas et des minutes, et le GIF avec un panneau par méthode.
Exemples
Entrée
pong-train --algo dqn && pong-eval runs/dqn/model.pt --episodes 30
Sortie
mean score +4.60 ± 0.55 over 30 games, win rate 100% (180,000 steps, 3.6 min on one CPU thread)
Stack technique
MLP de Karpathy, acteur-critique CNN et Q-networks, et les sept règles d’apprentissage
Le Pong 40x40 intégré, le prétraitement, l’actualisation des retours et le replay sur sum tree
ALE/Pong-v5 via ale-py, avec la même interface à trois actions que le petit jeu
Courbes d’apprentissage en fonction des pas et du temps réel, figures de prétraitement
34 tests : identités de gradient, clip de PPO, cible de double DQN, un bandit à pixels que chaque méthode doit apprendre, les CLI
Ce que j’ai appris
- L’initialisation décidait si quoi que ce soit était appris : avec l’initialisation par défaut de PyTorch sur des images binaires creuses, la tête de politique de PPO ne recevait presque aucun gradient pendant 150k pas ; l’initialisation orthogonale a réglé le problème
- Un horizon plus court (gamma de 0.99 à 0.97) a donné des retours de variance plus faible sur le petit jeu, où un point se décide 10 à 20 décisions après le coup qui comptait
- La fonction de perte du notebook de cours d’origine donnait un gradient nul à chaque action DOWN ; la log-vraisemblance de Bernoulli complète corrige cela et un test vérifie qu’elle est égale au gradient A (y - p) de Karpathy
Limites
- Tous les résultats viennent du petit Pong intégré, avec une graine par méthode ; aucun chiffre ALE Pong du dépôt ne provient d’un agent entraîné (les vrais runs ALE se trouvent dans le notebook, avec des budgets seulement estimés)
- Double et dueling DQN avec replay priorisé et retours à 3 pas restent dans le bruit de DQN simple ici : le petit jeu présente trop peu de surestimation pour que ces améliorations comptent
Mots-clés
apprentissage par renforcement · Pong à partir des pixels · Atari · gradient de politique · REINFORCE · A2C · PPO · DQN · dueling DQN · experience replay priorisé · retours n-step · empilement d’images · Arcade Learning Environment · Gymnasium · PyTorch