Pendulum RL
Swing-up et Acrobot avec toutes les méthodes classiques de RL
Douze méthodes d’apprentissage par renforcement redressent un pendule et un acrobot, avec le même budget, pour que leurs différences deviennent visibles.
- SAC −119,0 après 15k pas
- 16 entraînements en 31 min
- 40 tests
Construit avec PyTorchGymnasium
 NumPyMatplotlib
 pytest
Présentation
Pendulum-v1 est le plus petit problème de contrôle continu : un moteur trop faible pour soulever la tige directement, donc l’agent doit la balancer pour gagner de l’énergie, puis freiner et la maintenir à la verticale. Acrobot-v1 en est le cousin discret : deux segments avec un moteur au coude et une récompense de -1 à chaque pas jusqu’à ce que l’extrémité dépasse une ligne. Je voulais voir comment chaque méthode classique les aborde, pas seulement son score.
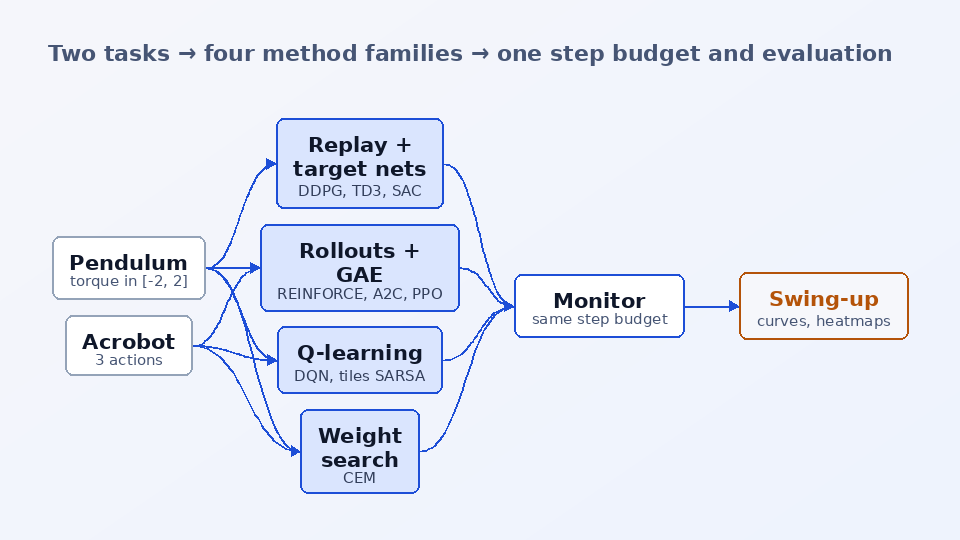
J’ai écrit une seule base de code PyTorch avec un fichier par famille : DDPG, TD3 et SAC avec réglage automatique de l’entropie pour le couple continu ; PPO avec GAE et clipping, A2C et REINFORCE sur les deux tâches ; la méthode de l’entropie croisée comme baseline sans gradient ; DQN, double et dueling DQN sur Acrobot et un DQN discrétisé sur le pendule ; et SARSA(lambda) avec tile coding et traces d’éligibilité, sans réseau de neurones. Chaque méthode passe par le même Monitor, qui compte les pas d’environnement et évalue la politique déterministe sur les mêmes états de départ.
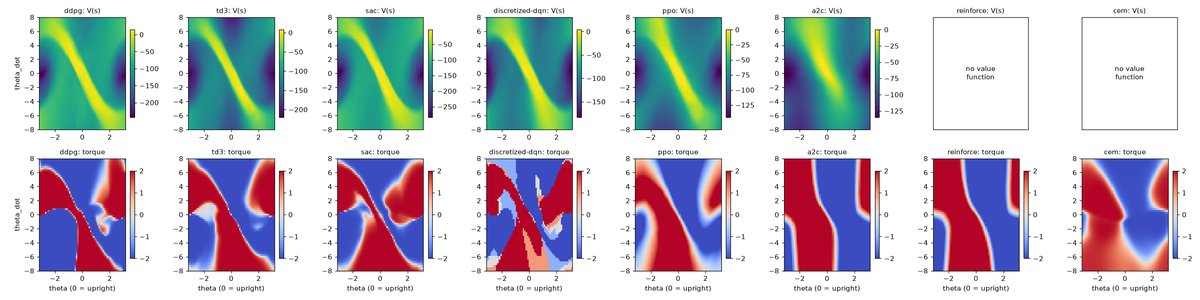
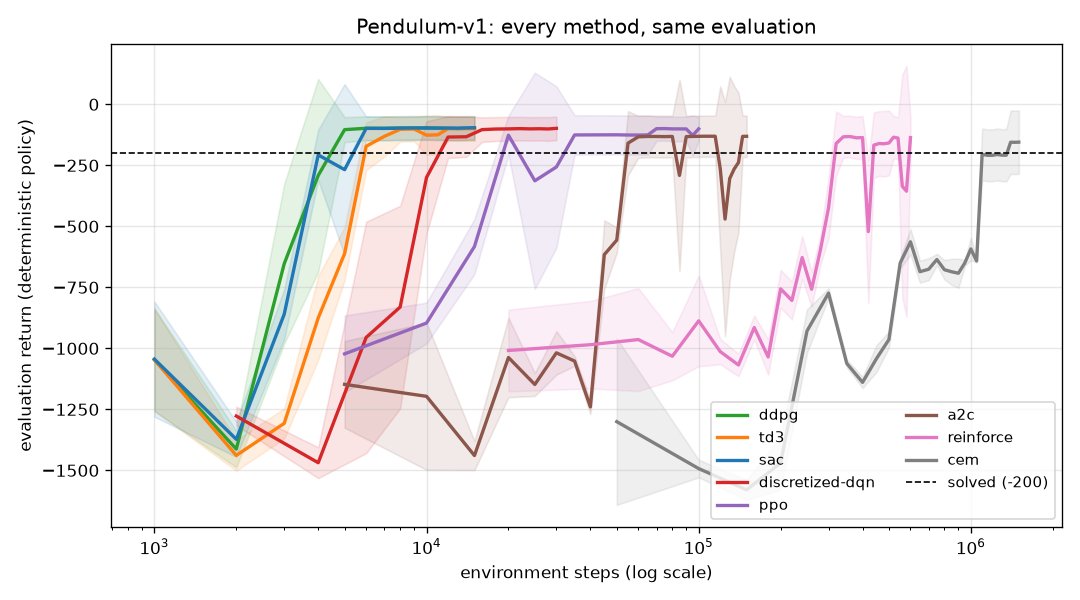
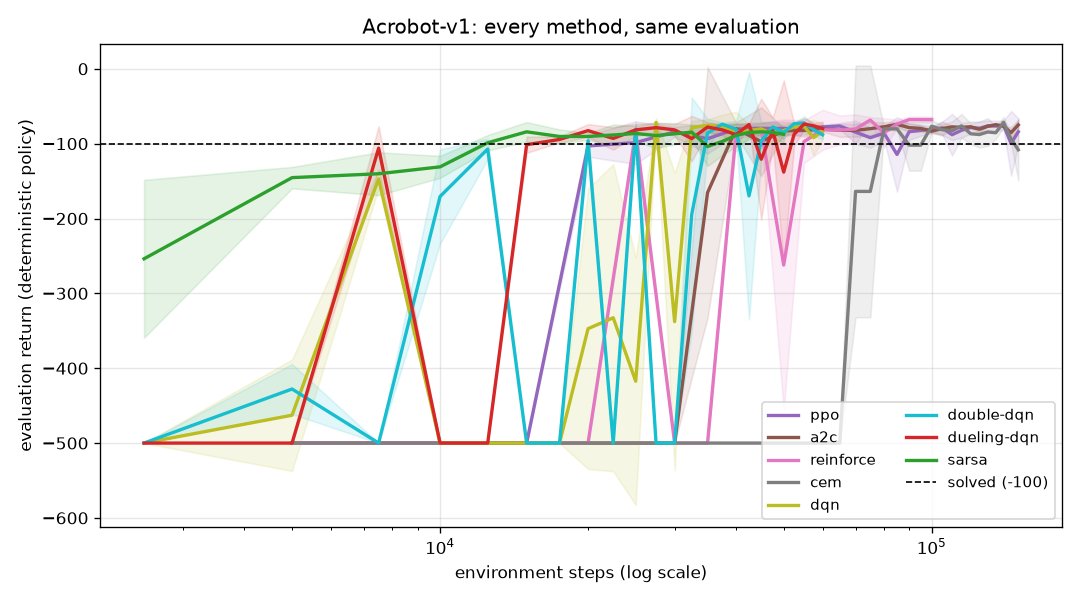
Sur Pendulum, les trois acteurs-critiques off-policy résolvent la tâche en 5-6k pas parce qu’ils rejouent chaque transition ; PPO a besoin d’environ quatre fois plus de pas, REINFORCE de 320k et CEM de 1.4M. Sur Acrobot, SARSA(lambda) avec tile coding est le plus rapide à atteindre le seuil de -100, en 12,500 pas et 12 secondes, et A2C obtient le meilleur retour final. Les heatmaps de valeur montrent que chaque critique trouve la même bande diagonale d’états qui mènent en roue libre jusqu’en haut, et que chaque politique est proche du bang-bang.
La question
Comment se comparent les acteurs-critiques off-policy, les gradients de politique on-policy, la recherche en boîte noire et les méthodes fondées sur la valeur sur deux mêmes tâches de contrôle classique, lorsqu’ils partagent un environnement, une unité de budget (les pas d’environnement) et une évaluation ?
Fonctionnalités clés
- Douze méthodes dans une seule base de code : DDPG, TD3, SAC, PPO, A2C, REINFORCE, CEM, DQN, double DQN, dueling DQN, DQN discrétisé et SARSA(lambda) avec tile coding, soit 16 paires (environnement, méthode) au total.
- Une boucle off-policy commune (replay buffer, warm-up, cibles de Polyak) et une boucle on-policy commune (rollouts, GAE, normalisation de l’avantage, clipping du gradient) : le fichier d’une méthode ne contient que sa règle d’apprentissage.
- Des budgets comptés en pas d’environnement pour tous, avec un Monitor qui évalue la politique déterministe toutes les quelques milliers de pas sur des graines de départ fixes.
- Des figures de ce que chaque agent a appris : heatmaps de V(s) et du couple sur (theta, theta_dot), courbes de retour avec bande d’écart-type, et GIF générés sans affichage via le pilote factice SDL.
- Un replay buffer qui stocke « terminated » séparément de « truncated », avec un GAE qui bootstrappe depuis la dernière observation après une limite de temps.
- Quatre CLI (pendulum-train, -eval, -play, -compare) où chaque champ de TrainConfig est une option, des valeurs par défaut réglées pour chaque paire (environnement, méthode), et un run_all.sh qui reproduit tous les chiffres.
- 40 tests rapides plus une vérification optionnelle du swing-up de SAC, six exemples numérotés, et un notebook Kaggle / Colab généré à partir du code source qui explique et entraîne chaque méthode.
Comment ça marche
Construire l’environnement
make_env renvoie Pendulum-v1 (observation cos theta, sin theta, theta_dot ; couple dans [-2, 2]) ou Acrobot-v1 (six nombres, trois couples au coude). Un wrapper DiscretizedAction découpe le couple du pendule en 5 valeurs pour DQN.
Choisir la forme de boucle
Les agents off-policy agissent, stockent la transition et font un pas de gradient sur un batch aléatoire. Les agents on-policy collectent un rollout, calculent les avantages GAE, se mettent à jour puis jettent les données. CEM exécute des épisodes complets pour chaque vecteur de poids candidat ; SARSA se met à jour à chaque pas via les traces d’éligibilité.
Apprendre
DDPG fait monter Q(s, mu(s)) ; TD3 ajoute deux critiques jumeaux, des mises à jour retardées de l’acteur et un lissage de la cible ; SAC maximise la récompense plus alpha fois l’entropie, avec alpha réglé sur une entropie cible de -1 ; PPO clippe le ratio de probabilités à 0.8-1.2 sur 10 époques ; les variantes de DQN régressent vers un réseau cible avec les corrections double et dueling.
Suivre sur le même axe
Le Monitor compte les pas d’environnement, enregistre chaque retour d’entraînement et lance 5 épisodes d’évaluation tous les eval_every pas avec la politique déterministe sur les graines 10000 et suivantes, soit les mêmes états de départ pour chaque méthode.
Comparer et inspecter
pendulum-compare entraîne chaque méthode et écrit le tableau de résultats (pas jusqu’au seuil, retour final sur 20 épisodes, temps réel), les courbes et les heatmaps de valeur / de couple évaluées sur une grille d’états 61x61.
Exemples
Entrée
pendulum-train --env pendulum --algo sac && pendulum-eval runs/pendulum/sac/model.pt --episodes 20
Sortie
final return -119.0 ± 82.5 over 20 episodes (15,000 steps, 1.8 min on one CPU thread)
Stack technique
Acteurs, critiques, Q-networks et fonctions de perte des gradients de politique
Pendulum-v1 et Acrobot-v1 de classic-control, ainsi que le wrapper DiscretizedAction
Politique et recherche de CEM, tile coder et poids de SARSA(lambda)
Courbes de retour, heatmaps de valeur / de couple et images des GIF
40 tests sur GAE, la troncature, la log-probabilité de la gaussienne écrasée, chaque paire (env, algo) et les CLI
Ce que j’ai appris
- Les fins « terminated » et « truncated » doivent être traitées séparément : les épisodes de Pendulum s’arrêtent sur une limite de temps, donc les cibles de valeur doivent quand même bootstrapper depuis l’état final
- REINFORCE sur Acrobot avait besoin d’une baseline indexée par le temps : la normalisation globale des retours transformait des épisodes ratés identiques en un faux signal début contre fin qui noyait la rare réussite
- Une décroissance linéaire du taux d’apprentissage a empêché PPO de s’effondrer de -126 à -980 en une seule mise à jour tardive
Limites
- Des runs CPU courts avec une seule graine : une autre graine peut changer le classement de méthodes proches, et je n’avais pas le budget pour vérifier si la moyenne finale de double DQN sur Acrobot (-108) vient de la graine ou de la méthode
- La décroissance du taux d’apprentissage ajoutée pour PPO a dégradé le résultat d’A2C sur Pendulum (-188.0, quelques swing-ups ratés) ; elle est conservée par cohérence et le résultat est rapporté tel que mesuré
Mots-clés
apprentissage par renforcement · contrôle continu · swing-up du pendule · Acrobot · DDPG · TD3 · SAC · PPO · GAE · méthode de l’entropie croisée · DQN · SARSA(lambda) · tile coding · Gymnasium · PyTorch