Pendulum RL
رفع البندول وAcrobot بكل طرق التعلم المعزز الكلاسيكية
اثنتا عشرة طريقة للتعلم المعزز ترفع بندولاً وAcrobot إلى الأعلى بالميزانية نفسها، كي تتضح الفروق بينها.
- SAC −119.0 بعد 15k خطوة
- 16 تجربة في 31 دقيقة
- 40 اختبارًا
التقنيات PyTorchGymnasium
 NumPyMatplotlib
 pytest
نظرة عامة
Pendulum-v1 هي أصغر مسألة تحكم مستمر: محرك أضعف من أن يرفع القضيب مباشرة، فعلى الوكيل أن يؤرجحه لاكتساب الطاقة، ثم يكبحه ويثبّته عمودياً. أما Acrobot-v1 فهي نظيرتها المتقطعة: ذراعان بمحرك عند المرفق، ومكافأة -1 في كل خطوة حتى يتجاوز الطرف خطاً معيناً. أردت أن أرى كيف تتعامل كل طريقة كلاسيكية معهما، لا نتيجتها فحسب.
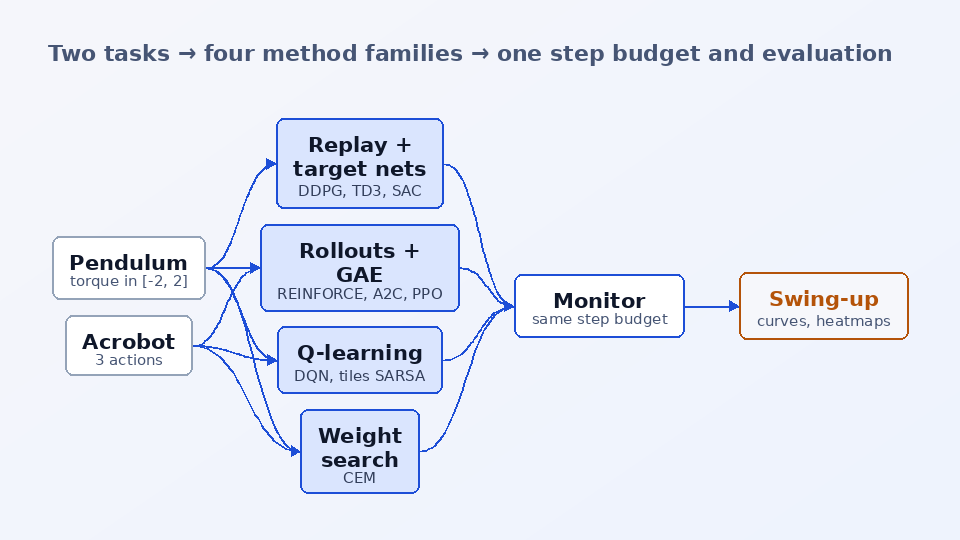
كتبتُ قاعدة شيفرة PyTorch واحدة بملف لكل عائلة: DDPG وTD3 وSAC مع ضبط تلقائي للإنتروبيا للعزم المستمر؛ وPPO مع GAE والقص، وA2C وREINFORCE على المهمتين؛ وطريقة الإنتروبيا المتقاطعة كخط أساس بلا تدرجات؛ وDQN وdouble DQN وdueling DQN على Acrobot وDQN بأفعال مقطَّعة على البندول؛ وSARSA(lambda) مع الترميز بالبلاطات (tile coding) وآثار الأهلية (eligibility traces) دون أي شبكة عصبية. تمر كل طريقة عبر Monitor نفسه، الذي يعدّ خطوات البيئة ويقيّم السياسة الحتمية على حالات البداية نفسها.
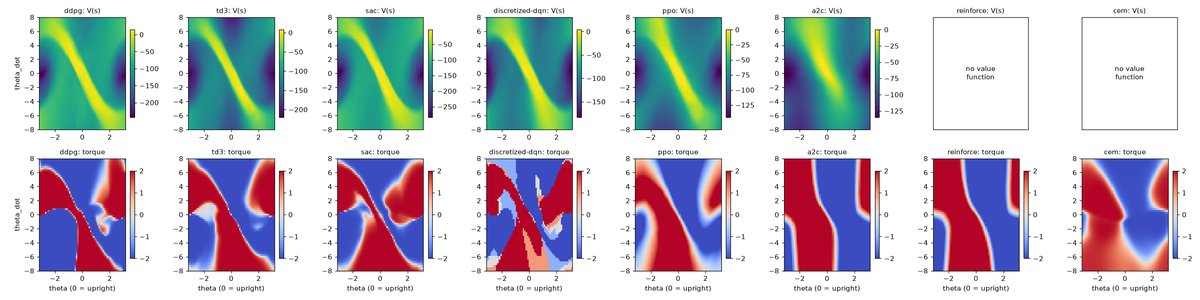
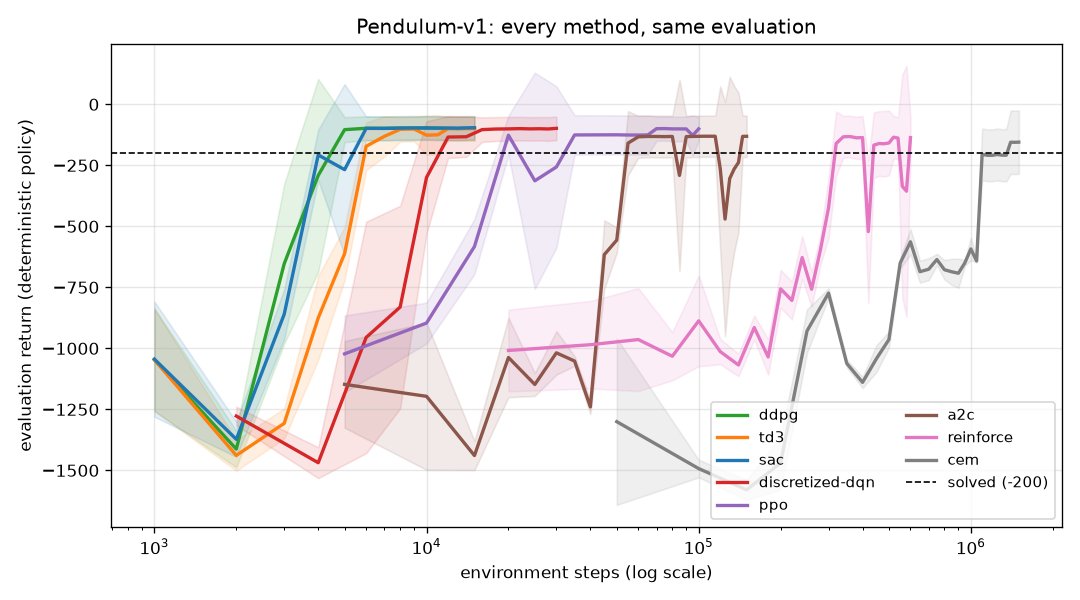
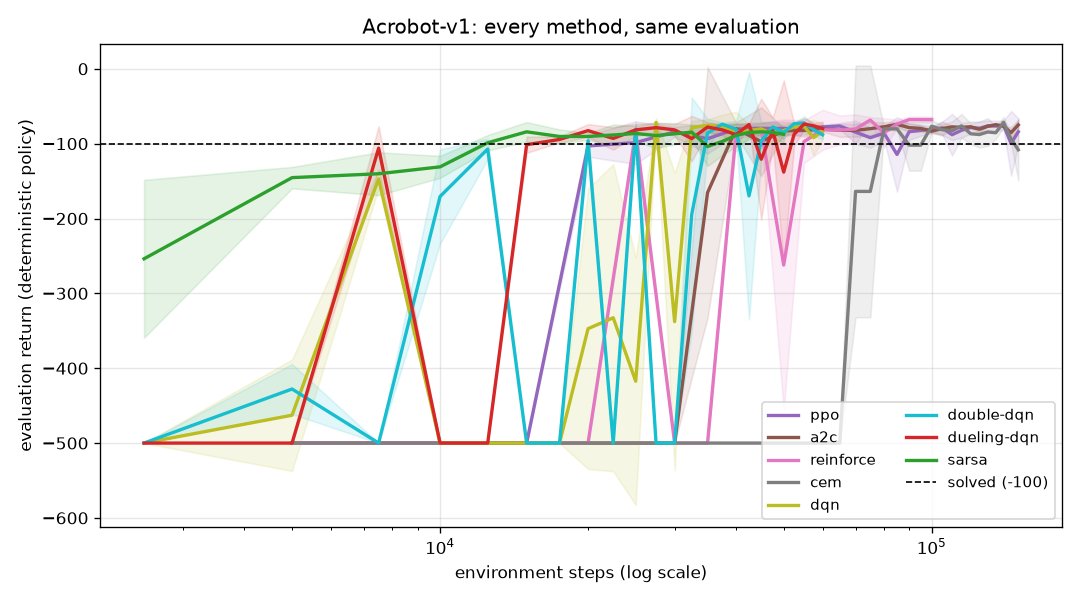
على Pendulum تحل طرق الممثل-الناقد الثلاث خارج السياسة المهمة في 5-6k خطوة لأنها تعيد تشغيل كل انتقال؛ ويحتاج PPO إلى نحو أربعة أضعاف ذلك، وREINFORCE إلى 320k وCEM إلى 1.4M. وعلى Acrobot يكون SARSA(lambda) مع الترميز بالبلاطات الأسرع إلى عتبة -100، في 12,500 خطوة و12 ثانية، ويحقق A2C أفضل عائد نهائي. تُظهر الخرائط الحرارية للقيمة أن كل ناقد يجد الشريط القطري نفسه من الحالات التي تنساب حتى القمة، وأن كل سياسة قريبة من التحكم الثنائي (bang-bang).
السؤال
كيف تتقارن طرق الممثل-الناقد خارج السياسة (off-policy)، وتدرجات السياسة ضمن السياسة (on-policy)، والبحث الصندوقي الأسود، والطرق القائمة على القيمة، على مهمتي تحكم كلاسيكيتين نفسيهما حين تتشارك بيئة واحدة ووحدة ميزانية واحدة (خطوات البيئة) وتقييماً واحداً؟
أهم الميزات
- اثنتا عشرة طريقة في قاعدة شيفرة واحدة: DDPG وTD3 وSAC وPPO وA2C وREINFORCE وCEM وDQN وdouble DQN وdueling DQN وDQN المقطَّع وSARSA(lambda) مع الترميز بالبلاطات، أي 16 زوجاً (بيئة، طريقة) إجمالاً.
- حلقة مشتركة خارج السياسة (مخزن إعادة التشغيل، وإحماء، وأهداف Polyak) وحلقة مشتركة ضمن السياسة (مسارات، وGAE، وتطبيع الميزة، وقص التدرج)، بحيث لا يحتوي ملف الطريقة إلا على قاعدة تعلمها.
- ميزانيات تُعدّ بخطوات البيئة للجميع، مع Monitor يقيّم السياسة الحتمية كل بضعة آلاف من الخطوات على بذور بداية ثابتة.
- رسوم لما تعلمه كل وكيل: خرائط حرارية لـ V(s) وللعزم على (theta، theta_dot)، ومنحنيات العائد مع نطاق الانحراف المعياري، وصور GIF دون واجهة عرض عبر مشغّل SDL الوهمي.
- مخزن إعادة تشغيل يحفظ الإنهاء (terminated) منفصلاً عن الاقتطاع (truncated)، مع GAE يستوفي ذاتياً من الملاحظة الأخيرة بعد انتهاء المهلة الزمنية.
- أربع واجهات سطر أوامر (pendulum-train و-eval و-play و-compare) يكون فيها كل حقل من TrainConfig خياراً، وقيم افتراضية مضبوطة لكل زوج (بيئة، طريقة)، وملف run_all.sh يعيد إنتاج كل الأرقام.
- 40 اختباراً سريعاً إضافة إلى فحص اختياري لرفع البندول بـ SAC، وستة أمثلة مرقَّمة، ودفتر Kaggle / Colab مبني من الشيفرة المصدرية يشرح كل طريقة ويدربها.
كيف يعمل
بناء البيئة
تعيد make_env بيئة Pendulum-v1 (الملاحظة cos theta وsin theta وtheta_dot؛ والعزم في [-2, 2]) أو Acrobot-v1 (ستة أعداد، وثلاثة عزوم للمرفق). ويقسم المغلِّف DiscretizedAction عزم البندول إلى 5 قيم لأجل DQN.
اختيار شكل الحلقة
الوكلاء خارج السياسة يتصرفون ويخزنون الانتقال ويأخذون خطوة تدرج على دفعة عشوائية. والوكلاء ضمن السياسة يجمعون مساراً ويحسبون مزايا GAE ثم يحدِّثون ويتخلصون من البيانات. ويشغّل CEM حلقات كاملة لكل متجه أوزان مرشَّح؛ ويتحدث SARSA في كل خطوة عبر آثار الأهلية.
التعلم
يصعد DDPG بالقيمة Q(s, mu(s))؛ ويضيف TD3 ناقدين توأمين وتحديثات متأخرة للممثل وتنعيماً للهدف؛ ويعظّم SAC المكافأة زائد alpha مضروباً في الإنتروبيا، مع ضبط alpha نحو إنتروبيا هدف قدرها -1؛ ويقص PPO نسبة الاحتمالات إلى 0.8-1.2 على 10 حقب؛ وتنحدر متغيرات DQN نحو شبكة هدف مع تصحيحات double وdueling.
المراقبة على المحور نفسه
يعدّ Monitor خطوات البيئة، ويسجل كل عائد تدريب، ويشغّل 5 حلقات تقييم كل eval_every خطوة بالسياسة الحتمية على البذور من 10000 فصاعداً، أي حالات البداية نفسها لكل طريقة.
المقارنة والفحص
يدرّب pendulum-compare كل طريقة ويكتب جدول النتائج (الخطوات حتى العتبة، والعائد النهائي على 20 حلقة، والزمن الفعلي)، والمنحنيات، والخرائط الحرارية للقيمة / العزم المقيَّمة على شبكة حالات 61x61.
أمثلة
المدخل
pendulum-train --env pendulum --algo sac && pendulum-eval runs/pendulum/sac/model.pt --episodes 20
المخرج
final return -119.0 ± 82.5 over 20 episodes (15,000 steps, 1.8 min on one CPU thread)
التقنيات المستخدمة
الممثلون والنقاد وشبكات Q ودوال خسارة تدرج السياسة
Pendulum-v1 وAcrobot-v1 من classic-control، إضافة إلى المغلِّف DiscretizedAction
سياسة CEM وبحثها، ومرمِّز البلاطات، وأوزان SARSA(lambda)
منحنيات العائد، والخرائط الحرارية للقيمة / العزم، وإطارات صور GIF
40 اختباراً على GAE والاقتطاع والاحتمال اللوغاريتمي للتوزيع الغاوسي المضغوط وكل زوج (env، algo) وواجهات سطر الأوامر
ما تعلمته
- يجب التعامل مع الإنهاء (terminated) والاقتطاع (truncated) بشكل منفصل: حلقات Pendulum تنتهي بانتهاء الوقت، لذا يجب أن تستمر أهداف القيمة في الاستيفاء الذاتي من الحالة الأخيرة
- احتاج REINFORCE على Acrobot إلى خط أساس مفهرس بالزمن: فتطبيع العوائد المجمّعة حوّل الحلقات الفاشلة المتطابقة إلى إشارة زائفة بين البداية والنهاية أغرقت النجاح النادر
- منع التخفيض الخطي لمعدل التعلم PPO من الانهيار من -126 إلى -980 في تحديث متأخر واحد
الحدود
- تشغيلات قصيرة على المعالج المركزي ببذرة واحدة: قد تغيّر بذرة أخرى ترتيب الطرق المتقاربة، ولم تكن لدي الميزانية للتحقق مما إذا كان المتوسط النهائي لـ double DQN على Acrobot (-108) راجعاً إلى البذرة أم إلى الطريقة
- أضرّ تخفيض معدل التعلم المضاف لـ PPO بنتيجة A2C على Pendulum (-188.0، مع بضع محاولات رفع فاشلة)؛ أبقيت عليه من أجل الاتساق وأوردت النتيجة كما قيست
الكلمات المفتاحية
التعلم المعزز · التحكم المستمر · رفع البندول · Acrobot · DDPG · TD3 · SAC · PPO · GAE · طريقة الإنتروبيا المتقاطعة · DQN · SARSA(lambda) · الترميز بالبلاطات · Gymnasium · PyTorch