MountainCar RL
جميع عائلات التعلم المعزز على مهمة واحدة نادرة المكافأة
سيارة أضعف من أن تصعد التل، وكل عائلات التعلم المعزز تحاول تعلّم حركة التأرجح التي توصلها إلى العلم.
- نجاح 100% مع tile coding
- مكافأة الجِدّة: DQN من 0% إلى 100%
التقنيات PyTorchGymnasium
 NumPyMatplotlib
 pytest
نظرة عامة
تمنح بيئة MountainCar مكافأة -1 في كل خطوة حتى الوصول إلى العلم، لذا تحصل كل حلقة فاشلة على -200 بالضبط، ولا يتلقى المتعلم أي تلميح إلى أن يصل إلى العلم مرة واحدة. المحرك أضعف من الجاذبية، فعلى السيارة أن تتأرجح ذهاباً وإياباً لتجميع الطاقة. إنها مسألة الاستكشاف الكلاسيكية، وهي صغيرة بما يكفي لتتدرب كل طريقة على خيط معالج واحد في ثوانٍ إلى بضع دقائق.
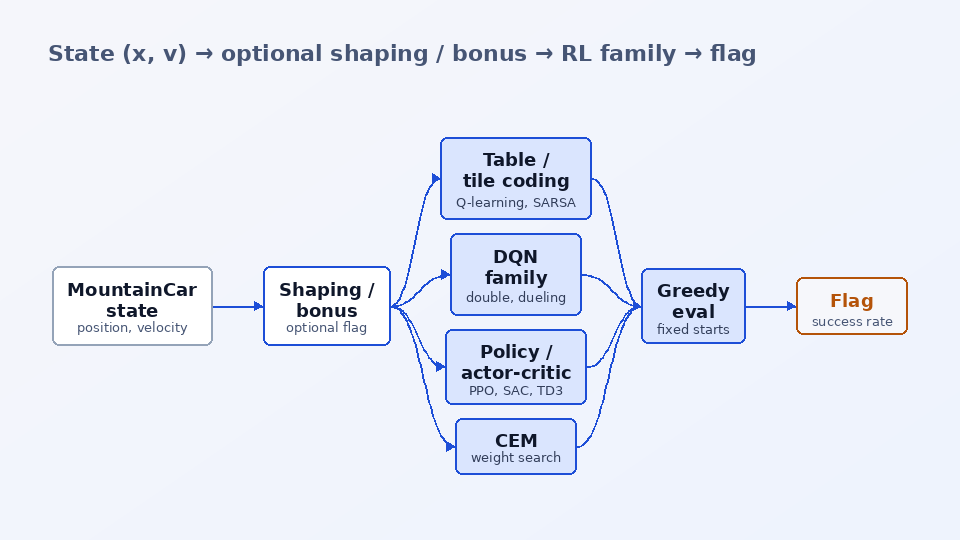
كتبتُ قاعدة شيفرة صغيرة تكون فيها كل طريقة وكيلاً (Agent) بالدوال الخمس نفسها، وتشغّلها جميعاً حلقة تدريب واحدة: Q-learning وSARSA بعد التقطيع، والترميز بالبلاطات (tile coding)، وDQN / Double / Dueling DQN مع إعادة التشغيل ذات الأولوية (prioritized replay) وعوائد n-step، وREINFORCE وA2C وPPO وDDPG وTD3 وSAC وطريقة الإنتروبيا المتقاطعة. أدوات المساعدة على الاستكشاف (تشكيل قائم على دالة جهد للطاقة أو الارتفاع، ومكافآت العدّ وRND، وجداول epsilon) مغلِّفات للبيئة تُفعَّل بخيارات، فلا تعرف الخوارزميات أبداً ما إذا كانت المكافأة مشكَّلة، وكل جدول يعرض المكافأة الحقيقية.
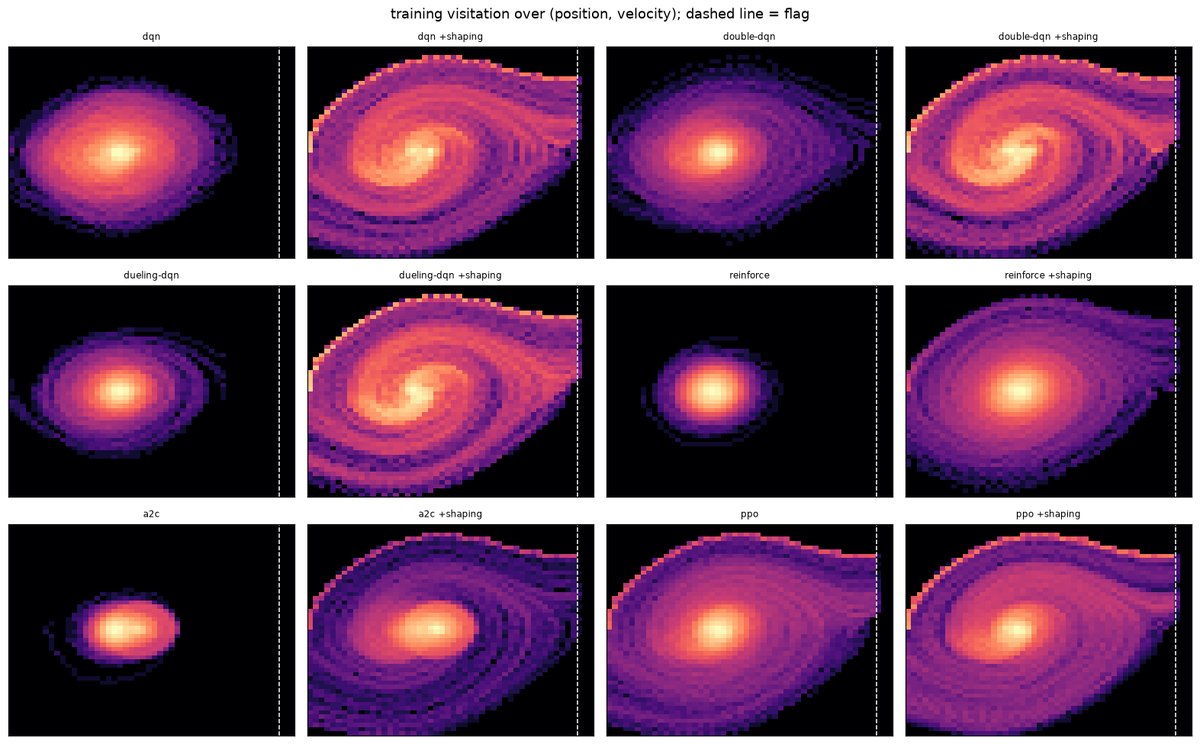
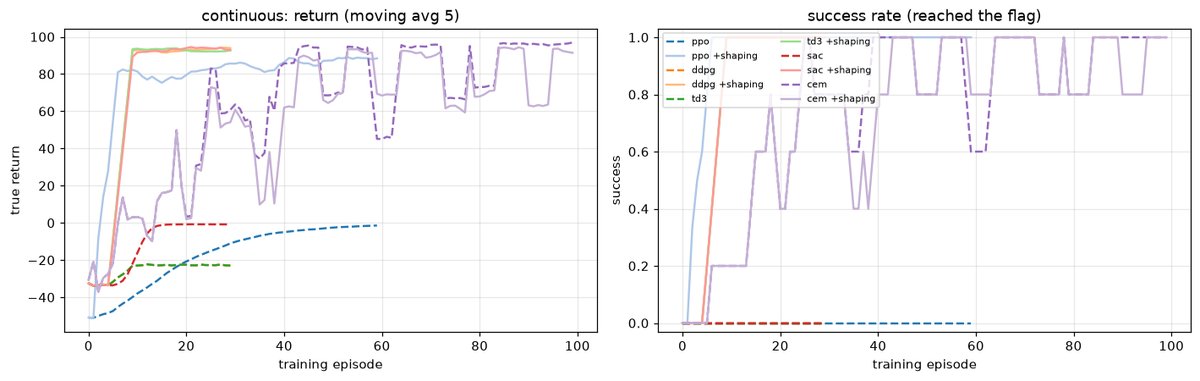
تجيب المقارنة عن سؤال واحد: أي الطرق تجد العلم بنفسها وأيها تحتاج إلى مساعدة. يحل الترميز بالبلاطات وCEM المهمة المتقطعة في نحو 25 حلقة دون مساعدة. لا تصل DQN وDueling DQN وREINFORCE وA2C إلى العلم أبداً بالمكافأة الخام ضمن ميزانيتها؛ ومع تشكيل الطاقة تحلها جميع الطرق، ومكافأة حداثة قائمة على العدّ لا تعرف شيئاً عن الفيزياء تفعل الشيء نفسه مع DQN. وفي النسخة المستمرة تتقارب PPO وDDPG وTD3 وSAC جميعها نحو عدم فعل أي شيء دون تشكيل، لأن الإشارة الوحيدة قبل أي نجاح هي كلفة الفعل.
السؤال
في مهمة تحصل فيها كل حلقة فاشلة على -200 بالضبط، ما طرق التعلم المعزز (Reinforcement Learning) التي تكتشف الهدف بنفسها، وماذا تغيّر الإشارة الكثيفة (تشكيل قائم على دالة جهد أو مكافأة حداثة) بالنسبة إلى الطرق التي لا تكتشفه؟
أهم الميزات
- أربع عشرة طريقة خلف واجهة Agent واحدة وحلقة تدريب واحدة: Q-learning وSARSA والترميز بالبلاطات (بهدف SARSA أو Q) وDQN وDouble DQN وDueling DQN وREINFORCE وA2C وPPO وDDPG وTD3 وSAC وCEM.
- البيئتان كلتاهما: MountainCar-v0 (ثلاثة أفعال، حد 200 خطوة) وMountainCarContinuous-v0 (قوة في [-1, 1]، 999 خطوة)، مع تشغيل PPO وCEM على أي منهما.
- أدوات المساعدة على الاستكشاف كخيارات: تشكيل قائم على دالة جهد للطاقة أو الارتفاع، ومكافأة عدّ على شبكة 40x40، وتقطير الشبكة العشوائية (Random Network Distillation)، وجداول epsilon ثابتة / خطية / أُسية.
- إعادة تشغيل ذات أولوية على شجرة مجاميع (sum tree) ومجمِّع n-step لعائلة DQN، مع اختبار يتحقق من أن الانتقال ذا الخطأ الأكبر هو الذي يُختار.
- بروتوكول تقييم واحد للجميع: سياسة جشعة، و20 حالة بداية ثابتة، والمكافأة الحقيقية، مع عرض معدل النجاح ومتوسط العائد ومتوسط عدد الخطوات والحلقات حتى أول نجاح.
- أربع واجهات سطر أوامر (mountaincar-train و-eval و-play و-compare) تنتج المنحنيات وخرائط الزيارات / القيمة / السياسة والجداول وصور GIF في ملف README؛ و51 اختباراً تعمل في نحو دقيقة.
- دفتر Kaggle / Colab مبني من الشيفرة المصدرية يشرح كل تحديث خطوة بخطوة ويشغّل المقارنة الكاملة على ثلاث بذور.
كيف يعمل
تمثيل الحالة
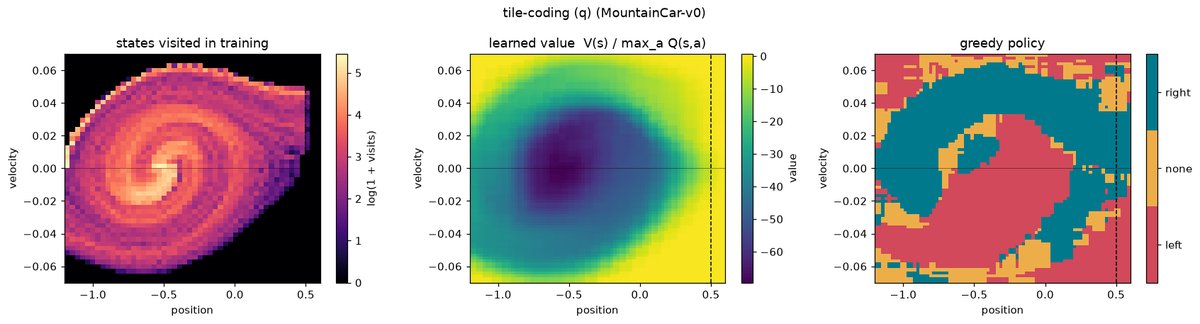
الحالة هي (الموضع، السرعة). تستخدم الطرق الجدولية شبكة 16x16، ويستخدم الترميز بالبلاطات 8 تبليطات 8x8 مُزاحة مع Q خطية، وتأخذ الطرق العصبية الحالة مطبَّعة إلى [-1, 1]^2.
تغليف المكافأة (اختياري)
يضيف ShapingWrapper القيمة gamma * Phi(s') - Phi(s) حيث Phi الطاقة الميكانيكية أو الارتفاع، وهذا يترك السياسة المثلى دون تغيير. ويضيف IntrinsicWrapper القيمة 0.1 / sqrt(N(cell)) أو خطأ التنبؤ في RND. تُحفظ المكافأة الحقيقية في info، وهي ما تعرضه كل الجداول.
حلقة واحدة لكل الوكلاء
يستدعي train.py الدالتين act وobserve لكل طريقة: مدخل جدول واحد لـ Q-learning، و8 أوزان للترميز بالبلاطات، وخطوة على دفعة صغيرة لـ DQN / DDPG / TD3 / SAC، أو تخزين الانتقال حتى يكتمل المسار (rollout) لـ A2C وPPO وREINFORCE وCEM.
تقييم جشع من بدايات ثابتة
يعيد evaluate.py التهيئة بالبذور 1000-1019، ويعطّل epsilon وضجيج الأفعال والتشكيل، ويسجل معدل النجاح والعائد وعدد الخطوات، فتواجه كل طريقة حالات البداية نفسها.
المقارنة
يشغّل compare.py مجموعة تجارب (جدولية، عميقة متقطعة، استكشاف، مستمرة)، ويكتب جداول markdown ويرسم منحنيات التدريب وخرائط الزيارات الحرارية وخرائط السياسة من التشغيلات المحفوظة.
أمثلة
المدخل
mountaincar-eval runs/tabular/tile-coding_q --episodes 100
المخرج
success 100%, mean return -118.9 (std 15.2), 119 steps
التقنيات المستخدمة
شبكات Q والسياسات والنقاد لطرق DQN وتدرج السياسة والممثل-الناقد
MountainCar-v0 وMountainCarContinuous-v0 من classic-control، إضافة إلى مغلِّفات التشكيل والمكافأة الجوهرية
جداول Q ومرمِّز البلاطات وCEM وإعادة التشغيل بشجرة المجاميع
منحنيات التدريب وخرائط الزيارات / القيمة / السياسة وخريطة السياسة المتحركة
51 اختباراً: تلاشي التشكيل تلسكوبياً، والاختيار ذو الأولوية، وتدرّب كل طريقة وإعادة تحميلها، وحل الترميز بالبلاطات للمهمة
ما تعلمته
- التهيئة المتفائلة شكل من أشكال الاستكشاف: الجدول أو أوزان البلاطات المهيأة بالصفر تفوق كل عائد حقيقي، فيجرّب الوكيل الجشع كل فعل لم يجربه بعد؛ أما شبكة Q فلا تملك هذه الخاصية
- التشكيل القائم على دالة جهد يتلاشى تلسكوبياً إلى خط أساس (baseline) داخل عائد مونت كارلو، لذا يساعد كل طرق الاستيفاء الذاتي (bootstrapping) لكنه بالكاد يساعد REINFORCE
الحدود
- تشغيلات قصيرة على المعالج المركزي ببذرة واحدة على جهاز مشترك: تُظهر الطرق التي تتعلم بميزانية صغيرة وليست مقاييس معيارية (benchmarks)؛ وقد لا يتكرر نجاح Double DQN وPPO دون تشكيل مع بذرة أخرى
- النتائج الموسومة بـ +shaping تستخدم معرفة بالفيزياء، فلا تمثل مقارنة عادلة مع الطرق غير المشكَّلة
الكلمات المفتاحية
التعلم المعزز · MountainCar · مكافأة نادرة · الاستكشاف · Q-learning · الترميز بالبلاطات · DQN · PPO · SAC · طريقة الإنتروبيا المتقاطعة · تشكيل المكافأة · Random Network Distillation · إعادة تشغيل التجارب ذات الأولوية · Gymnasium · PyTorch