MountainCar RL
Toutes les familles de RL sur une seule tâche à récompense rare
Une voiture trop faible pour gravir la colline, et toutes les familles de RL qui tentent d’apprendre le mouvement de balancier qui la mène jusqu’au drapeau.
- 100 % de réussite avec le tile coding
- Bonus de nouveauté : DQN de 0 % à 100 %
Construit avec PyTorchGymnasium
 NumPyMatplotlib
 pytest
Présentation
MountainCar donne -1 par pas jusqu’au drapeau : chaque épisode raté vaut donc exactement -200, et l’agent ne reçoit aucun indice tant qu’il n’a pas atteint le drapeau une première fois. Le moteur est plus faible que la gravité, la voiture doit donc se balancer d’avant en arrière pour accumuler de l’énergie. C’est le problème d’exploration classique, et il est assez petit pour que chaque méthode s’entraîne sur un seul thread CPU en quelques secondes à quelques minutes.
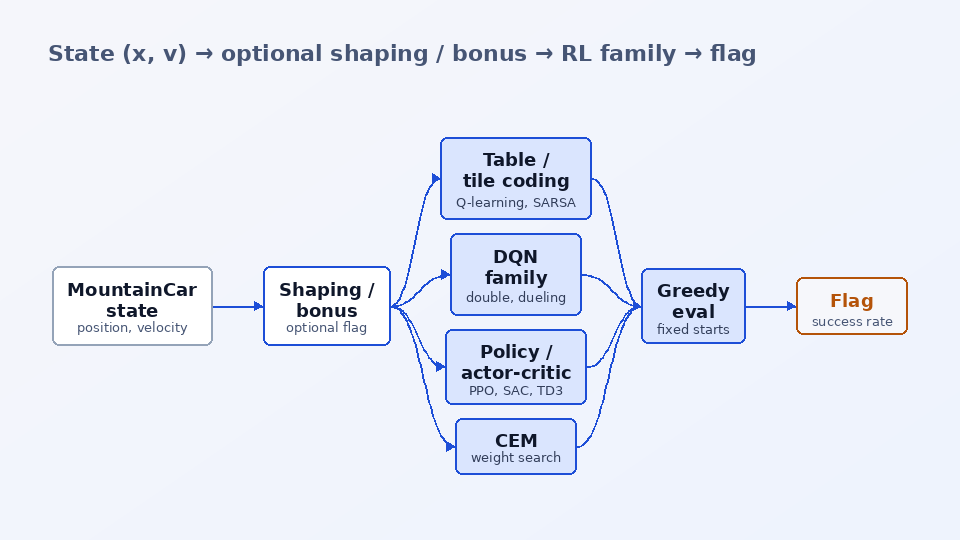
J’ai écrit une petite base de code où chaque méthode est un Agent doté des cinq mêmes méthodes, et une seule boucle d’entraînement les exécute toutes : Q-learning et SARSA discrétisés, tile coding, DQN / Double / Dueling DQN avec replay priorisé et retours n-step, REINFORCE, A2C, PPO, DDPG, TD3, SAC et la méthode de l’entropie croisée. Les aides à l’exploration (shaping basé sur un potentiel d’énergie ou de hauteur, bonus de comptage et RND, calendriers d’epsilon) sont des wrappers d’environnement activés par des options : les algorithmes ne savent jamais si la récompense a été modifiée, et chaque tableau rapporte la vraie récompense.
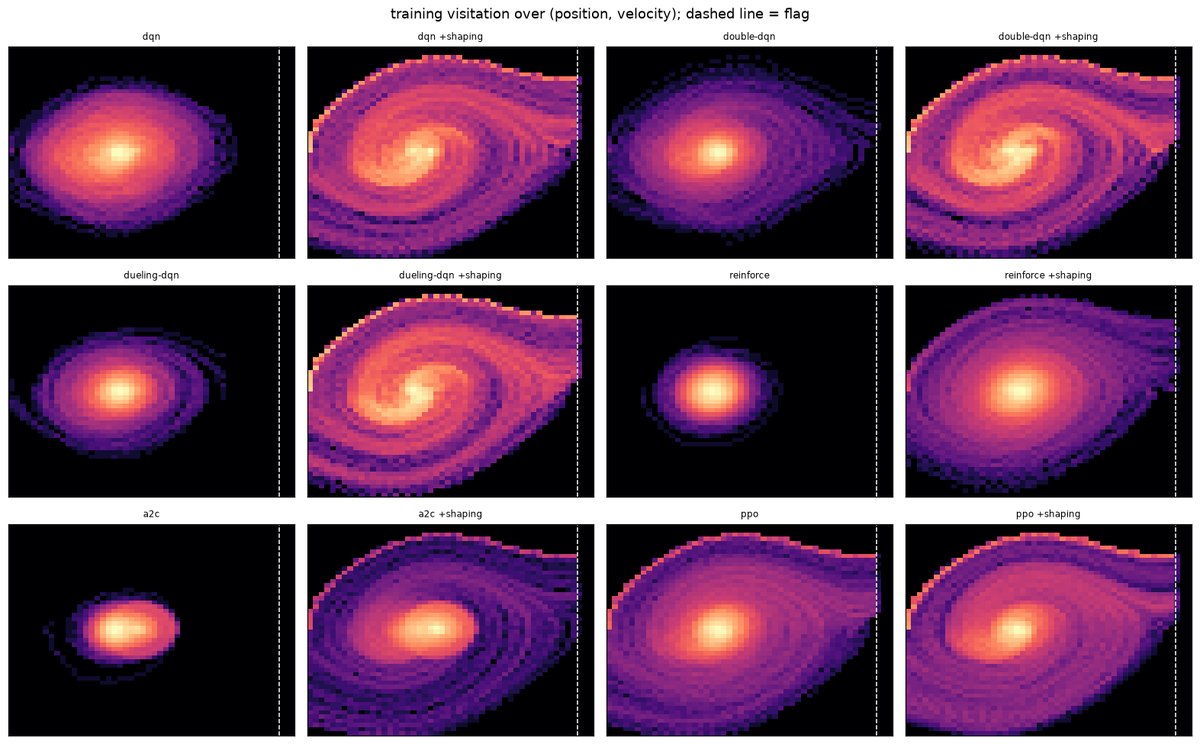
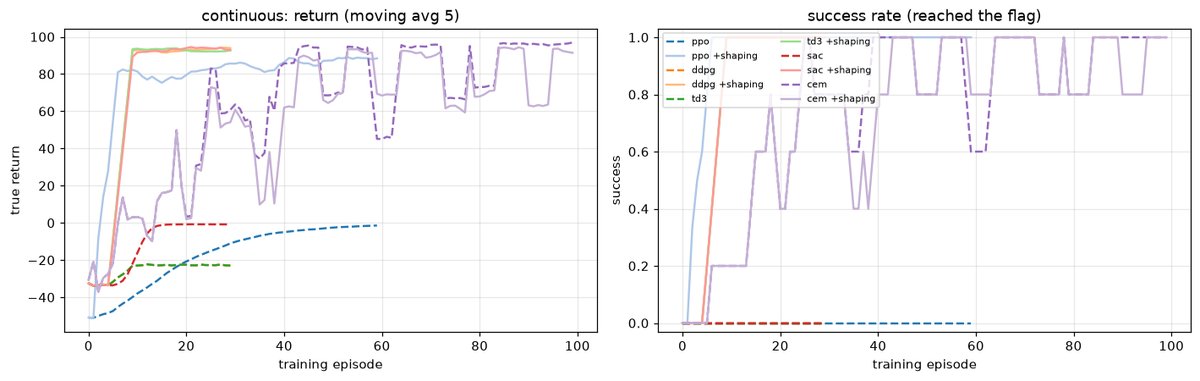
La comparaison répond à une question : quelles méthodes trouvent le drapeau seules, et lesquelles ont besoin d’aide. Le tile coding et CEM résolvent la tâche discrète en environ 25 épisodes sans aide. DQN, Dueling DQN, REINFORCE et A2C n’atteignent jamais le drapeau avec la récompense brute dans leur budget ; avec le shaping énergétique, toutes les méthodes la résolvent, et un bonus de nouveauté fondé sur des comptages, qui ne sait rien de la physique, fait de même pour DQN. En version continue, PPO, DDPG, TD3 et SAC convergent tous vers l’inaction sans shaping, car le seul signal avant une réussite est le coût de l’action.
La question
Sur une tâche où chaque épisode raté vaut exactement -200, quelles méthodes d’apprentissage par renforcement découvrent l’objectif par elles-mêmes, et qu’apporte un signal dense (shaping basé sur un potentiel ou bonus de nouveauté) à celles qui n’y parviennent pas ?
Fonctionnalités clés
- Quatorze méthodes derrière une même interface Agent et une même boucle d’entraînement : Q-learning, SARSA, tile coding (cible SARSA ou Q), DQN, Double DQN, Dueling DQN, REINFORCE, A2C, PPO, DDPG, TD3, SAC et CEM.
- Les deux environnements : MountainCar-v0 (trois actions, limite de 200 pas) et MountainCarContinuous-v0 (force dans [-1, 1], 999 pas), PPO et CEM fonctionnant sur l’un comme sur l’autre.
- Les aides à l’exploration sous forme d’options : shaping basé sur un potentiel d’énergie ou de hauteur, bonus de comptage sur une grille 40x40, Random Network Distillation, et calendriers d’epsilon constant / linéaire / exponentiel.
- Replay priorisé sur un sum tree et accumulateur n-step pour la famille DQN, avec un test qui vérifie que la transition à forte erreur est bien celle qui est échantillonnée.
- Un même protocole d’évaluation pour tous : politique gloutonne, 20 états de départ fixes, vraie récompense, avec taux de réussite, retour moyen, nombre moyen de pas et épisodes avant la première réussite.
- Quatre CLI (mountaincar-train, -eval, -play, -compare) qui produisent les courbes, les cartes de visites / de valeur / de politique, les tableaux et les GIF du README ; 51 tests s’exécutent en environ une minute.
- Un notebook Kaggle / Colab généré à partir du code source, qui explique chaque mise à jour pas à pas et lance la comparaison complète sur trois graines.
Comment ça marche
Représenter l’état
L’état est (position, vitesse). Les méthodes tabulaires utilisent une grille 16x16, le tile coding utilise 8 pavages 8x8 décalés avec un Q linéaire, et les méthodes neuronales reçoivent l’état normalisé dans [-1, 1]^2.
Modifier la récompense (optionnel)
ShapingWrapper ajoute gamma * Phi(s') - Phi(s), où Phi est l’énergie mécanique ou la hauteur, ce qui laisse la politique optimale inchangée. IntrinsicWrapper ajoute 0.1 / sqrt(N(cell)) ou une erreur de prédiction RND. La vraie récompense est conservée dans info, et c’est elle que montrent tous les tableaux.
Une seule boucle pour tous les agents
train.py appelle act et observe sur chaque méthode : une entrée de table pour le Q-learning, 8 poids pour le tile coding, un pas sur un minibatch pour DQN / DDPG / TD3 / SAC, ou une transition stockée jusqu’à ce qu’un rollout soit complet pour A2C, PPO, REINFORCE et CEM.
Évaluer en glouton sur des départs fixes
evaluate.py réinitialise avec les graines 1000-1019, désactive epsilon, le bruit d’action et le shaping, et enregistre le taux de réussite, le retour et le nombre de pas : chaque méthode affronte les mêmes états de départ.
Comparer
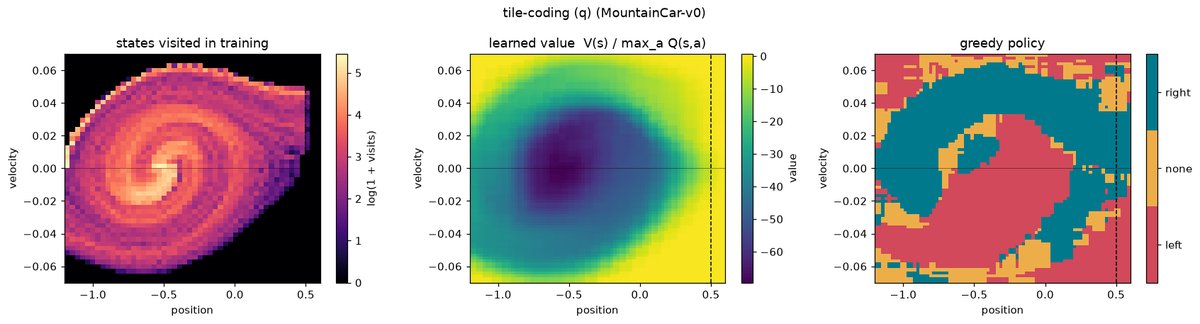
compare.py lance une suite (tabulaire, deep discret, exploration, continu), écrit les tableaux markdown et trace les courbes d’entraînement, les heatmaps de visites et les cartes de politique à partir des runs sauvegardés.
Exemples
Entrée
mountaincar-eval runs/tabular/tile-coding_q --episodes 100
Sortie
success 100%, mean return -118.9 (std 15.2), 119 steps
Stack technique
Q-networks, politiques et critiques pour DQN, les gradients de politique et les méthodes acteur-critique
MountainCar-v0 et MountainCarContinuous-v0 de classic-control, ainsi que les wrappers de shaping et de motivation intrinsèque
Q-tables, tile coder, CEM et le replay sur sum tree
Courbes d’entraînement, cartes de visites / de valeur / de politique et carte de politique animée
51 tests : télescopage du shaping, échantillonnage priorisé, chaque méthode s’entraîne et se recharge, le tile coding résout la tâche
Ce que j’ai appris
- L’initialisation optimiste est une forme d’exploration : une table ou des poids de tile coding initialisés à zéro dépassent tous les retours réels, donc un agent glouton essaie chaque action non tentée ; un Q-network n’a pas cette propriété
- Le shaping basé sur un potentiel se télescope en une baseline dans un retour Monte Carlo : il aide toutes les méthodes à bootstrapping mais presque pas REINFORCE
Limites
- Des runs CPU courts avec une seule graine sur une machine partagée : ils montrent quelles méthodes apprennent avec un petit budget, ce ne sont pas des benchmarks ; les réussites de Double DQN et PPO sans shaping pourraient ne pas se reproduire avec une autre graine
- Les résultats marqués +shaping utilisent une connaissance de la physique et ne constituent pas une comparaison équitable avec les méthodes sans shaping
Mots-clés
apprentissage par renforcement · MountainCar · récompense rare · exploration · Q-learning · tile coding · DQN · PPO · SAC · méthode de l’entropie croisée · reward shaping · Random Network Distillation · experience replay priorisé · Gymnasium · PyTorch