LunarLander RL
Onze méthodes de deep RL sur un même benchmark
De DQN à SAC, chacun dans un fichier lisible, pour poser le même module sous la même évaluation.
- PPO 276,4 ± 18,2
- Version continue résolue en 1,5 min
- DQN > 200 à 50k pas
Construit avec PyTorchGymnasiumBox2D
 NumPyMatplotlib
 pytest
Présentation
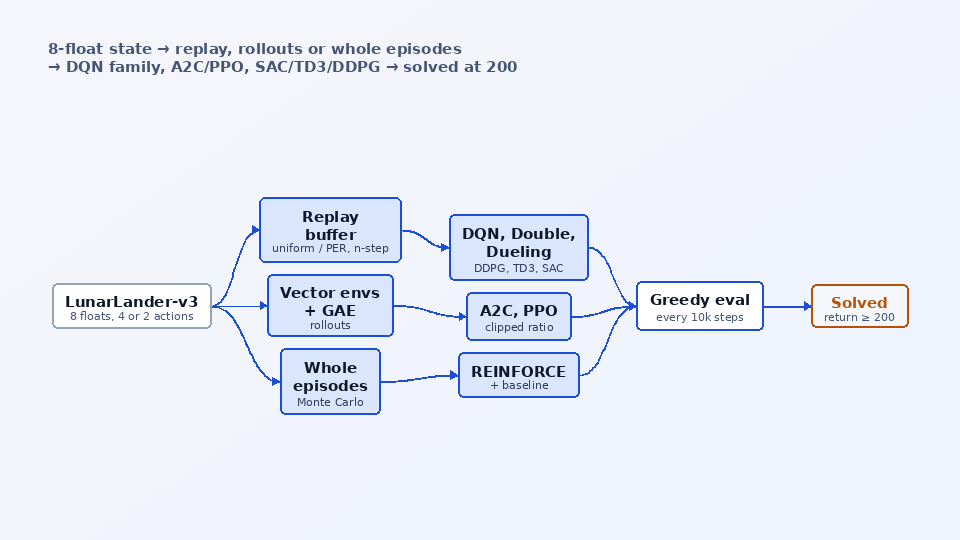
LunarLander est l’étape d’après CartPole : un état de 8 flottants, un +100 rare pour s’immobiliser, un -100 en cas de crash, un coût en carburant, et un plateau de vol stationnaire qui piège beaucoup d’agents. Je m’en suis servi pour implémenter les méthodes classiques de deep RL, une par fichier, et les comparer honnêtement : DQN avec ses variantes double et dueling, le replay priorisé et les retours à 3 pas, REINFORCE avec baseline, A2C, PPO et SAC discret sur l’atterrisseur à 4 boutons, et DDPG, TD3, SAC et PPO gaussien sur la version continue à 2 gaz.
Chaque algorithme fait 60-120 lignes, avec sa règle de mise à jour écrite sous forme d’équations dans la docstring ; les réseaux sont de petits MLP, et une seule dataclass Config décrit n’importe quel run. Toutes les méthodes partagent l’environnement, les graines, un Tracker qui lance une évaluation gloutonne tous les 10,000 pas sur des épisodes fixes non vus, un score final sur 20 épisodes, les courbes et le tableau comparatif. 49 tests vérifient les buffers, la GAE et les log-probabilités, et que chaque agent apprend un bandit.
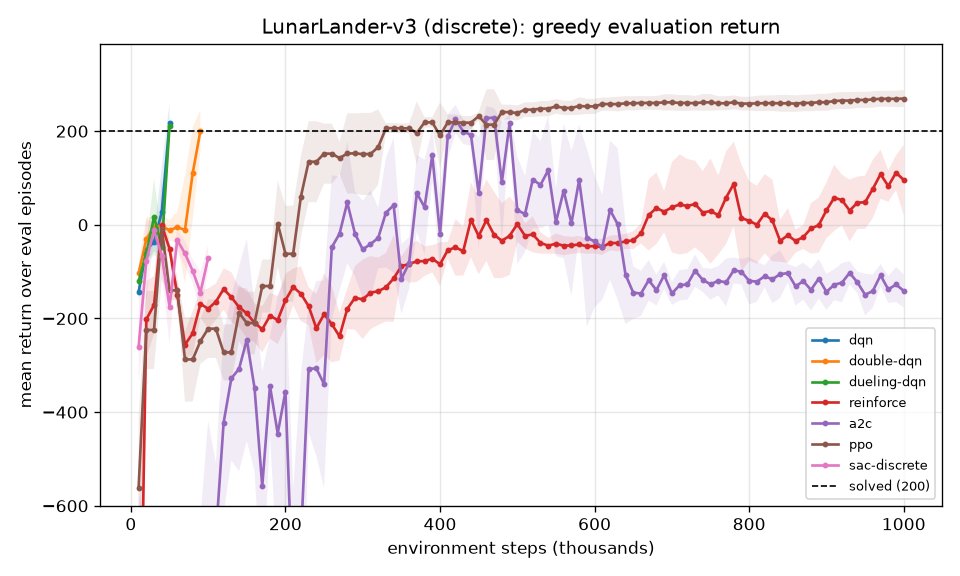
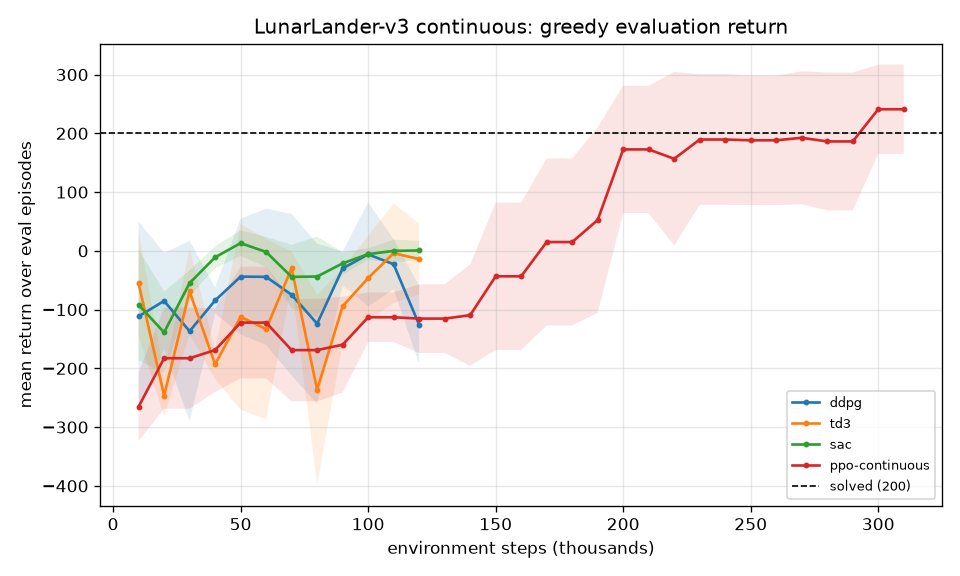
Sur un seul thread CPU, PPO est la plus fiable (276.4 +- 18.2 après résolution à 330,000 pas) et sa version gaussienne résout l’atterrisseur continu en 1.5 minute. DQN et dueling DQN résolvent à 50,000 pas, double DQN à 90,000. A2C atteint 200 puis s’effondre, REINFORCE progresse lentement, et les méthodes off-policy continues sont encore en vol stationnaire quand leurs budgets de 120,000 pas s’épuisent.
La question
Lesquels des algorithmes classiques de deep RL posent le module en quelques minutes sur un seul thread CPU, et que montrent leurs courbes sur le compromis entre efficacité en échantillons et stabilité ?
Fonctionnalités clés
- Onze méthodes derrière un seul flag
--method: dqn, double-dqn, dueling-dqn (avec PER et retours à 3 pas), reinforce, a2c, ppo, sac-discrete, ddpg, td3, sac et ppo-continuous. - Une seule dataclass Config pour tous les hyperparamètres, avec des presets par méthode et des surcharges
--set key=value; chaque run sauvegarde sa configuration, ses poids et ses métriques. - Une boucle de replay commune aux méthodes off-policy avec replay uniforme ou priorisé (sum-tree) et retours à n pas, et un collecteur de rollouts commun avec GAE pour A2C et PPO sur 8-16 environnements vectorisés.
- Troncature bootstrappée partout : les replay buffers ne stockent done que pour un vrai crash ou atterrissage, et les rollouts ajoutent gamma V(final_obs) à la limite de temps de 1,000 pas.
- Un seul protocole d’évaluation : actions gloutonnes, évaluations périodiques sur 10 épisodes à graines fixes, un score final sur 20 épisodes avec d’autres graines, et des baselines aléatoire et contrôleur PID sur les mêmes épisodes.
lunarlander-compareconstruit le tableau de résultats et les courbes en fonction des pas et des minutes ;lunarlander-playetscripts/make_gifs.pyenregistrent les atterrissages, les paires avant/après et la grille des méthodes qui résolvent la tâche.- 49 tests pytest, six scripts d’exemple et un notebook Kaggle/Colab qui explique chaque règle de mise à jour à partir des sources du package et relance les méthodes avec des budgets plus importants.
Comment ça marche
L’environnement
LunarLander-v3 fournit un état de 8 flottants (position, vitesse, angle, vitesse angulaire, contacts des pieds). Sa récompense est un terme de shaping fondé sur un potentiel moins le carburant, plus +100 pour l’immobilisation et -100 en cas de crash ; c’est ce shaping dense qui rend la tâche apprenable en 10^5 pas.
Méthodes de valeur avec replay
DQN régresse Q(s, a) vers r + gamma max Q_target(s') à partir d’un buffer de 50,000 transitions, avec un réseau cible copié toutes les 250 mises à jour. Double DQN laisse le réseau en ligne choisir a' et le réseau cible l’évaluer ; dueling DQN ajoute Q = V + A - mean A, le replay priorisé selon l’erreur TD avec poids d’importance, et les retours à 3 pas.
Gradient de politique et acteur-critique
REINFORCE augmente log pi(a|s) en proportion du retour restant moins un V(s) appris, sur des épisodes entiers. A2C utilise des avantages GAE issus de rollouts de 16 pas sur 8 environnements, avec un pas de gradient par rollout ; PPO collecte 16 x 1024 pas et effectue 4 époques de mises à jour par minibatch avec ratio clippé.
Acteurs à entropie maximale et déterministes
Le SAC discret somme exactement sur les 4 actions avec une température apprise. Sur l’atterrisseur continu, DDPG suit le gradient du critique dQ/da avec un bruit d’exploration gaussien, TD3 ajoute des critiques jumeaux, un lissage de la cible et un acteur retardé, et SAC utilise un acteur tanh-gaussien avec la récompense plus alpha fois l’entropie.
Suivre et comparer
Tous les 10,000 pas, la politique gloutonne joue 10 épisodes fixes ; une moyenne de 200 ou plus compte comme résolu et peut arrêter l’entraînement. Une évaluation finale sur 20 épisodes avec des graines inédites remplit le tableau, à côté des baselines aléatoire (-142.7) et contrôleur PID (265.9 / 288.2).
Exemples
Entrée
lunarlander-eval --baseline heuristic # and --baseline random
Sortie
heuristic (gymnasium's PID controller): 265.9 +- 35.4 discrete, 288.2 +- 16.9 continuous random actions: -142.7 +- 80.1
Stack technique
Réseaux, acteurs, critiques et toutes les règles de mise à jour
LunarLander-v3, discret et continu, avec SyncVectorEnv pour A2C et PPO
La physique de l’atterrisseur derrière l’environnement
Replay buffers, sum tree pour le replay priorisé, métriques
Courbes d’entraînement et d’évaluation en fonction des pas et des minutes
49 tests : buffers, GAE, log-probabilités, chaque agent apprend un bandit
Ce que j’ai appris
- La troncature à 1,000 pas doit être bootstrappée, pas traitée comme terminale : sinon un agent en vol stationnaire apprend que planer ne vaut rien, ce qui ralentit la sortie du plateau de vol stationnaire
- S’arrêter à la première évaluation sur 10 épisodes >= 200 est optimiste : dueling DQN s’est arrêté à 212 mais a obtenu 167.1 sur 20 nouveaux épisodes, d’où l’évaluation finale sur des graines inédites dans le tableau
Limites
- Une seule graine et de courts budgets CPU par méthode : le tableau montre que chaque méthode apprend, et à peu près à quelle vitesse, pas un classement
- Les méthodes off-policy continues ont tourné avec une mise à jour tous les deux pas et des réseaux 128x128 pour tenir sur un seul thread CPU, et aucune n’a résolu la tâche dans ce budget
Mots-clés
apprentissage par renforcement · LunarLander · Gymnasium · Box2D · DQN · double DQN · dueling DQN · replay d’expérience priorisé · REINFORCE · A2C · PPO · SAC · TD3 · DDPG · PyTorch