LunarLander RL
إحدى عشرة طريقة للتعلم المعزز العميق على معيار واحد
من DQN إلى SAC، كل خوارزمية في ملف واحد سهل القراءة، تُهبط المركبة نفسها تحت التقييم نفسه.
- PPO 276.4 ± 18.2
- النسخة المستمرة تُحل في 1.5 دقيقة
- DQN يتجاوز 200 عند 50k خطوة
التقنيات PyTorchGymnasiumBox2D
 NumPyMatplotlib
 pytest
نظرة عامة
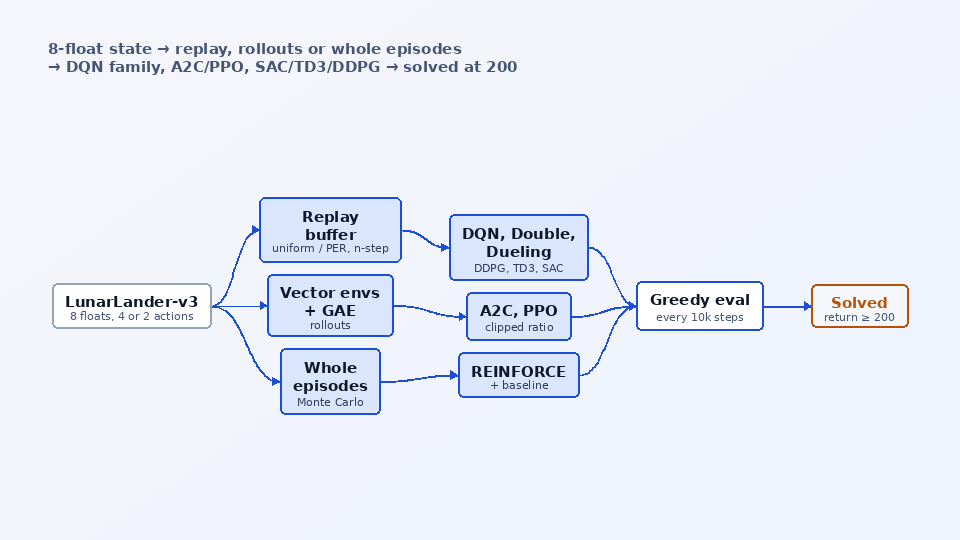
LunarLander هي الخطوة التالية بعد CartPole: حالة من 8 أعداد عشرية، ومكافأة نادرة +100 عند الاستقرار، و-100 عند التحطم، وتكلفة للوقود، وهضبة حوم يعلق فيها كثير من العملاء. استخدمتها لتنفيذ طرق التعلم المعزز العميق (Deep Reinforcement Learning) الكلاسيكية، كل طريقة في ملف، ومقارنتها بنزاهة: DQN بنسختيه double وdueling، وإعادة التشغيل ذات الأولوية، والعوائد بثلاث خطوات، وREINFORCE مع خط أساس، وA2C وPPO وSAC المتقطع على المركبة ذات الأزرار الأربعة، وDDPG وTD3 وSAC وPPO الغاوسي على النسخة المستمرة ذات المحركين.
تتراوح كل خوارزمية بين 60-120 سطرًا، مع قاعدة تحديثها مكتوبة في صورة معادلات في docstring، والشبكات شبكات MLP صغيرة، وتصف dataclass واحدة باسم Config أي تشغيل. وتتشارك جميع الطرق البيئة والبذور العشوائية، وأداة Tracker تجري تقييمًا جشعًا كل 10,000 خطوة على حلقات ثابتة لم تُرَ من قبل، ونتيجة نهائية على 20 حلقة، والمنحنيات وجدول المقارنة. ويتحقق 49 اختبارًا من المخازن وGAE ولوغاريتمات الاحتمالات، ومن أن كل عميل يتعلم مسألة bandit.
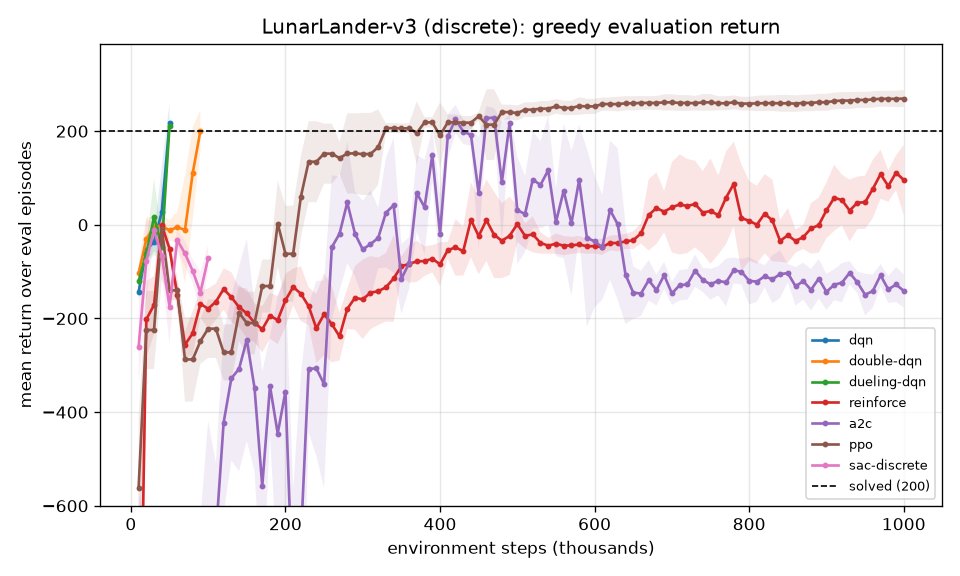
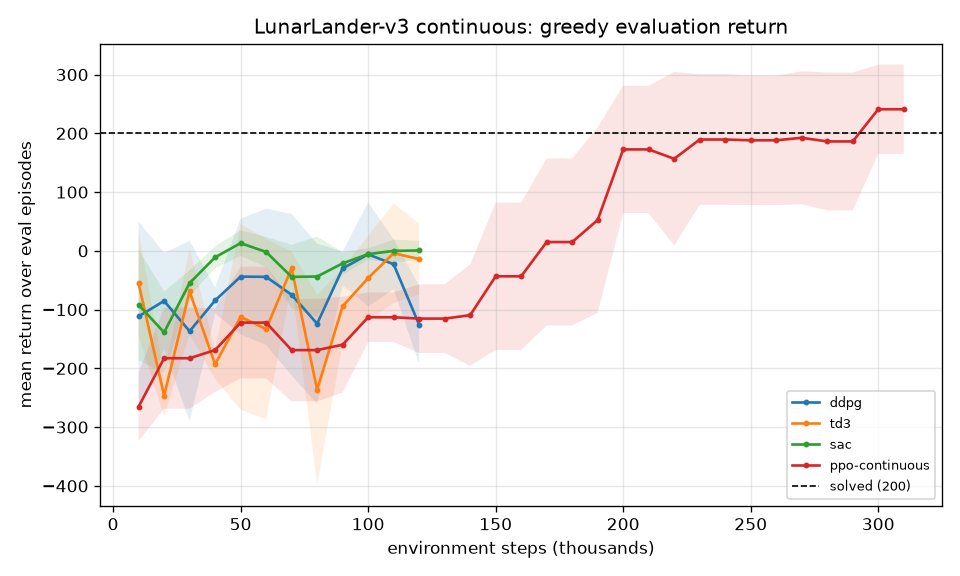
على خيط CPU واحد، يُعد PPO الأكثر موثوقية (276.4 +- 18.2 بعد الحل عند 330,000 خطوة)، وتحل نسخته الغاوسية المركبة المستمرة في 1.5 دقيقة. ويحل DQN وdueling DQN المهمة عند 50,000 خطوة، وdouble DQN عند 90,000. ويبلغ A2C عتبة 200 ثم ينهار، ويتقدم REINFORCE ببطء، أما الطرق المستمرة خارج السياسة فما زالت تحوم حين تنفد ميزانياتها البالغة 120,000 خطوة.
السؤال
أيّ خوارزميات التعلم المعزز العميق الكلاسيكية تُهبط المركبة على خيط CPU واحد في دقائق، وماذا تكشف منحنياتها عن المفاضلة بين كفاءة العينات والاستقرار؟
أهم الميزات
- إحدى عشرة طريقة خلف خيار واحد
--method: dqn وdouble-dqn وdueling-dqn (مع PER والعوائد بثلاث خطوات) وreinforce وa2c وppo وsac-discrete وddpg وtd3 وsac وppo-continuous. - dataclass واحدة باسم Config لكل المعاملات الفائقة، مع إعدادات جاهزة لكل طريقة وإمكانية التجاوز عبر
--set key=value؛ ويحفظ كل تشغيل إعداداته وأوزانه ومقاييسه. - حلقة إعادة تشغيل مشتركة للطرق خارج السياسة مع إعادة تشغيل منتظمة أو ذات أولوية (sum-tree) وعوائد بـ n خطوات، ومُجمِّع مشترك للمسارات مع GAE لـ A2C وPPO على 8-16 بيئة متجهة.
- معالجة القطع بالتمهيد في كل مكان: لا تخزّن مخازن إعادة التشغيل done إلا عند تحطم أو هبوط فعلي، وتضيف المسارات gamma V(final_obs) عند الحد الزمني البالغ 1,000 خطوة.
- بروتوكول تقييم واحد: أفعال جشعة، وتقييمات دورية على 10 حلقات ببذور ثابتة، ونتيجة نهائية على 20 حلقة ببذور أخرى، وخطّا أساس عشوائي ومتحكم PID على الحلقات نفسها.
- يبني
lunarlander-compareجدول النتائج والمنحنيات بدلالة الخطوات والدقائق؛ ويسجّلlunarlander-playوscripts/make_gifs.pyعمليات الهبوط وأزواج ما قبل التدريب وما بعده وشبكة الطرق التي حلّت المهمة. - 49 اختبارًا بـ pytest، وستة نصوص أمثلة، ودفتر Kaggle/Colab يشرح كل قاعدة تحديث انطلاقًا من مصدر الحزمة ويعيد تشغيل الطرق بميزانيات أكبر.
كيف يعمل
البيئة
تعطي LunarLander-v3 حالة من 8 أعداد عشرية (الموضع، والسرعة، والزاوية، والسرعة الزاوية، وتلامس الأرجل). ومكافأتها حدّ تشكيل قائم على الجهد (potential-based shaping) ناقص الوقود، زائد +100 عند الاستقرار و-100 عند التحطم؛ وهذا التشكيل الكثيف هو ما يجعل المهمة قابلة للتعلم في 10^5 خطوة.
طرق القيمة مع إعادة التشغيل
يُجري DQN انحدارًا لـ Q(s, a) نحو r + gamma max Q_target(s') من مخزن يضم 50,000 انتقال، مع شبكة هدف تُنسخ كل 250 تحديثًا. ويترك double DQN للشبكة الحية اختيار a' وللشبكة الهدف تقييمه؛ ويضيف dueling DQN الصيغة Q = V + A - mean A، وإعادة التشغيل ذات الأولوية حسب خطأ TD مع أوزان الأهمية، والعوائد بثلاث خطوات.
تدرج السياسة والممثل-الناقد
يرفع REINFORCE قيمة log pi(a|s) بمقدار العائد المتبقي ناقص V(s) متعلَّمة على حلقات كاملة. ويستخدم A2C مزايا GAE من مسارات بطول 16 خطوة على 8 بيئات مع خطوة تدرج واحدة لكل مسار؛ ويجمع PPO 16 x 1024 خطوة وينفّذ 4 حقب من التحديثات على دفعات صغيرة بنسبة مقصوصة.
ممثلون بأقصى إنتروبيا وممثلون حتميون
يجمع SAC المتقطع جمعًا دقيقًا على الأفعال الأربعة مع درجة حرارة متعلَّمة. وعلى المركبة المستمرة يصعد DDPG تدرج الناقد dQ/da مع ضجيج استكشاف غاوسي، ويضيف TD3 ناقدين توأمين وتنعيم الهدف وممثلًا متأخرًا، ويستخدم SAC ممثلًا من نوع tanh-Gaussian مع المكافأة زائد alpha مضروبًا في الإنتروبيا.
التتبّع والمقارنة
كل 10,000 خطوة تلعب السياسة الجشعة 10 حلقات ثابتة؛ ويُعد متوسط 200 أو أكثر حلًا ويمكن أن يوقف التدريب. ويملأ تقييم نهائي على 20 حلقة ببذور لم تُرَ من قبل الجدول، بجانب خطّي الأساس العشوائي (-142.7) ومتحكم PID (265.9 / 288.2).
أمثلة
المدخل
lunarlander-eval --baseline heuristic # and --baseline random
المخرج
heuristic (gymnasium's PID controller): 265.9 +- 35.4 discrete, 288.2 +- 16.9 continuous random actions: -142.7 +- 80.1
التقنيات المستخدمة
الشبكات والممثلون والنقاد وكل قواعد التحديث
LunarLander-v3 بنسختيه المتقطعة والمستمرة، مع SyncVectorEnv لـ A2C وPPO
فيزياء المركبة التي تقوم عليها البيئة
مخازن إعادة التشغيل، وشجرة المجاميع لإعادة التشغيل ذات الأولوية، والمقاييس
منحنيات التدريب والتقييم بدلالة الخطوات والدقائق
49 اختبارًا: المخازن، وGAE، ولوغاريتمات الاحتمالات، وتعلّم كل عميل لمسألة bandit
ما تعلمته
- يجب معالجة القطع عند 1,000 خطوة بالتمهيد (bootstrapping) لا اعتباره حالة نهائية: وإلا تعلّم العميل الذي يحوم أن الحوم لا قيمة له، مما يُبطئ الخروج من هضبة الحوم
- التوقف عند أول تقييم على 10 حلقات >= 200 تفاؤل مفرط: توقف dueling DQN عند 212 لكنه سجّل 167.1 على 20 حلقة جديدة، ولهذا يعتمد الجدول على تقييم نهائي ببذور لم تُرَ من قبل
الحدود
- بذرة واحدة وميزانيات CPU قصيرة لكل طريقة: يبيّن الجدول أن كل طريقة تتعلم وبأي سرعة تقريبًا، لا ترتيبًا بينها
- شُغّلت الطرق المستمرة خارج السياسة (off-policy) بتحديث واحد كل خطوتين وبشبكات 128x128 لتناسب خيط CPU واحدًا، ولم تحل أيٌّ منها المهمة ضمن تلك الميزانية
الكلمات المفتاحية
التعلم المعزز · LunarLander · Gymnasium · Box2D · DQN · double DQN · dueling DQN · إعادة تشغيل التجارب ذات الأولوية · REINFORCE · A2C · PPO · SAC · TD3 · DDPG · PyTorch