Pong RL
لعبة Pong من البكسلات بسبع طرق للتعلم المعزز العميق
سبع طرق للتعلم المعزز العميق تتعلم Pong من البكسلات وحدها، جنباً إلى جنب، على الإطارات نفسها وبالنتيجة نفسها.
- DQN +4.60 وفوز بنسبة 100%
- 3.6 دقيقة على خيط CPU واحد
- 34 اختبارًا
التقنيات PyTorch
 NumPyGymnasiumMatplotlib
 pytest
نظرة عامة
Pong من البكسلات هي المسألة التي جعلت التعلم المعزز العميق (Deep Reinforcement Learning) مشهوراً، وكانت مقالة Karpathy «Pong from Pixels» نقطة انطلاقي: دفتر مقرر دراسي يتضمن تدرج السياسة الذي كتبه بـ numpy وإعادة كتابة بـ PyTorch. وتحويله إلى حزمة تطلّب إصلاح إحدى عشرة مشكلة في ذلك الدفتر، أهمها دالة خسارة كانت تعطي تدرجاً صفرياً لكل فعل DOWN.
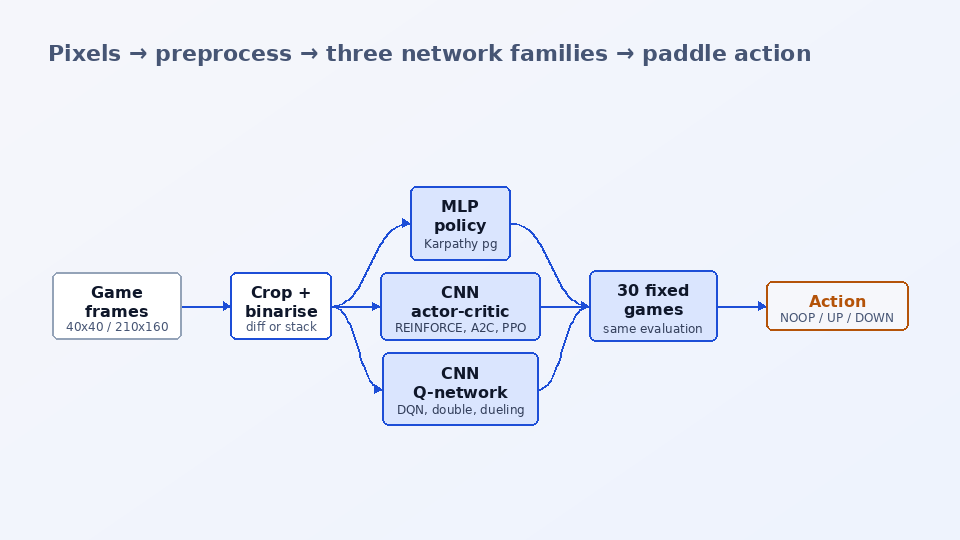
ثم بنيتُ كل طريقة رئيسية على الإطارات المعالجة مسبقاً نفسها: تدرج السياسة لـ Karpathy (MLP على فروق الإطارات)، وREINFORCE مع خط أساس متعلَّم، وA2C مع 16 مباراة متوازية، وPPO مع GAE ونسبة مقصوصة، وDQN برأسي double وdueling وإعادة التشغيل ذات الأولوية وعوائد n-step. كل قاعدة تعلم ملف واحد من 60 إلى 120 سطراً؛ أما اللعبة وشبكة CNN والتقييم والتسجيل فمشتركة.
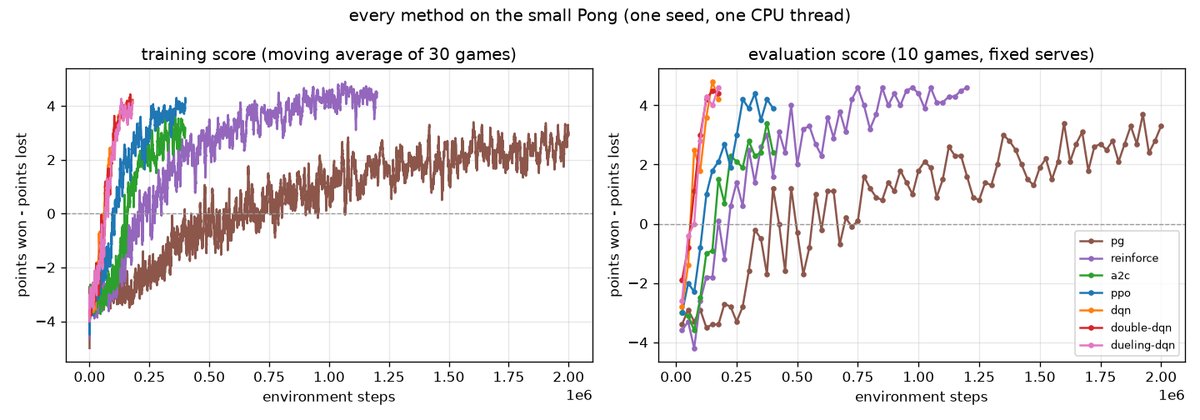
ولأن وكيل البكسلات يحتاج إلى ملايين إطارات Atari ليفوز، كتبتُ نسخة Pong بـ numpy بحجم 40x40 بالأفعال الثلاثة نفسها وتخطي الإطارات وخصم مبرمَج، تُعالج مسبقاً إلى إطارات ثنائية 20x20. تتعلمها كل طريقة في 2 إلى 6 دقائق على خيط معالج واحد، فتصبح الفروق مرئية: تهزم عائلة DQN الخصم بعد 75k-100k خطوة، وPPO بعد 125k، بينما تحتاج طرق مونت كارلو إلى 175k حتى 400k. والشيفرة نفسها تتدرب على ALE/Pong-v5 في دفتر Kaggle / Colab.
السؤال
حين ترى سبع طرق للتعلم المعزز العميق الإطارات المعالجة مسبقاً نفسها وتُقيَّم بالتقييم نفسه، إلى أي حد يغيّر خط الأساس المتعلَّم والاستيفاء الذاتي وإعادة تشغيل التجارب (experience replay) عددَ العينات اللازمة للفوز في Pong؟
أهم الميزات
- سبع طرق خلف واجهة واحدة: pg (Karpathy) وreinforce وa2c وppo وdqn وdouble-dqn وdueling-dqn، مع --per و--n-step كخيارات لعائلة DQN.
- لعبتان بواجهة واحدة: نسخة Pong الصغيرة المدمجة (إطارات ثنائية 20x20، أول من يصل إلى 5) وALE/Pong-v5 (معالجة Karpathy المسبقة 80x80، وتخطي 4 إطارات، وأفعال لاصقة، وملفات ROM مضمَّنة، ودون واجهة عرض).
- طريقتان لرؤية الحركة: --obs diff (فرق الإطارات، قناة واحدة) أو --obs stack (4 إطارات)، وتقبلهما كل الطرق.
- مُرمِّزا CNN يُختاران تلقائياً: واحد صغير يحتفظ بخريطة مكانية 4x4 على إطارات 20x20، وNature CNN للإطارات 80x80، مع تهيئة متعامدة.
- بيئة متجهة تشغّل n مباراة في عملية واحدة، وتعيد التهيئة تلقائياً، وتعيد الإطار الأخير كي يستطيع DQN الاستيفاء الذاتي عبر قطع المهلة الزمنية.
- تقييم واحد للجميع: متوسط النتيجة على 30 مباراة بإرسالات ثابتة، ونسبة الفوز، وخيار --greedy؛ ومنحنيات مقابل الخطوات ومقابل الزمن الفعلي.
- أربع واجهات سطر أوامر (pong-train و-eval و-play و-compare)، وستة أمثلة مرقَّمة، و34 اختباراً، ومجلد legacy يوثّق ما كان يفعله الدفتر الأصلي وكيف أُصلح كل خطأ.
كيف يعمل
المعالجة المسبقة للإطار
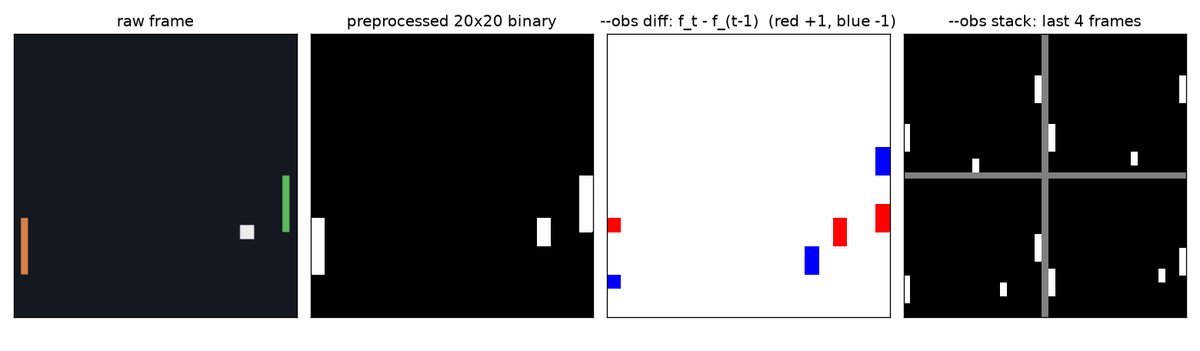
تُقص إطارات ALE وتُصغَّر بمعامل 2 وتُحوَّل إلى قيم ثنائية تماماً كما في دالة prepro لدى Karpathy (80x80). وتُصغَّر اللعبة الصغيرة من 40x40 إلى 20x20 بأخذ الحد الأقصى على كتل 2x2، كي لا تختفي الكرة ذات الحجم 2x2 أبداً.
ترميز الحركة
يُظهر إطار واحد أين الكرة لا إلى أين تتجه. يطرح diff الإطار السابق فيصبح الجسم المتحرك بقعة +1 بجوار بقعة -1؛ ويحتفظ stack بآخر 4 إطارات ويترك للشبكة مقارنتها.
التعلم بثلاث طرق
ينتظر pg وreinforce انتهاء المباريات ويستخدمان عوائد مونت كارلو (تُعاد تهيئتها عند كل نقطة)، مع V(s) متعلَّمة أو دونها. ويستوفي a2c وppo ذاتياً بعد 5 أو 64 خطوة باستخدام ناقد، مع إعادة PPO استخدام كل دفعة لـ 4 حقب بقص للنسبة عند 10%. وتنحدر عائلة DQN بقيمة Q نحو شبكة هدف من مخزن إعادة تشغيل بخسارة Huber وتصرّف epsilon-greedy.
التقييم على إرسالات ثابتة
تُعاد تهيئة النسخة i من اللعبة بالبذرة 10000 + i، فتواجه كل طريقة الإرسالات نفسها وضجيج الخصم نفسه؛ يأخذ وكلاء تدرج السياسة عينات من أفعالهم، وتلعب عائلة DQN بـ argmax Q.
المقارنة
يدرّب scripts/compare_all.py الطرق السبع واحدة تلو الأخرى، ويبني جدول النتائج والمنحنيات مقابل الخطوات والدقائق وصورة GIF بلوح لكل طريقة.
أمثلة
المدخل
pong-train --algo dqn && pong-eval runs/dqn/model.pt --episodes 30
المخرج
mean score +4.60 ± 0.55 over 30 games, win rate 100% (180,000 steps, 3.6 min on one CPU thread)
التقنيات المستخدمة
شبكة MLP الخاصة بـ Karpathy، والممثل-الناقد بـ CNN، وشبكات Q، وقواعد التعلم السبع
نسخة Pong المدمجة 40x40، والمعالجة المسبقة، وخصم العوائد، وإعادة التشغيل بشجرة المجاميع
ALE/Pong-v5 عبر ale-py، بواجهة الأفعال الثلاثة نفسها التي في اللعبة الصغيرة
منحنيات التعلم مقابل الخطوات والزمن الفعلي، ورسوم المعالجة المسبقة
34 اختباراً: متطابقات التدرج، وقص PPO، وهدف double DQN، ومسألة bandit بكسلية يجب أن تتعلمها كل طريقة، وواجهات سطر الأوامر
ما تعلمته
- التهيئة هي التي حسمت ما إذا كان أي شيء سيُتعلَّم: مع التهيئة الافتراضية في PyTorch على إطارات ثنائية متفرقة، لم يتلقَّ رأس السياسة في PPO أي تدرج تقريباً طوال 150k خطوة؛ وأصلحت التهيئة المتعامدة ذلك
- أعطى أفق أقصر (gamma من 0.99 إلى 0.97) عوائد أقل تبايناً في اللعبة الصغيرة، حيث تُحسم النقطة بعد 10 إلى 20 قراراً من الحركة المؤثرة
- كانت دالة الخسارة في دفتر المقرر الأصلي تعطي تدرجاً صفرياً لكل فعل DOWN؛ والاحتمال اللوغاريتمي الكامل لبرنولي يصلح ذلك، واختبار يتحقق من أنه يساوي تدرج A (y - p) لدى Karpathy
الحدود
- كل النتائج من نسخة Pong الصغيرة المدمجة، ببذرة واحدة لكل طريقة؛ ولا يأتي أي رقم لـ ALE Pong في المستودع من وكيل مدرَّب (تشغيلات ALE الحقيقية موجودة في الدفتر بميزانيات تقديرية فقط)
- يقع double DQN وdueling DQN مع إعادة التشغيل ذات الأولوية وعوائد 3 خطوات ضمن هامش الضجيج من DQN البسيط هنا: فاللعبة الصغيرة لا تُظهر إلا قليلاً من المبالغة في التقدير بحيث لا تُحدث هذه التحسينات فرقاً
الكلمات المفتاحية
التعلم المعزز · Pong من البكسلات · Atari · تدرج السياسة · REINFORCE · A2C · PPO · DQN · dueling DQN · إعادة تشغيل التجارب ذات الأولوية · عوائد n-step · تكديس الإطارات · Arcade Learning Environment · Gymnasium · PyTorch