Speech Emotion Recognition
ثمانية مصنِّفات صوتية مختبرة على متحدثين غير مسموعين
اكتشاف المشاعر في الصوت، ومعرفة أي طريقة لتقديم الصوت إلى النموذج تصمد أمام متحدث لم يسمعه من قبل.
- دقة 82.5% (WavLM)
- ثلاثة أضعاف المسار الأصلي
التقنيات PyTorch
 Hugging Face Transformerslibrosa
 scikit-learn
 NumPyMatplotlib
نظرة عامة
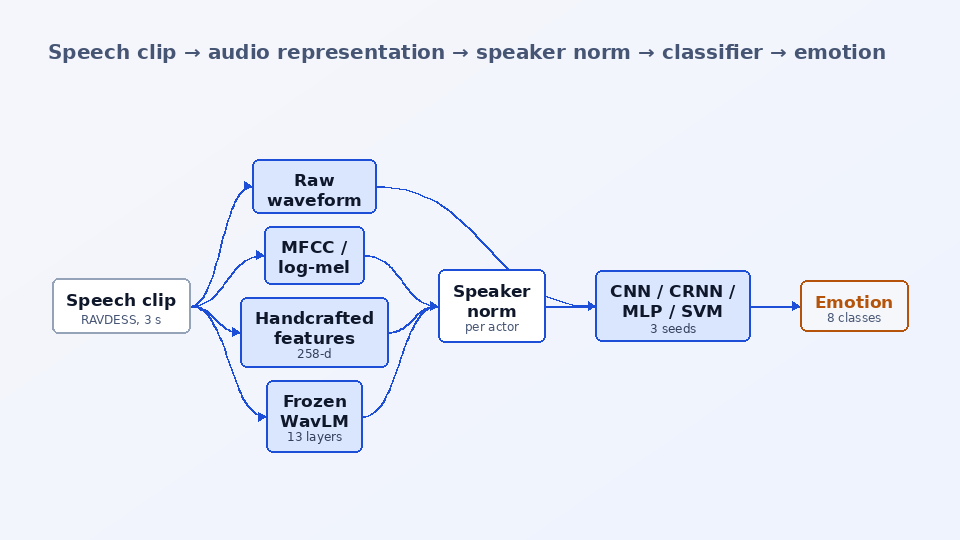
تكمن المشاعر في الكلام في طريقة قول الجملة لا في مضمونها. ومجموعة RAVDESS تجعل ذلك صريحاً: 24 ممثلاً ينطقون الجملة نفسها بـ 8 مشاعر. أردت أن أعرف أي طريقة لتقديم الصوت إلى النموذج تعمل بشكل أفضل، فدرّبت نموذجاً لكل تمثيل على البيانات نفسها والتقسيم نفسه: شبكة CNN أحادية البعد على الموجة الخام، وCNN أحادية البعد على متتاليات MFCC، وCNN ثنائية البعد ونموذج CNN + BiGRU + انتباه على مخططات log-mel الطيفية، وMLP وSVM على 258 سمة مصممة يدوياً، وWavLM مجمَّداً مع رأس صغير، والشبكة الأمامية (feed-forward) من دفتر Colab الأصلي محفوظة كخط أساس.
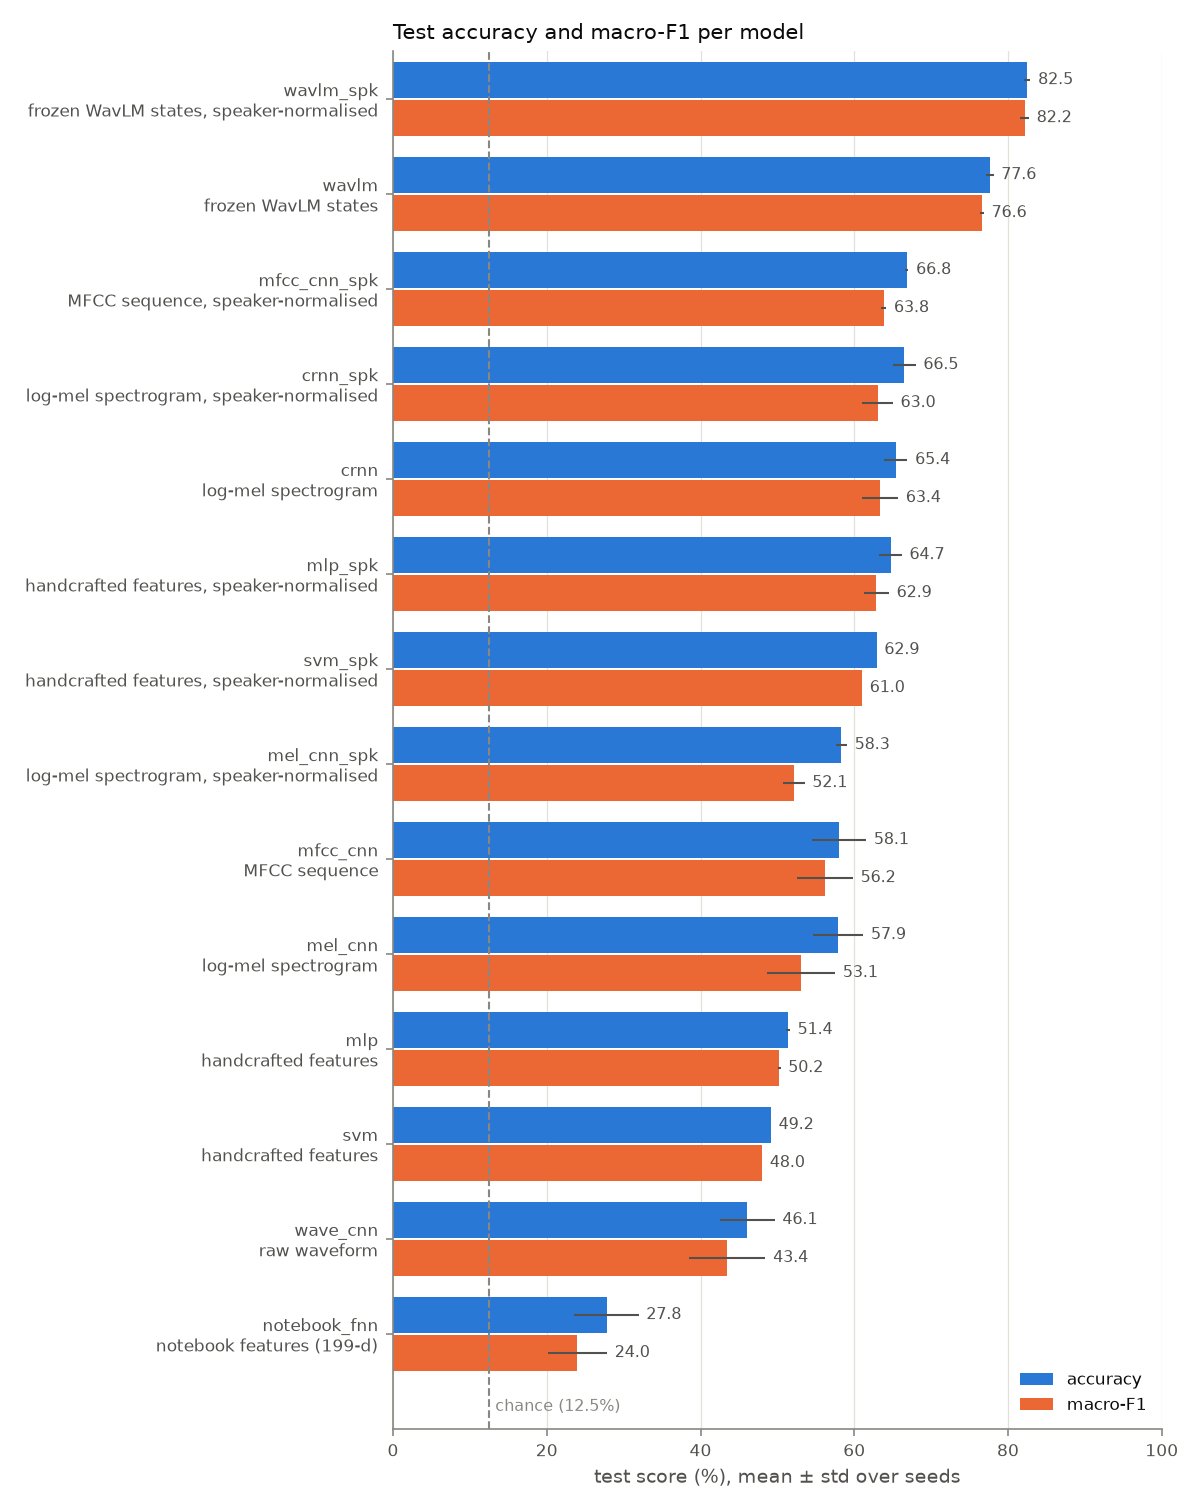
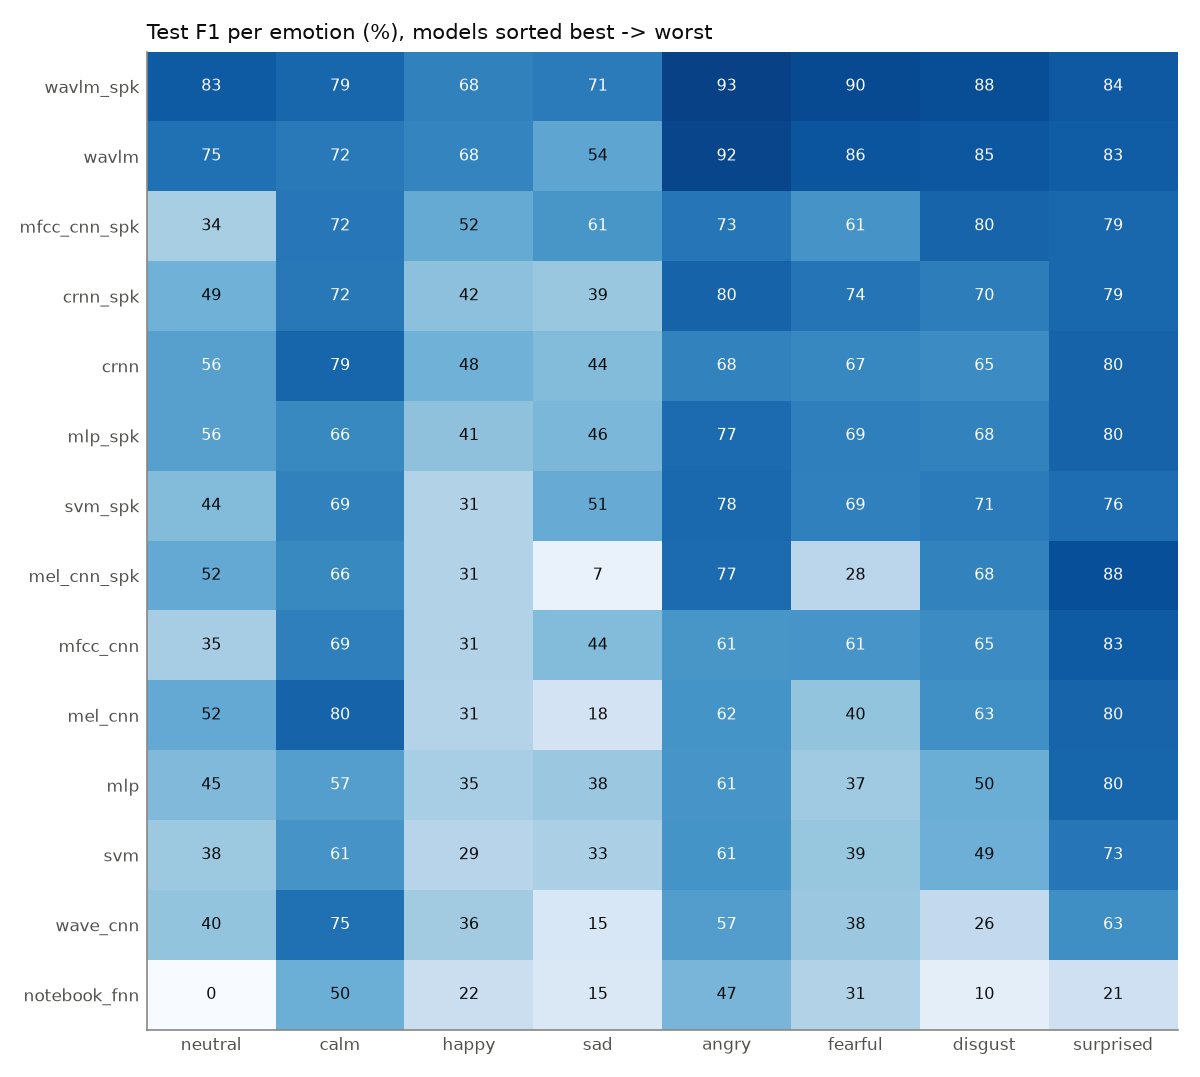
يجري التقسيم حسب الممثل: 18 للتدريب و2 للتحقق و4 للاختبار، فلا يُسمع أي صوت اختبار أثناء التدريب. وهذا أصعب من التقسيمات العشوائية التي تقف وراء كثير من أرقام RAVDESS المنشورة. يُشغَّل كل نموذج على 3 بذور. يتفوق WavLM المجمَّد بفارق كبير بدقة اختبار 77.6%؛ ويبلغ CRNN 65.4%، وشبكتا CNN على المخطط الطيفي وMFCC نحو 58%، وMLP 51.4%، وSVM 49.2%، وCNN على الموجة الخام 46.1%، وخط معالجة الدفتر 27.8%.
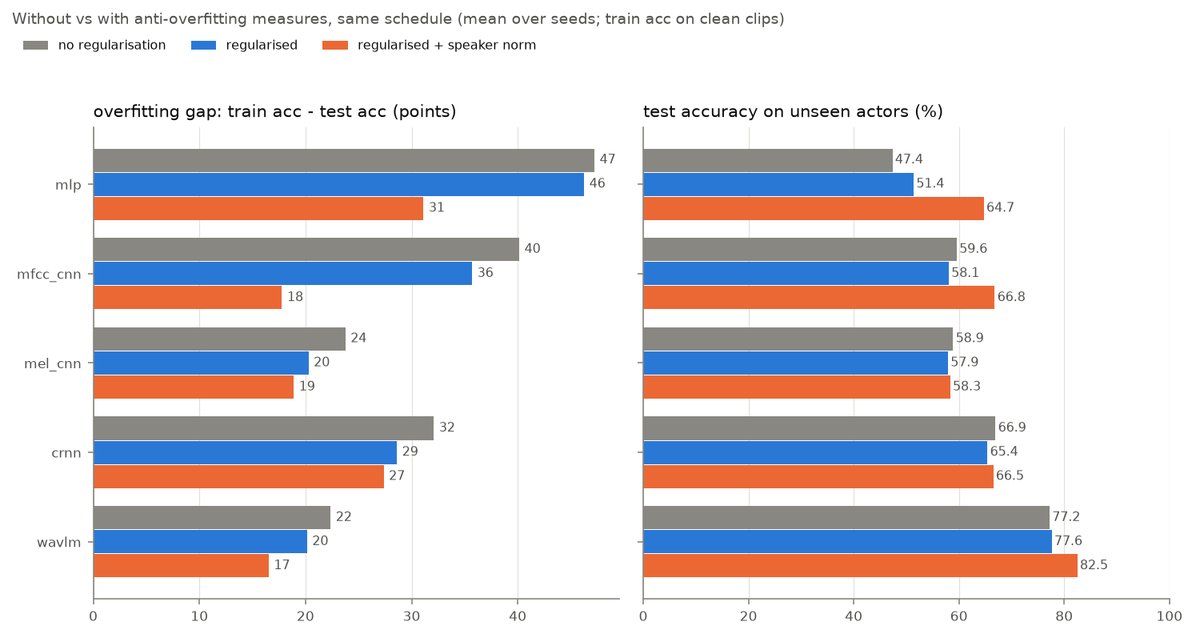
كانت النسخة الأولى تسجل دقة التدريب على مقاطع معزَّزة (augmented)، ما أخفى حجم الحفظ. وعند القياس بصدق، يبلغ كل نموذج 78 إلى 100% على مجموعة تدريبه ويخسر 22 إلى 47 نقطة على المتحدثين الجدد. أما اضمحلال الأوزان (weight decay) وmixup واضطراب السرعة ومتوسط الأوزان فلا تضيّق هذه الفجوة إلا ببضع نقاط. ما ينجح فعلاً هو توحيد كل سمة لكل متحدث: يرفع MLP بـ 17 نقطة، وCNN على MFCC بـ 7، وWavLM بـ 5 ليصل إلى 82.5%. ويتضمن المستودع أيضاً ثمانية مقاطع اختبار، واحداً لكل شعور، كل منها مصيَّر كفيديو قصير مع المخطط الطيفي ومؤشر تشغيل واحتمالات النموذج؛ يصيب WavLM في 6 من 8، إذ يسمع المحايد هادئاً والسعيد متفاجئاً.
السؤال
أي تمثيل صوتي يعمل بأفضل شكل للتعرف على المشاعر حين يكون متحدثو الاختبار جدداً، ولماذا تفرط النماذج المدرَّبة من الصفر إلى هذا الحد في التخصص على الأصوات التي سمعتها؟
أهم الميزات
- ثمانية مصنِّفات على خط بيانات واحد: CNN على الموجة الخام، وCNN على MFCC، وCNN على log-mel، وCRNN مع تجميع بالانتباه، وMLP، وSVM بنواة RBF، وWavLM base+ مجمَّد مع مجموع موزون متعلَّم لطبقاته الـ 13، وشبكة الدفتر الأصلي كخط أساس أمين.
- بروتوكول مستقل عن المتحدث: تقسيم حسب الممثل (1,080 / 120 / 240 مقطعاً)، وصوت بتردد 16 kHz مع حذف الصمت وقصه أو حشوه إلى 3 ثوانٍ، مع عرض الدقة وmacro-F1 كمتوسط ± انحراف معياري على 3 بذور.
- قياس صادق للإفراط في التخصيص: دقة التدريب على 240 مقطعاً نظيفاً في وضع التقييم في كل حقبة، مع خيار --baseline يعطّل كل إجراءات مكافحة الإفراط في التخصيص لجدول قبل/بعد.
- تنظيم خاص بكل نموذج: اضمحلال أوزان AdamW بقيمة 0.05، وdropout على المدخلات، وmixup، وضجيج غاوسي على السمات، واضطراب السرعة وطبقة الصوت، وSpecAugment، ومتوسط الأوزان EMA، ولا يُبقى على أي منها إلا إذا ساعد على مجموعة التحقق.
- تطبيع لكل متحدث لكل عائلة سمات، بما في ذلك واجهة log-mel الأمامية لشبكات CNN، مع predict.py --speaker-ref الذي يأخذ بضعة مقاطع غير موسومة لمتحدث جديد.
- ملف compare.py قابل للاستئناف يشغّل كل نموذج وكل بذرة، ثم يعيد report.py بناء جدول النتائج ومنحنيات التدريب ومصفوفات الالتباس وF1 لكل شعور ورسم الإفراط في التخصيص من سجلات JSON.
- ستة نصوص أمثلة، من أسرع نتيجة حقيقية (SVM في 3 ثوانٍ) إلى تصنيف المقاطع النموذجية وتصييرها كفيديوهات مع الصوت.
كيف يعمل
التحميل والتقسيم حسب الممثل
ينزّل prepare_ravdess.py مقاطع الكلام الـ 1,440 ويضع الممثلين 1-18 في التدريب و19-20 في التحقق و21-24 في الاختبار؛ وتُستخرج التسميات ومعرّفات المتحدثين من أسماء الملفات.
تحويل الصوت إلى كل تمثيل
يُعاد أخذ عينات المقاطع إلى 16 kHz، ويُحذف الصمت وتُثبَّت المدة على 3 ثوانٍ، ثم تصبح موجة من 48,000 عينة، أو متتالية MFCC بحجم 40 × 151، أو مخططاً طيفياً log-mel بحجم 64 × 151، أو 258 سمة يدوية مجمَّعة، أو الحالات المخفية لـ WavLM مجمَّد، وتُخزَّن مؤقتاً بعد التشغيل الأول.
تدريب نموذج لكل تمثيل
يستخدم كل نموذج عصبي AdamW مع جدول one-cycle وتنعيم التسميات (label smoothing) بقيمة 0.1 ودفعات من 32؛ وتُطبَّق تعزيزاته وأدوات تنظيمه الخاصة، وتُحفظ نقطة الحفظ ذات أفضل macro-F1 على التحقق.
التطبيع لكل متحدث
توحّد متغيرات _spk كل سمة بمتوسط المتحدث نفسه وتباينه بدلاً من متوسط مجموعة التدريب وتباينها، ما يزيل معظم ما يميز صوتاً عن آخر.
التقرير على ممثلين غير مسموعين
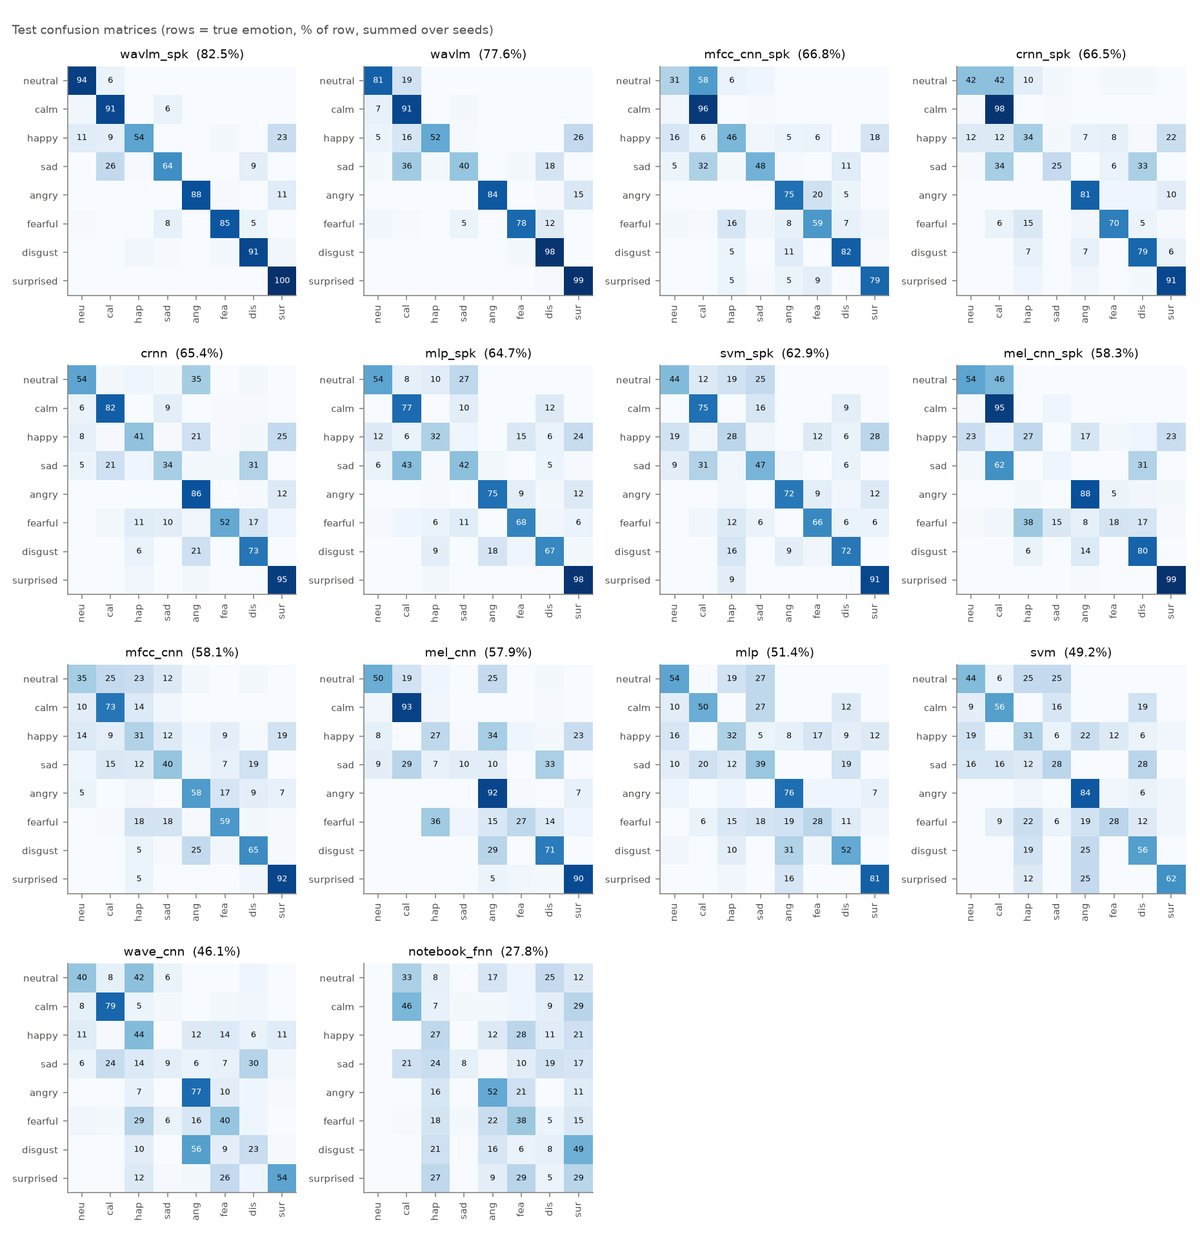
يكتب كل تشغيل ملف JSON بسجله ومقاييس الاختبار؛ ويجمّع report.py البذور في جدول النتائج ومصفوفات الالتباس وF1 لكل فئة ورسم فجوة التدريب-الاختبار.
أمثلة
المدخل
python predict.py samples/05_angry_actor21.wav --model wavlm
المخرج
angry 76% (true: angry)
التقنيات المستخدمة
النماذج العصبية السبعة، والواجهات الأمامية، والتعزيزات، وحلقة التدريب
العمود الفقري WavLM base+ المجمَّد (يمكن استبداله بأي نقطة حفظ لـ wav2vec2 / HuBERT / WavLM)
إعادة أخذ العينات، وحذف الصمت، وسمات MFCC وchroma وmel وcontrast وtonnetz
خط أساس SVM بنواة RBF ومقاييس التصنيف
تجميع السمات، والتوحيد لكل متحدث، والتخزين المؤقت
رسوم النتائج: أعمدة الدقة، والمنحنيات، ومصفوفات الالتباس، وF1 لكل فئة
ما تعلمته
- تفرط النماذج في التخصص على هوية المتحدث لا على المقاطع فحسب: التنظيم التقليدي لا يغيّر دقة الاختبار أكثر من ضجيج البذرة، بينما يسد تطبيع السمات لكل متحدث جزءاً كبيراً من الفجوة
- كثير من نتائج RAVDESS المنشورة تستخدم تقسيمات عشوائية يظهر فيها الممثلون أنفسهم في التدريب والاختبار، فلا تصلح للمقارنة مع اختبار مستقل عن المتحدث
الحدود
- تحتاج المتغيرات المطبَّعة لكل متحدث إلى بضعة مقاطع غير موسومة لكل متحدث اختبار، فهي تتبع بروتوكولاً مختلفاً قليلاً عن الصفوف التي لا تستخدم شيئاً من متحدثي الاختبار
- مع 18 صوتاً للتدريب تبقى فجوة بين التدريب والاختبار لكل نموذج؛ والخطوة التالية مجموعة أكبر مثل CREMA-D أو MSP-Podcast
الكلمات المفتاحية
التعرف على المشاعر في الكلام · تصنيف الصوت · RAVDESS · WavLM · wav2vec2 · الكلام ذاتي الإشراف · المخطط الطيفي mel · MFCC · CRNN · CNN على الموجة الخام · SVM · التطبيع لكل متحدث · تقييم مستقل عن المتحدث · الإفراط في التخصيص · PyTorch